Der findes i dag flere pakker, som muliggør hurtig udforskning af data. Pakken DataExplorer er udviklet til at producere færdige rapporter eller dele af rapporter. Der findes flere lignende pakker, men DataExplorer er veldokumenteret og omfatter de vigtigste metoder. Start med at installere og aktivere pakken:
install.packages("DataExplorer")
library(DataExplorer)
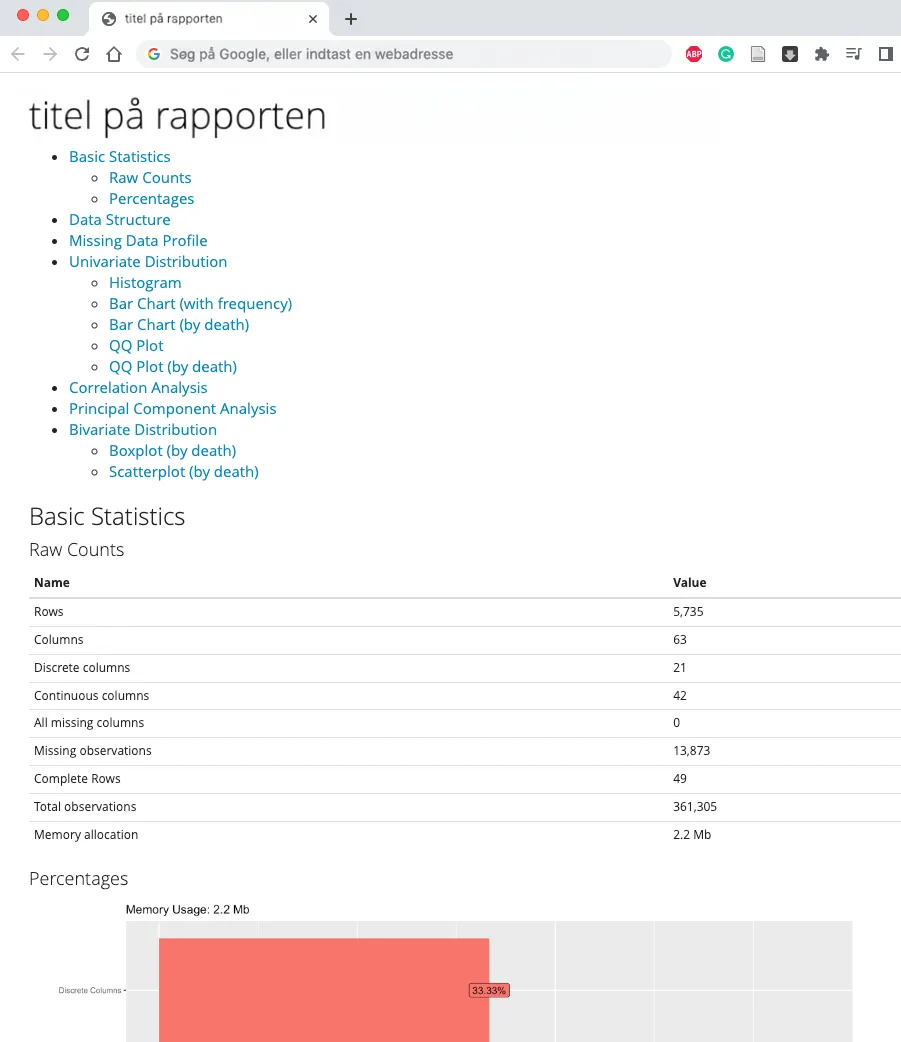
DataExplorer kan oprette en formateret rapport, som gemmes som en PDF-fil på harddisken. Til dette bruges funktionen create_report(), som har argumenterne output_file (navnet på filen, der gemmes på harddisken), report_title (rapportens titel) og det valgfrie argument y. Argumentet y angives kun, hvis beskrivelserne skal stratificeres efter en variabel. I nedenstående kode stratificeres rapporten efter kolonnen death, som angiver, om patienten døde under studiet.
rhc %>%
  create_report(
    output_file="rapportfilens namn",
    report_title= "titel på rapporten",
    y="death"
  )
Derefter vil filen (i HTML-format) ligge i din working directory. Hvis du ikke ved, hvor din working directory er, skriver du kommandoen getwd(), som returnerer din working directory (sandsynligvis er det den samme mappe, som dit R-script ligger i). Begyndelsen af filen ser således ud:
Vi fortsætter med at demonstrere, hvordan enkelte komponenter i rapporten kan produceres for at udforske data.
Start med en overordnet beskrivelse af data:
introduce(rhc)| rows | columns | discrete_columns | continuous_columns | all_missing_columns | total_missing_values | complete_rows |
|---|---|---|---|---|---|---|
| 5735 | 63 | 21 | 42 | 0 | 13873 | 49 |
plot_intro(rhc)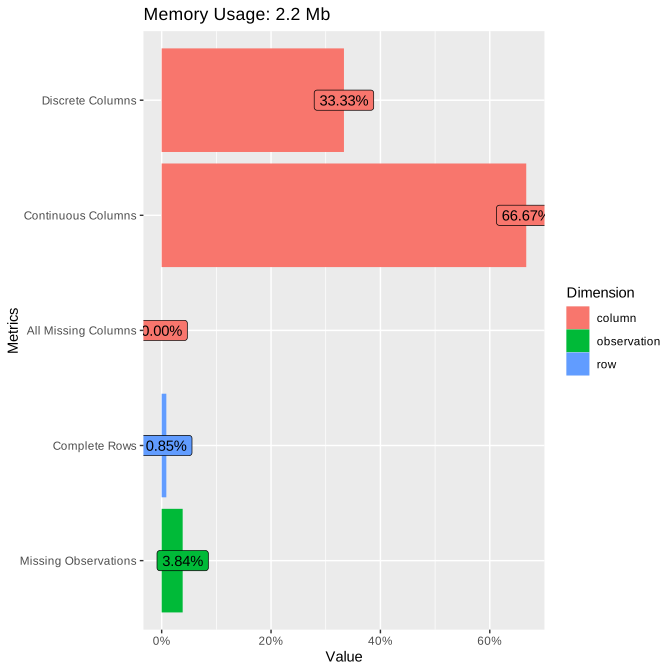
plot_missing(rhc)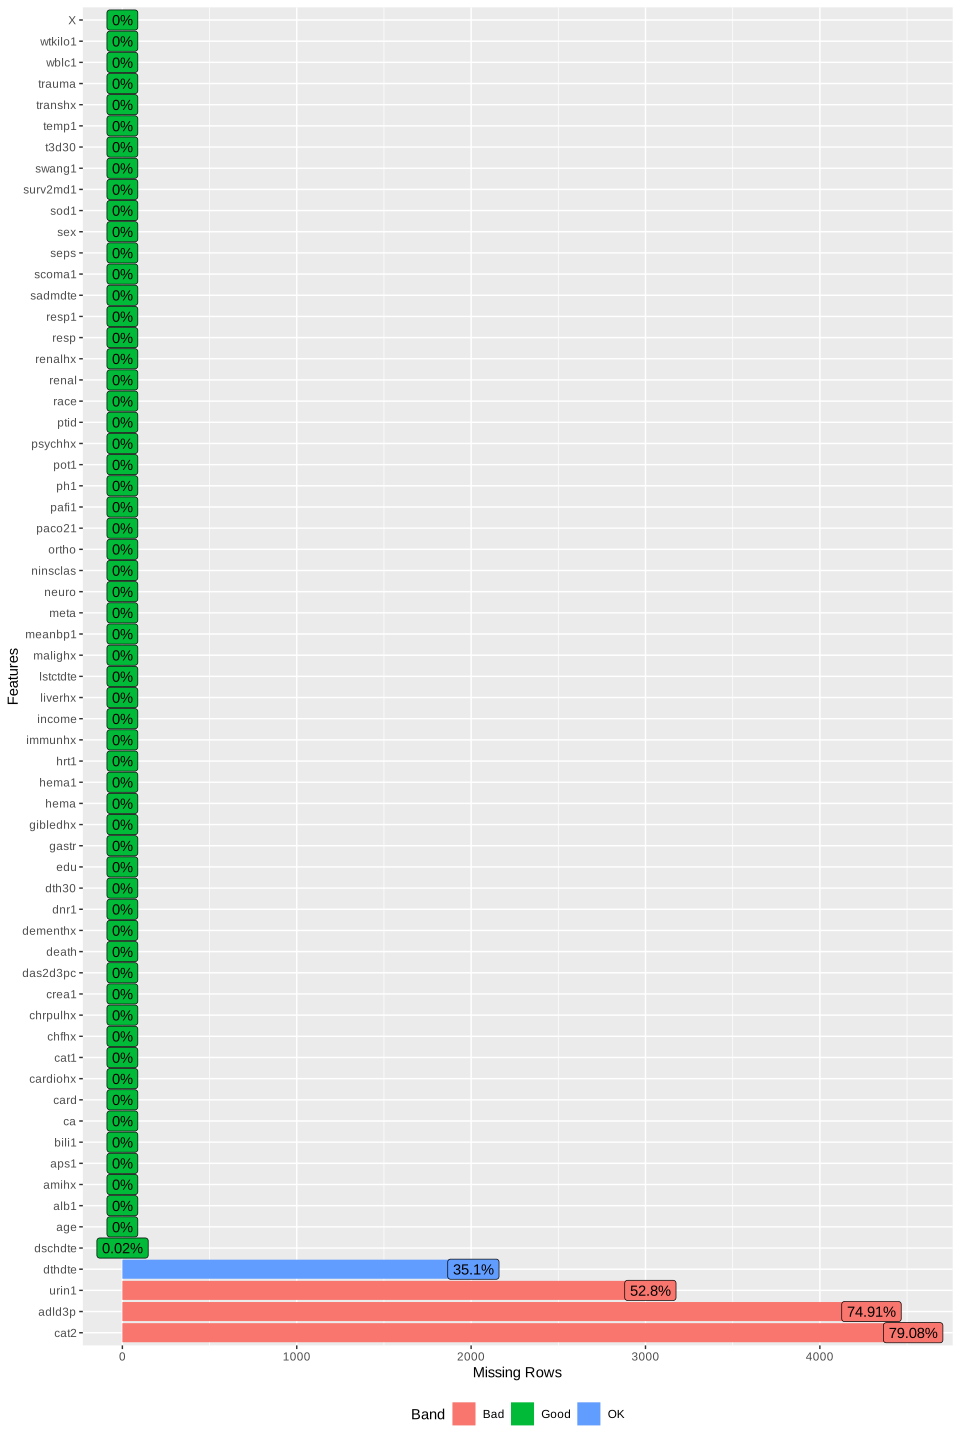
## Frekvenser stratificeret efter en variabel
plot_bar(rhc, by = "death", nrow=20, ncol=4)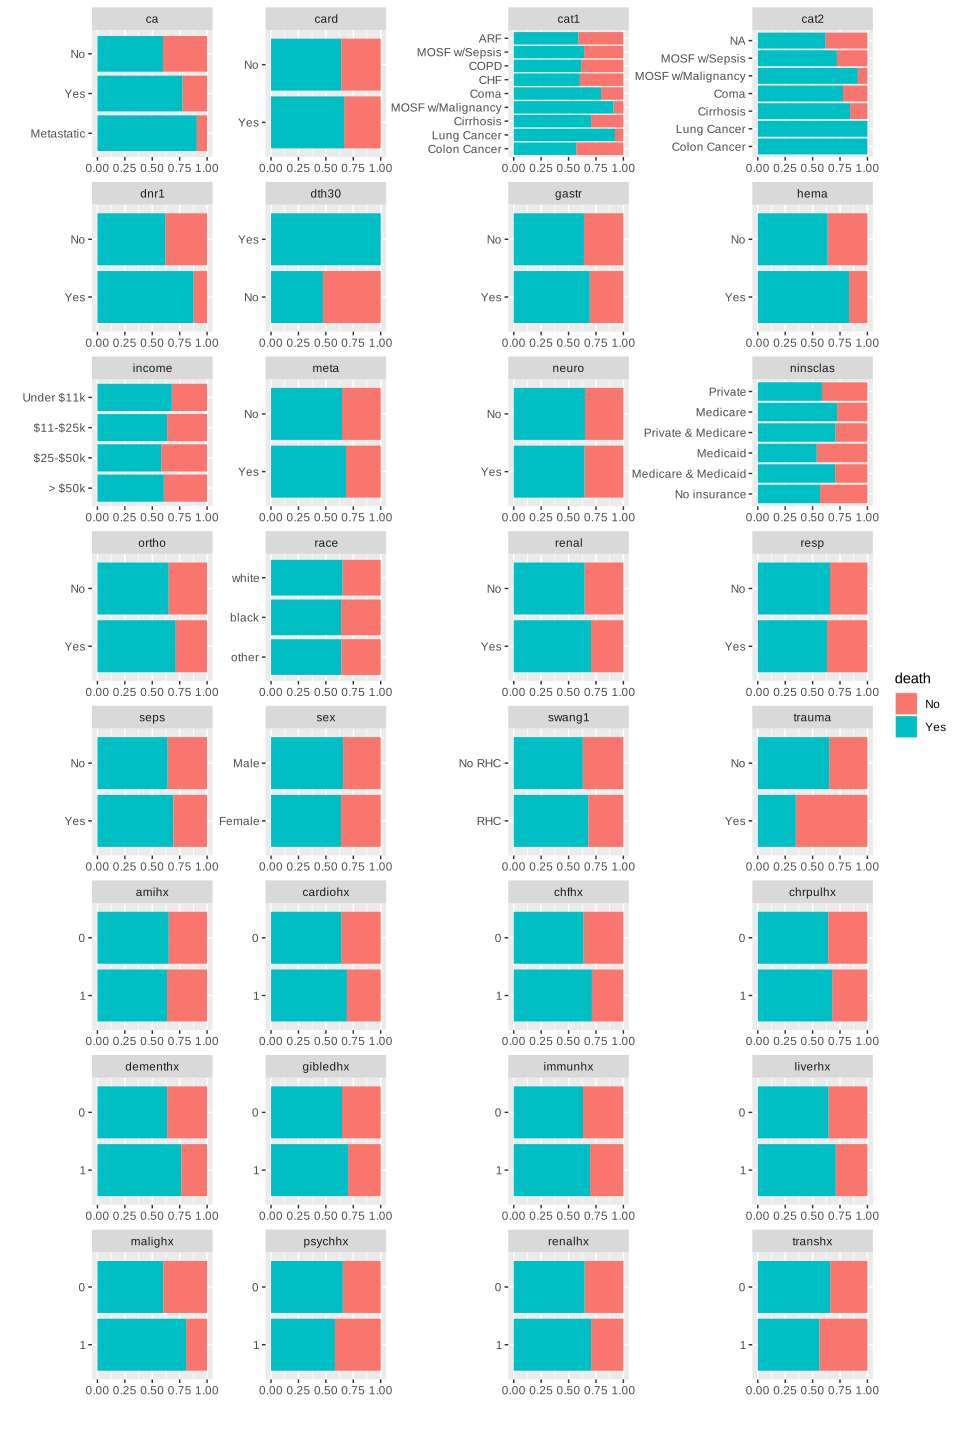
## Se histogrammer for alle kontinuerte variabler
plot_histogram(rhc)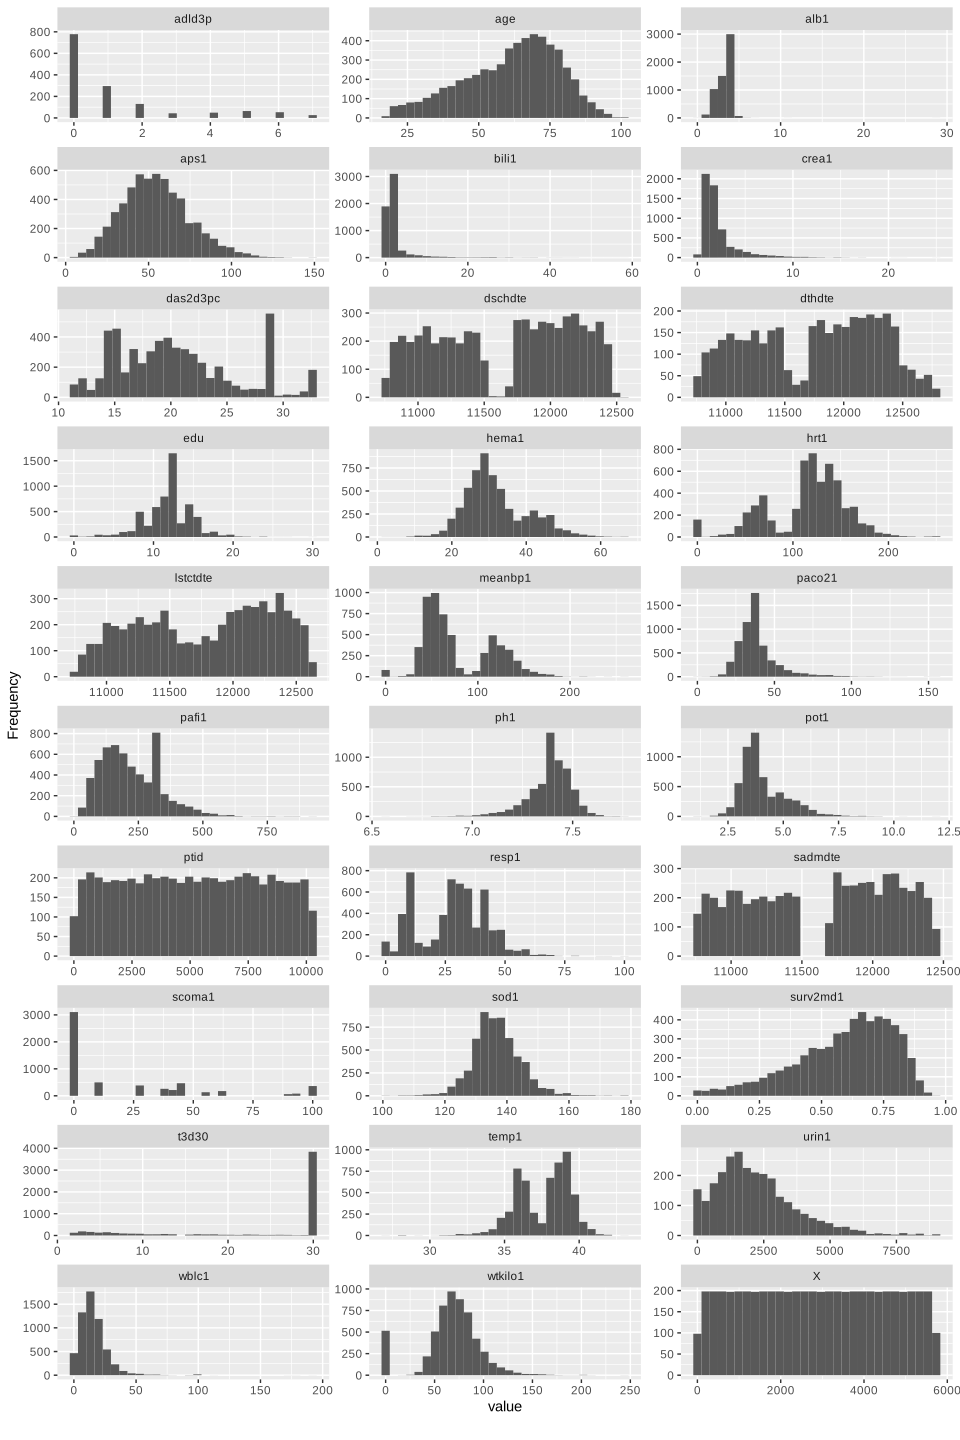
## Tæthedskurver for alle kontinuerte variabler
plot_density(rhc, ncol=3, nrow=10)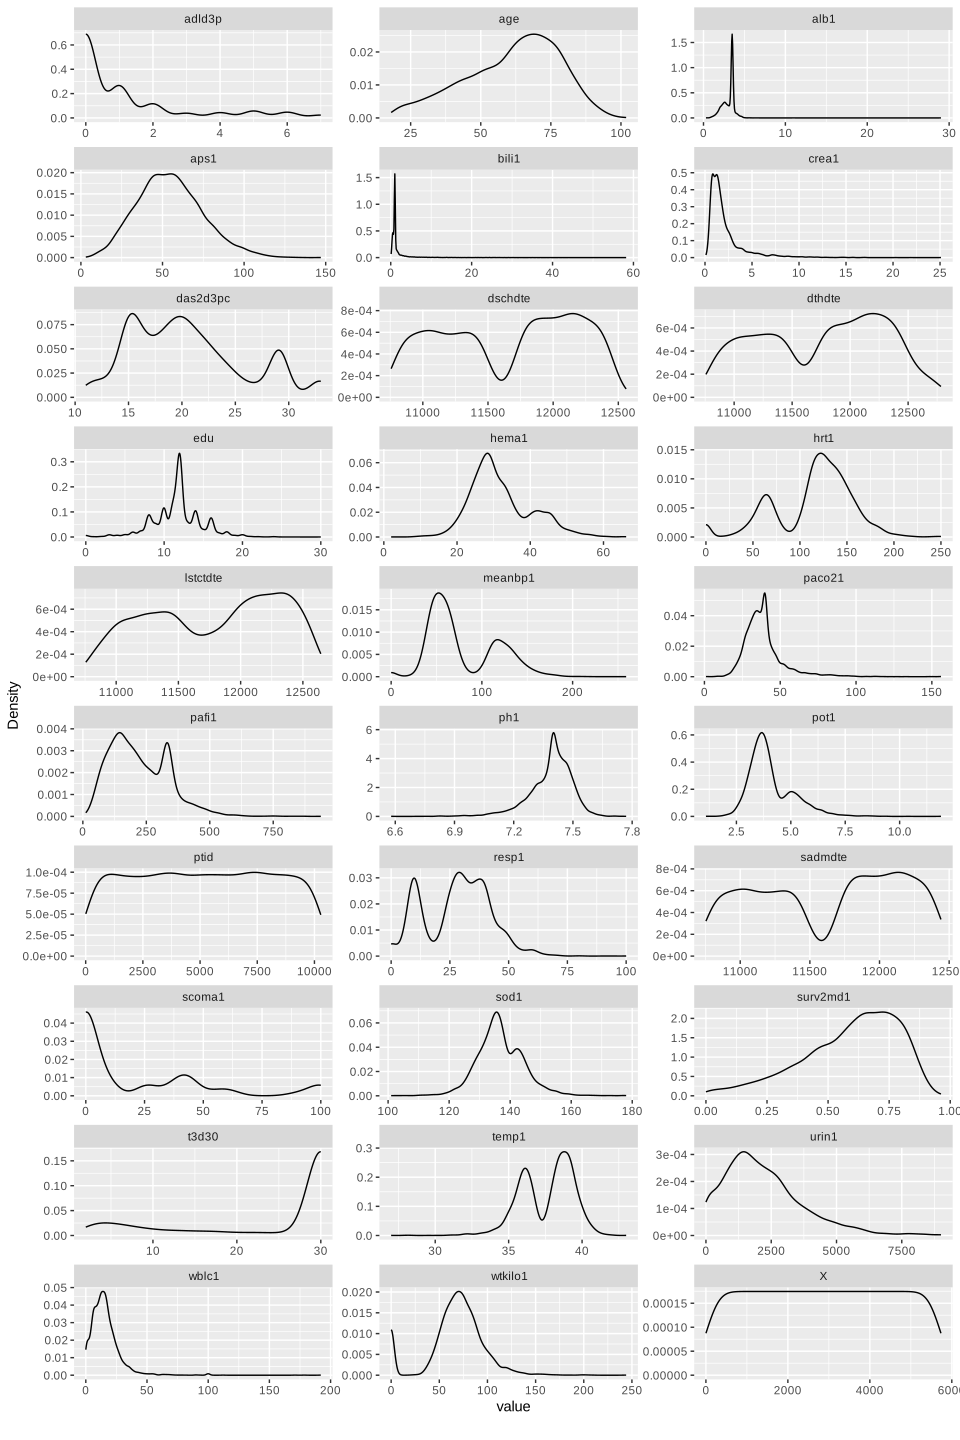
## QQ-plot for alle kontinuerte variabler
plot_qq(rhc, ncol=3, nrow=10)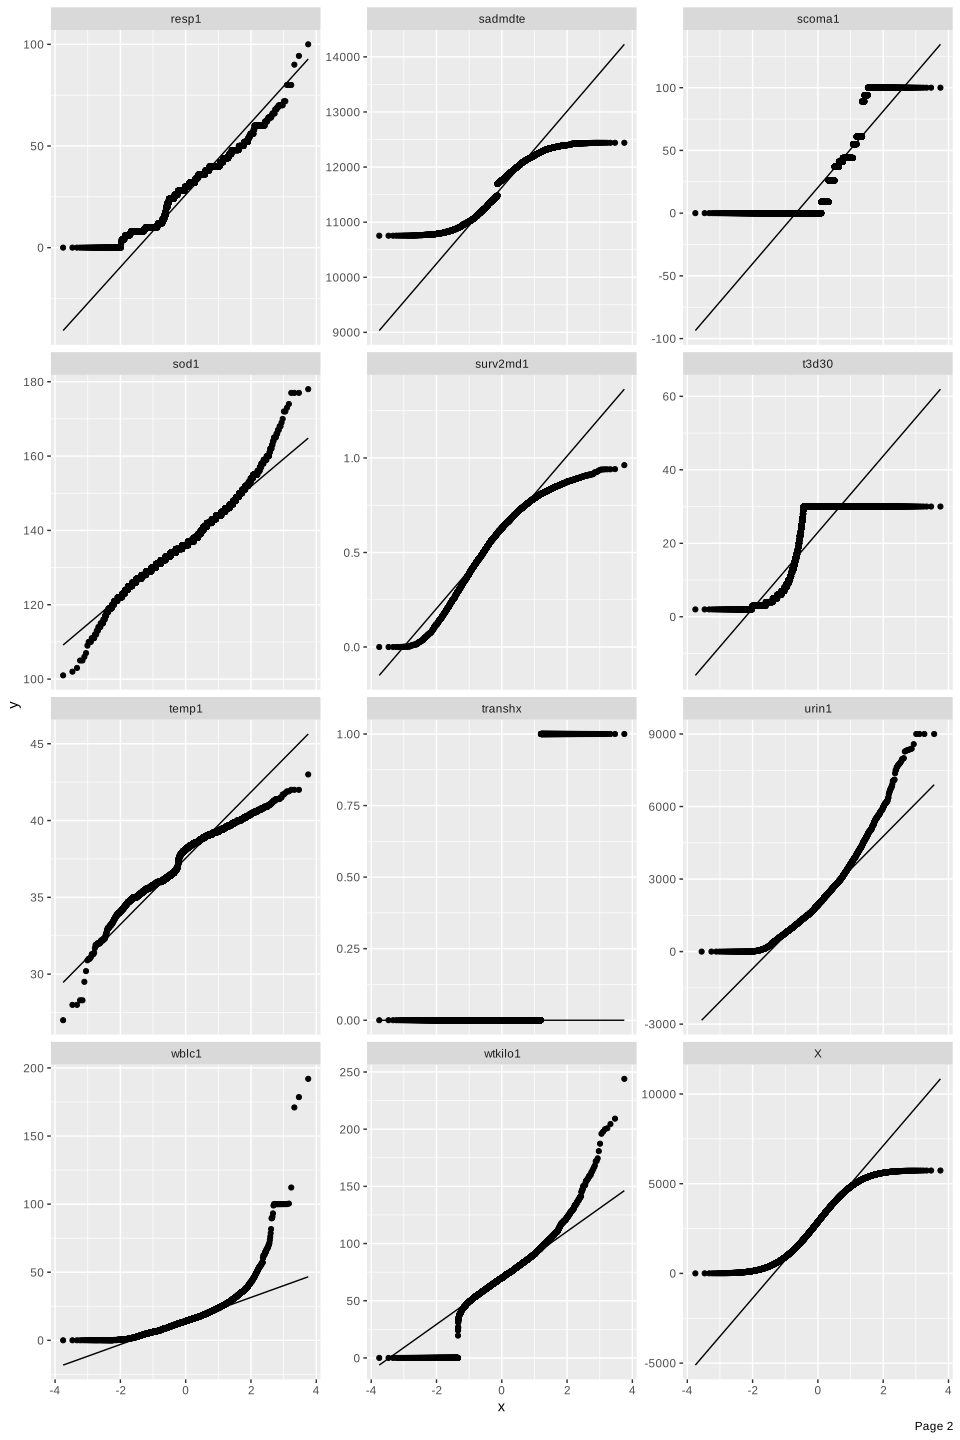
## QQ-plot stratificeret efter en kolonne
plot_qq(rhc, by = "death", ncol=3, nrow=10)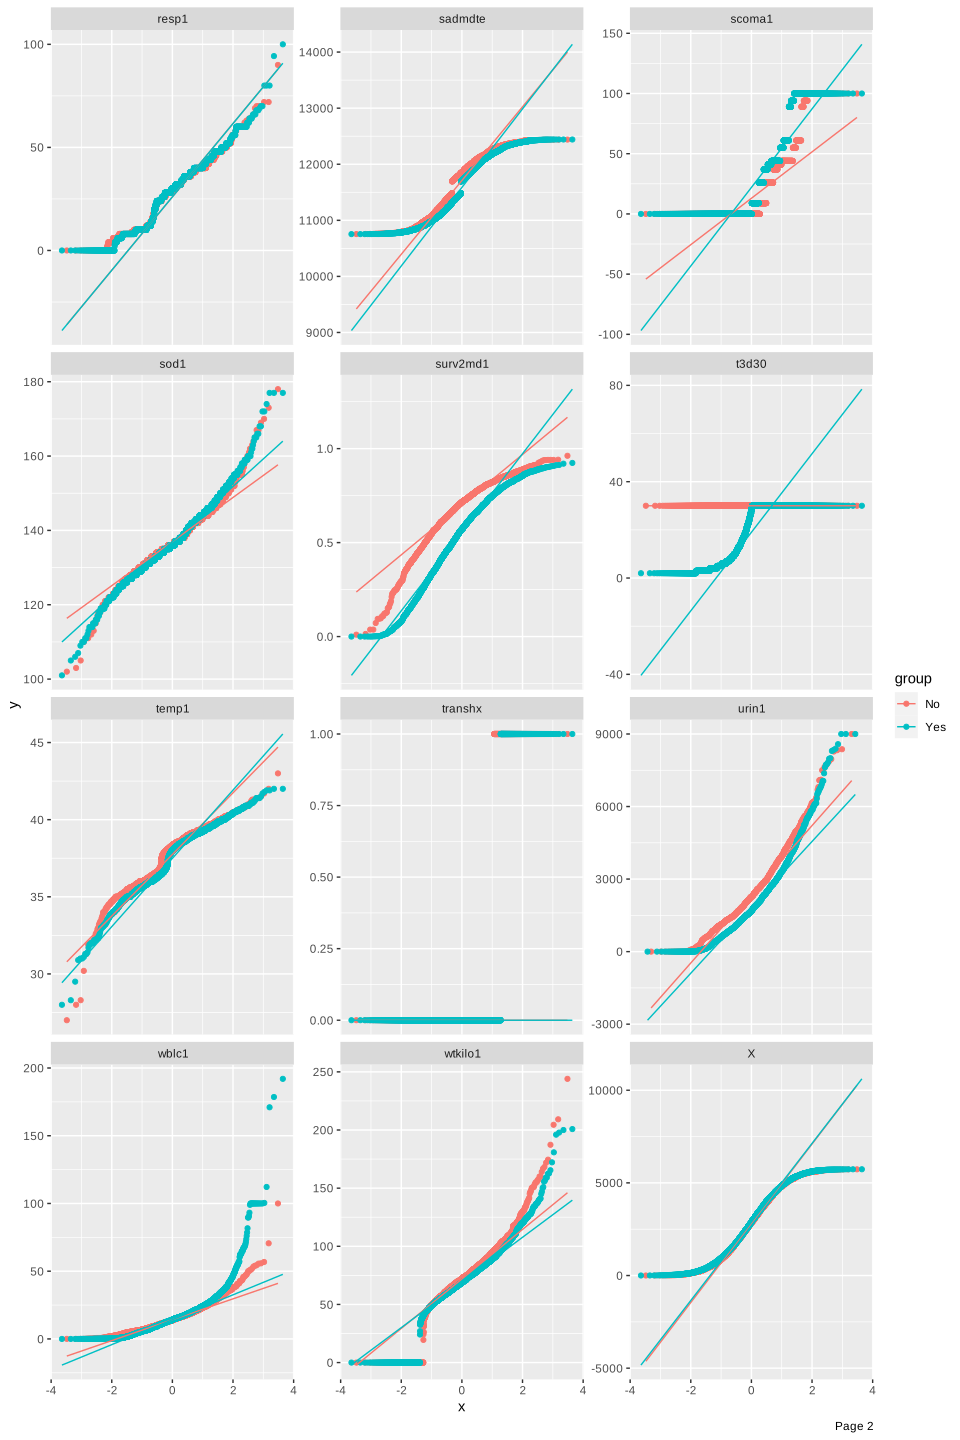
## Korrelationsmatricer
plot_correlation(rhc)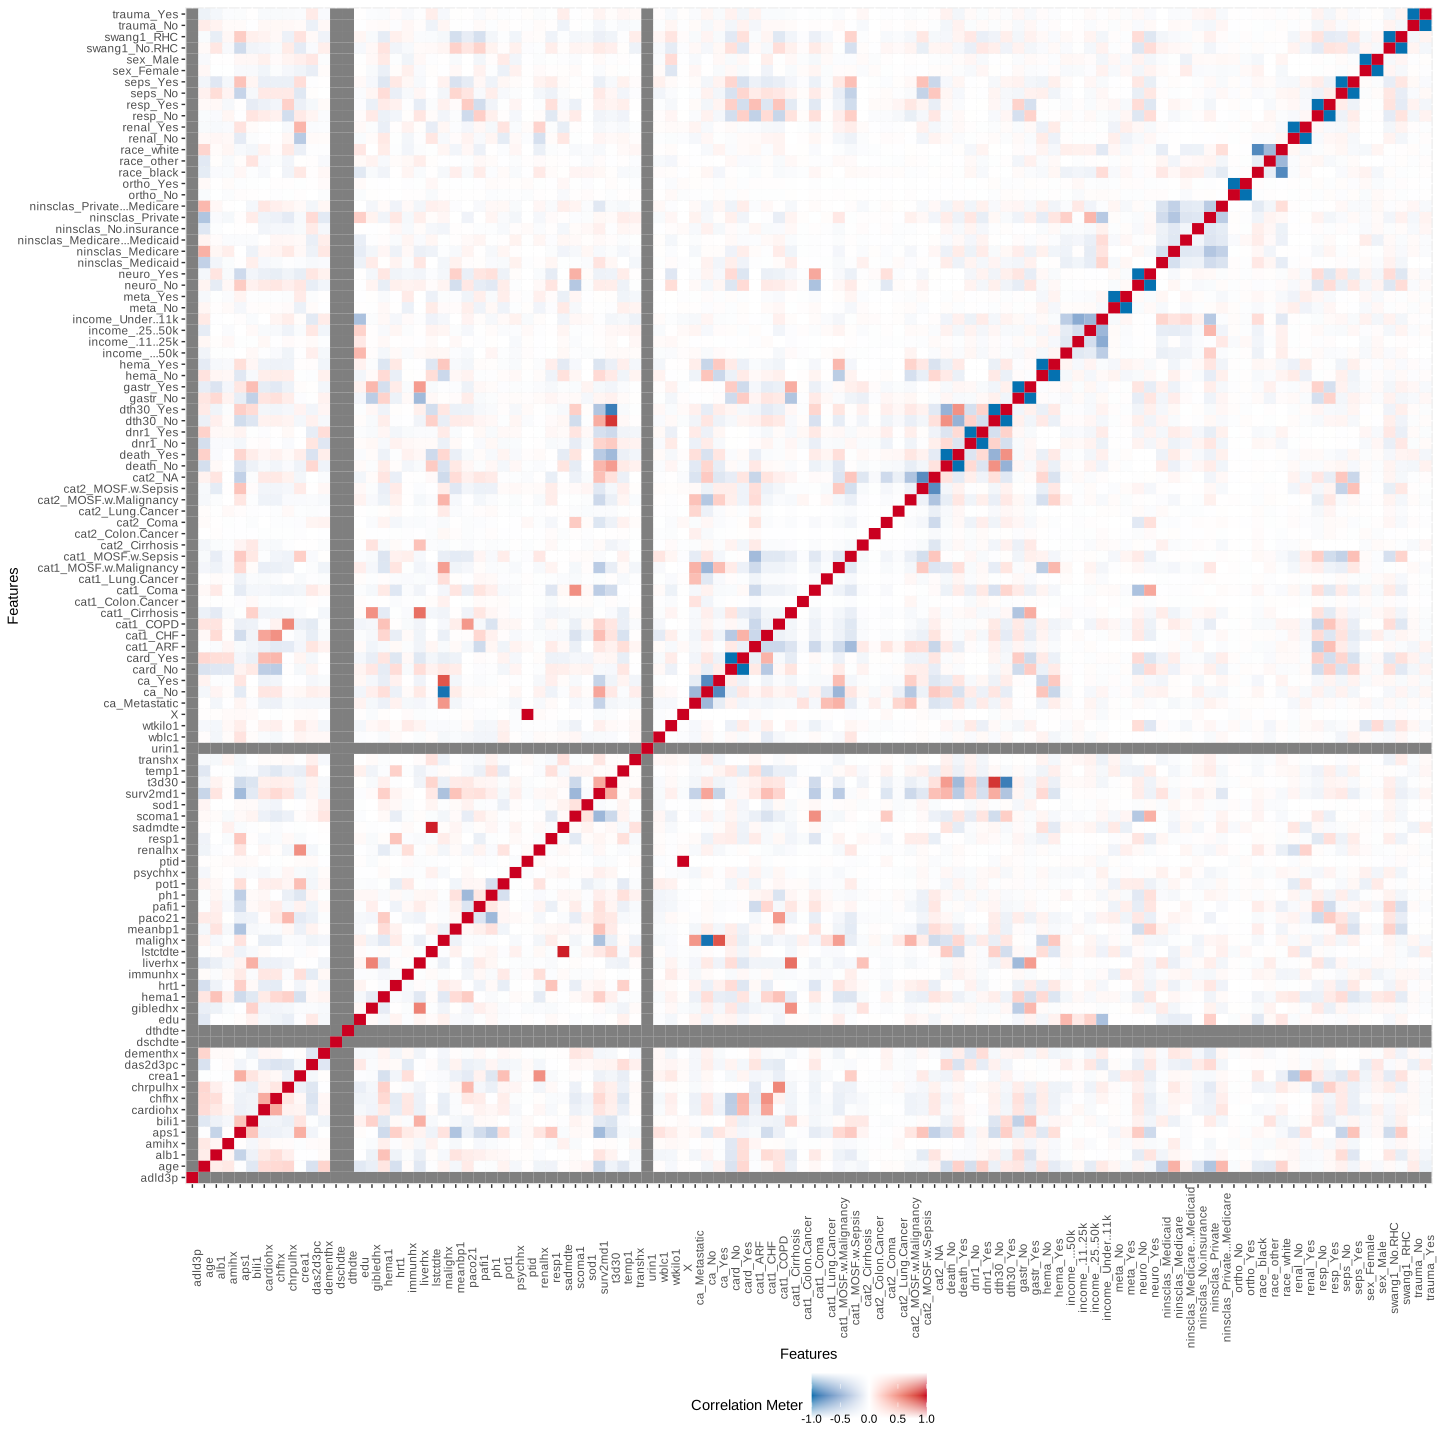
## Bivariat fordeling stratificeret efter en kolonne
plot_boxplot(rhc, by = "death")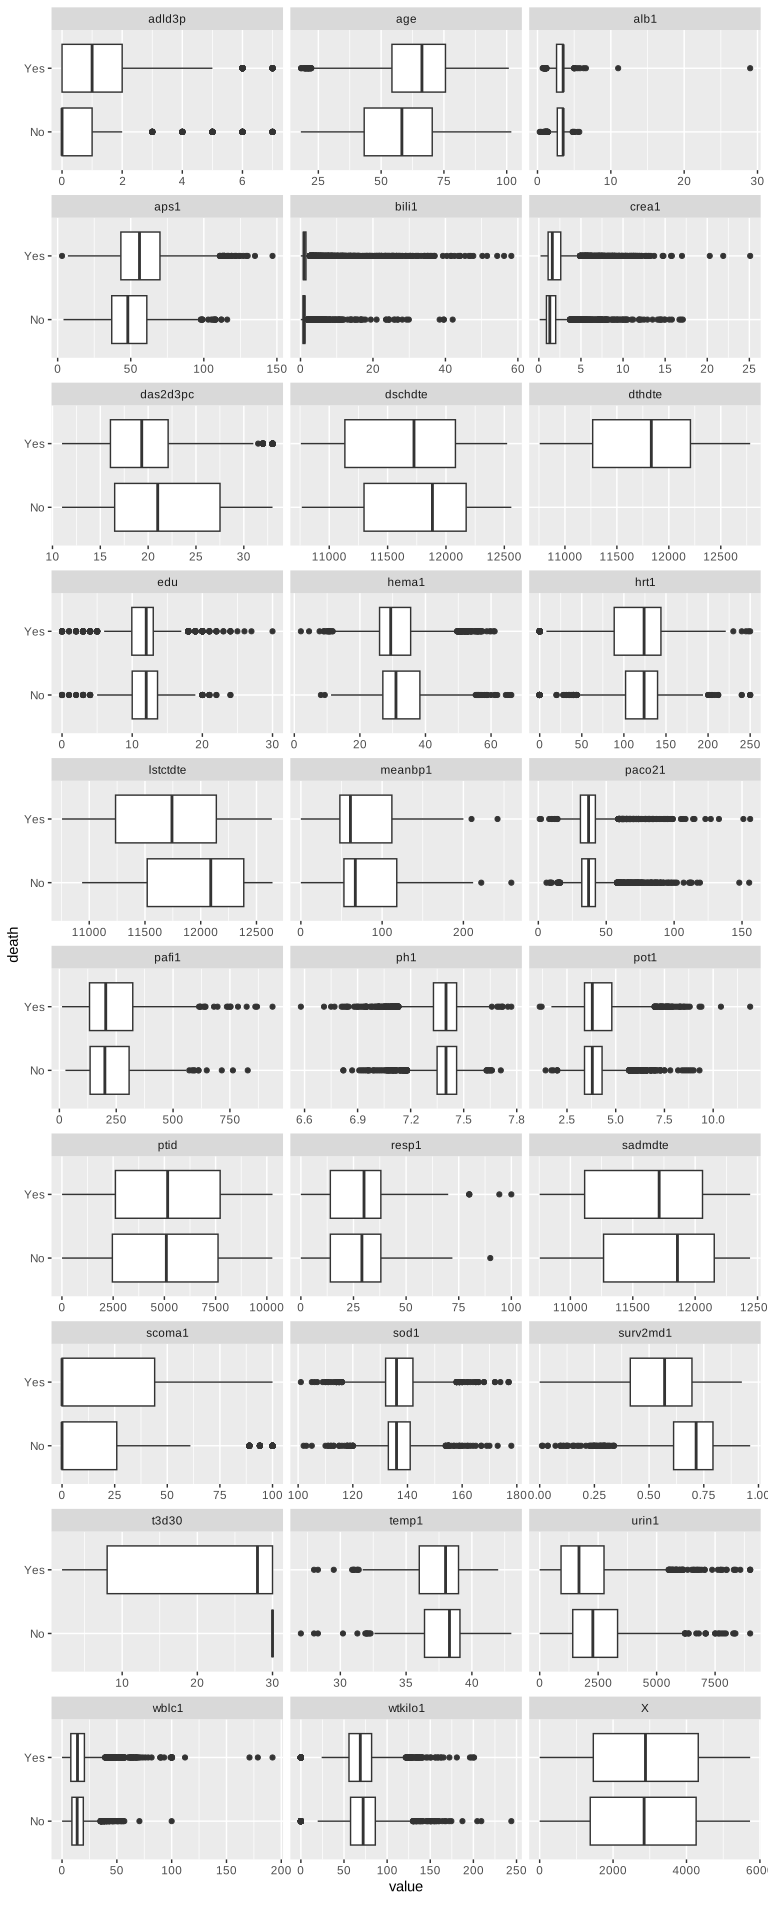
## Scatterplot `price` with all other continuous features
plot_scatterplot(split_columns(rhc)$continuous,
                 by = "age",
                 sampled_rows = 100L,
                 ncol=3, nrow=20)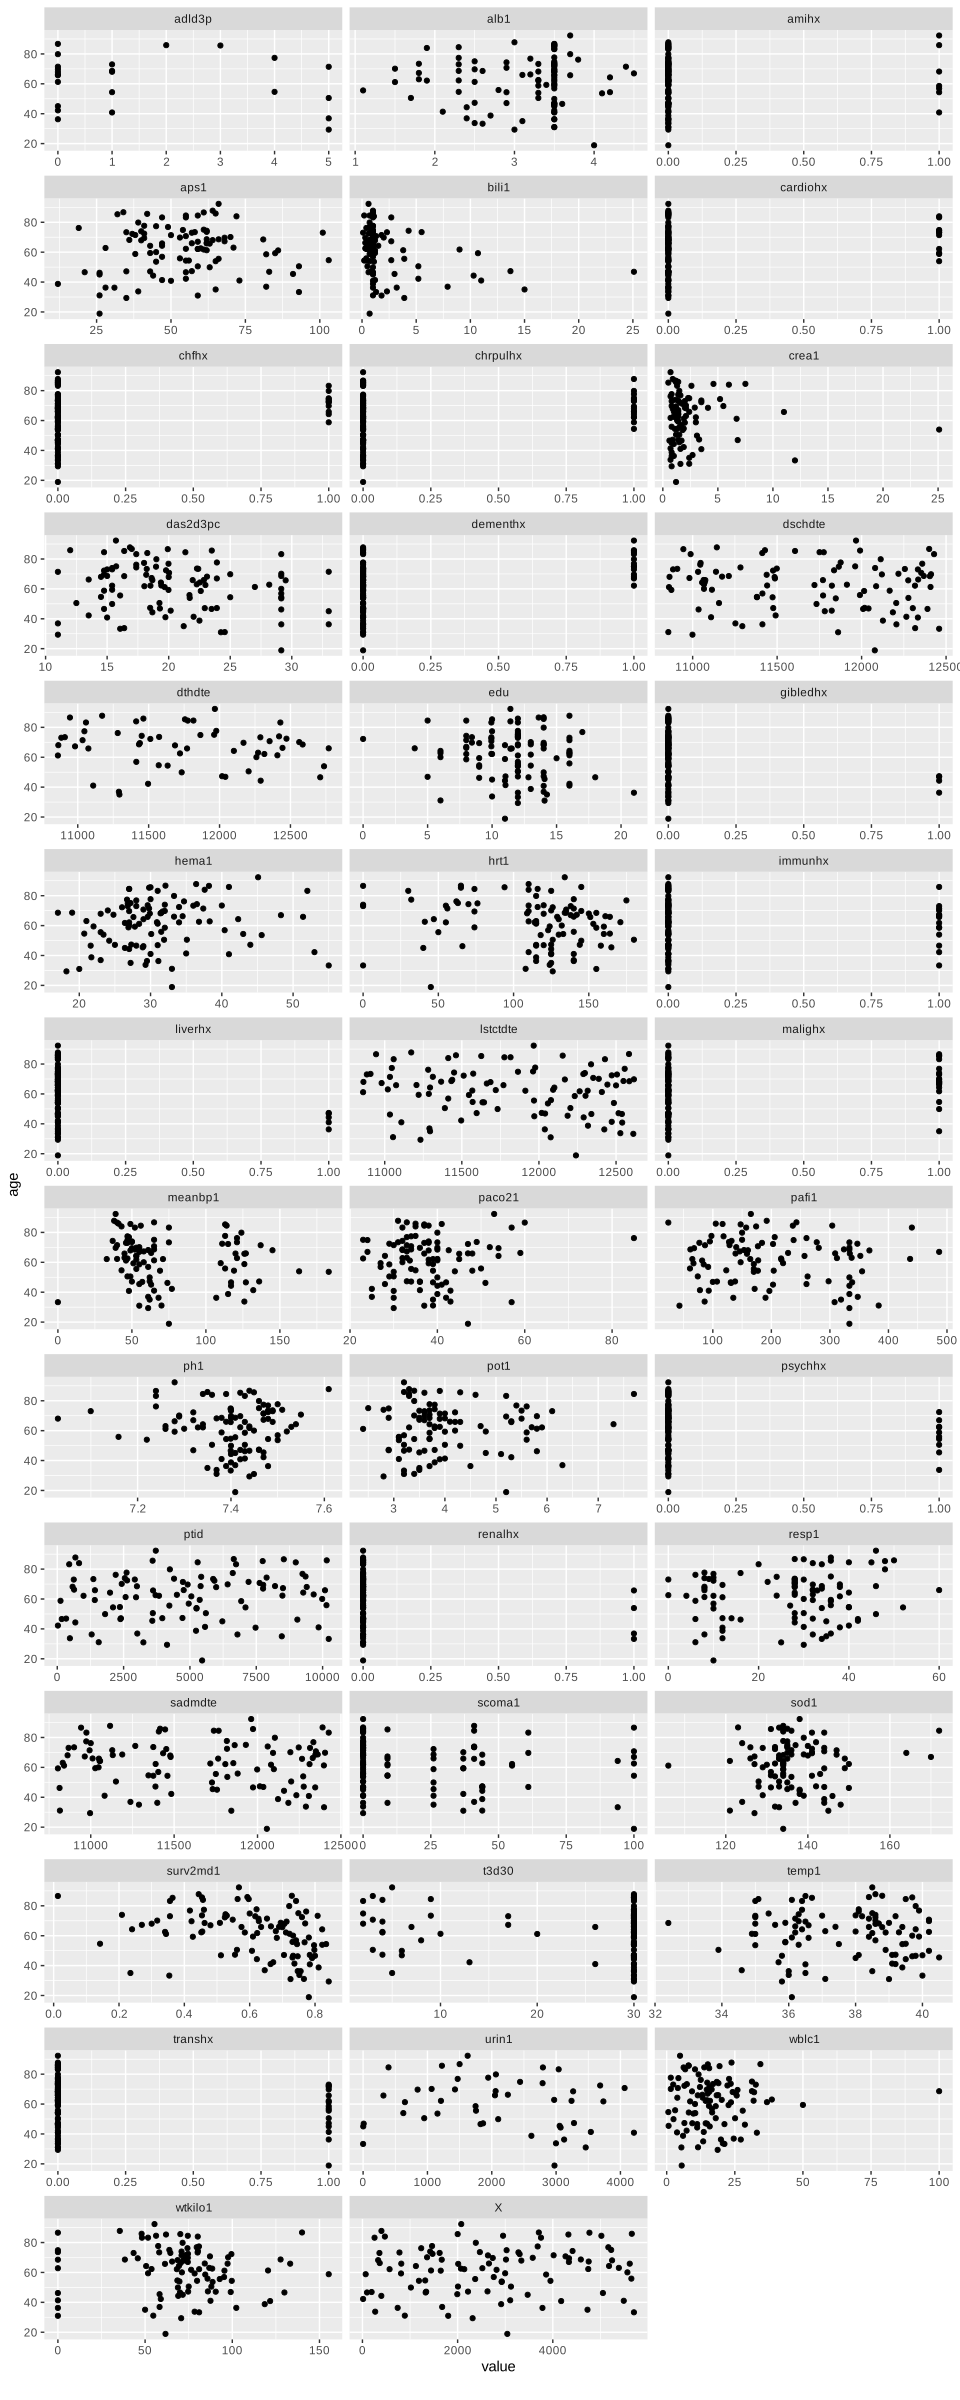
## Visualize principal component analysis
plot_prcomp(rhc, maxcat = 8L)