
Flere geometriske objekter (eng. geoms) har indbyggede funktioner til statistiske transformationer og beregninger. I flere tidligere kapitler har vi demonstreret geom_smooth(), som beregner og visualiserer sammenhængen mellem x og y. Funktionen geom_smooth() har argumentet method, som kan sættes til "loess" for at generere en fleksibel regressionslinje eller "lm", som genererer en lineær regressionslinje. Samme princip gælder for flere andre geoms, hvilket betyder, at de udfører beregninger for at visualisere data.
I dette kapitel vil vi bruge data fra gapminder til at demonstrere, hvordan transformationer fungerer. Vi begynder med at aktivere pakken gapminder og inspicere de første 10 rækker. Inspektion af data kan blandt andet foretages med funktionen head().
library(gapminder)
head(gapminder, 10)| country <fctr> | continent <fctr> | year <int> | lifeExp <dbl> | pop <int> | gdpPercap <dbl> |
|---|---|---|---|---|---|
| Afghanistan | Asia | 1952 | 28.801 | 8425333 | 779.4453 |
| Afghanistan | Asia | 1957 | 30.332 | 9240934 | 820.8530 |
| Afghanistan | Asia | 1962 | 31.997 | 10267083 | 853.1007 |
| Afghanistan | Asia | 1967 | 34.020 | 11537966 | 836.1971 |
| Afghanistan | Asia | 1972 | 36.088 | 13079460 | 739.9811 |
| Afghanistan | Asia | 1977 | 38.438 | 14880372 | 786.1134 |
| Afghanistan | Asia | 1982 | 39.854 | 12881816 | 978.0114 |
| Afghanistan | Asia | 1987 | 40.822 | 13867957 | 852.3959 |
| Afghanistan | Asia | 1992 | 41.674 | 16317921 | 649.3414 |
| Afghanistan | Asia | 1997 | 41.763 | 22227415 | 635.3414 |
Derefter laver vi et søjlediagram, der viser, hvor mange observationer (rækker) der findes for hvert kontinent. Det gøres med geom_bar(), som laver et søjlediagram. Den eneste æstetiske mapping, vi deklarerer, er x=continent. Funktionen beregner automatisk y-aksen (antal rækker for hvert kontinent).
ggplot(data=gapminder) +
  geom_bar(aes(x=continent))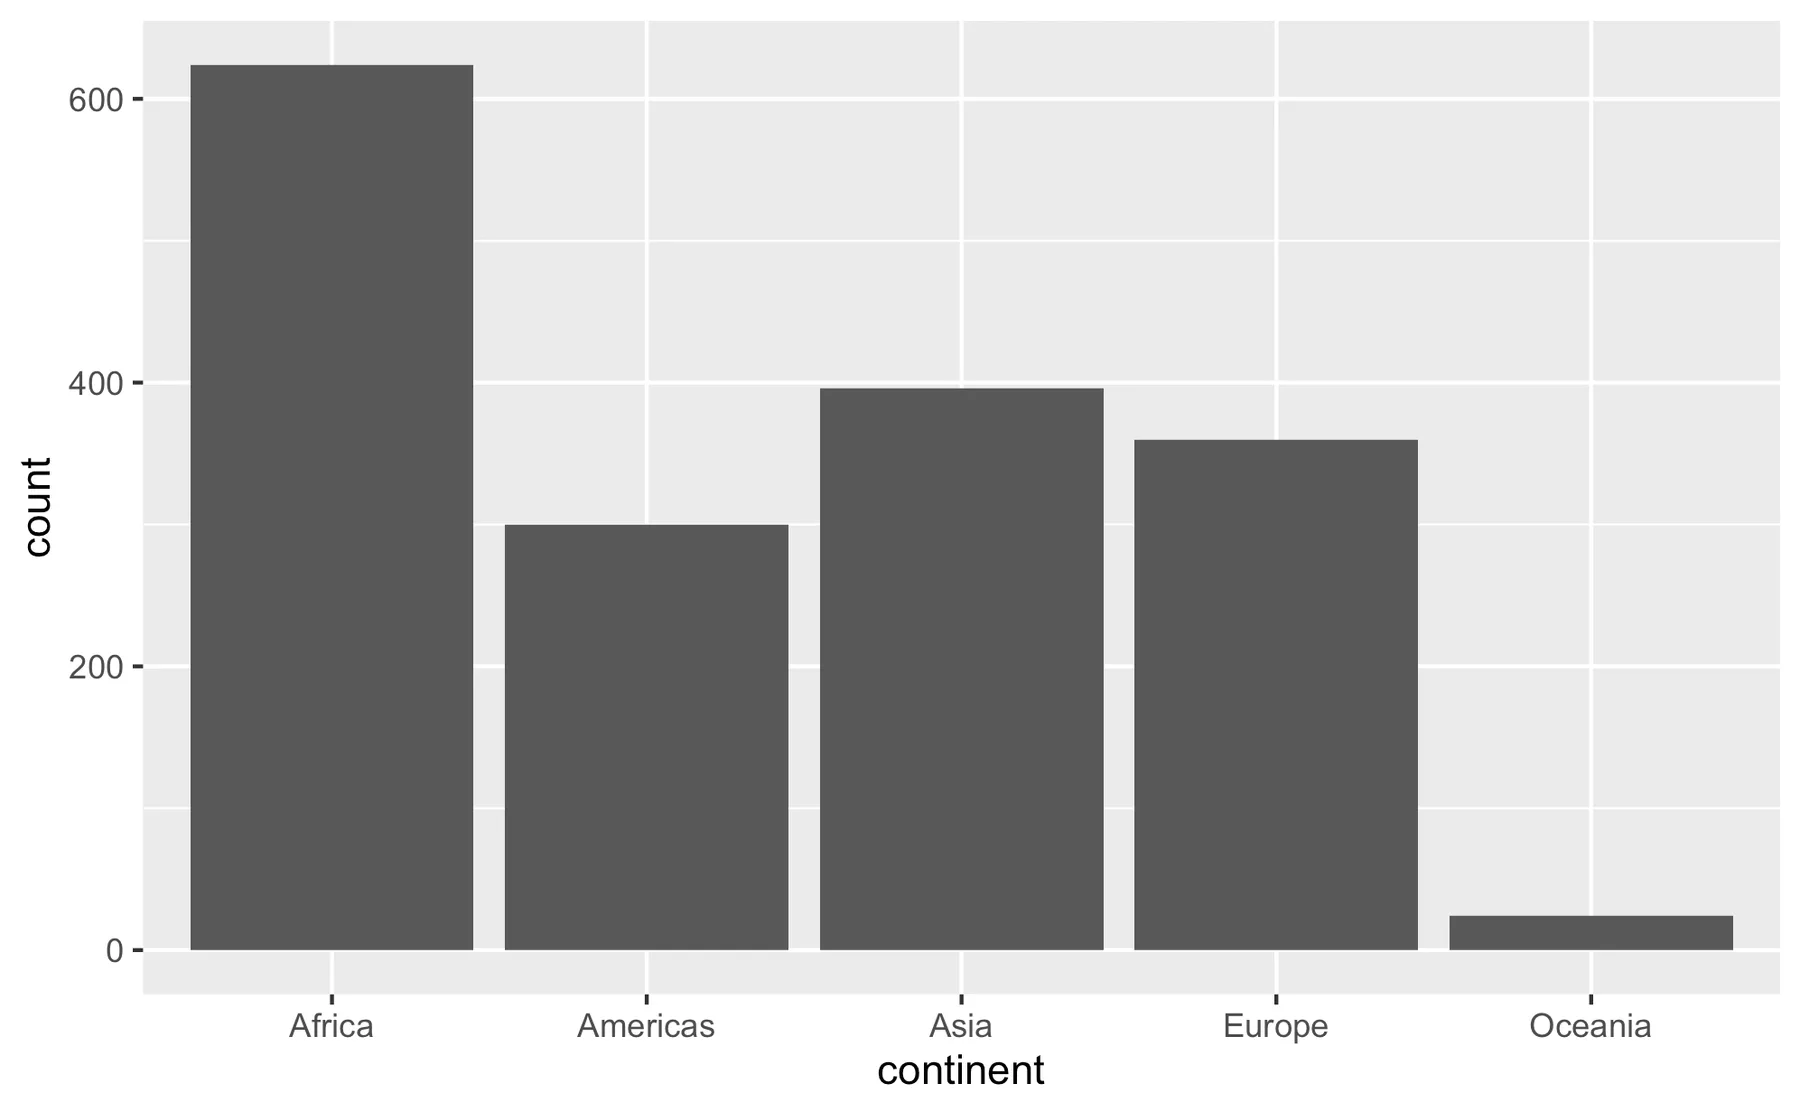
Et alternativ til ovenstående er selv at beregne antallet af observationer på hvert kontinent. Det kan nemt gøres med funktionen count() i pakken dplyr. Du har sandsynligvis allerede indlæst dplyr, eftersom den indgår i pakken tidyverse. Ellers indlæser vi den nu:
library(tidyverse)Funktionen count() tæller antallet af rækker for en eller flere kategoriske variabler på følgende måde:
gapminder |>
count(continent)| continent <fctr> | n <int> |
|---|---|
| Africa | 624 |
| Americas | 300 |
| Asia | 396 |
| Europe | 360 |
| Oceania | 24 |
Som det fremgår ovenfor, beregnes antallet af rækker (n) for hvert kontinent (continent).
Som det fremgår ovenfor, beregnes antallet af rækker (n) for hvert kontinent (continent). Vi tager nu disse data og laver et søjlediagram, der er identisk med det foregående. Eftersom geom_bar() ikke længere selv skal beregne y-aksen, fortæller vi, at y=n, og vi bruger argumentet stat="identity" til at fortælle, at værdierne allerede er beregnet. Bemærk også, at vi kobler count() sammen med ggplot() og dermed bruger resultatet af count() direkte i ggplot(). Det er muligt, fordi pipe (|>) sender resultatet af en operation videre til den næste funktion, hvor resultatet bruges som første argument (første argument i funktionen ggplot() er data).
gapminder |>
  count(continent) |>
  ggplot(aes(x=continent, y=n)) +
  geom_bar(stat="identity")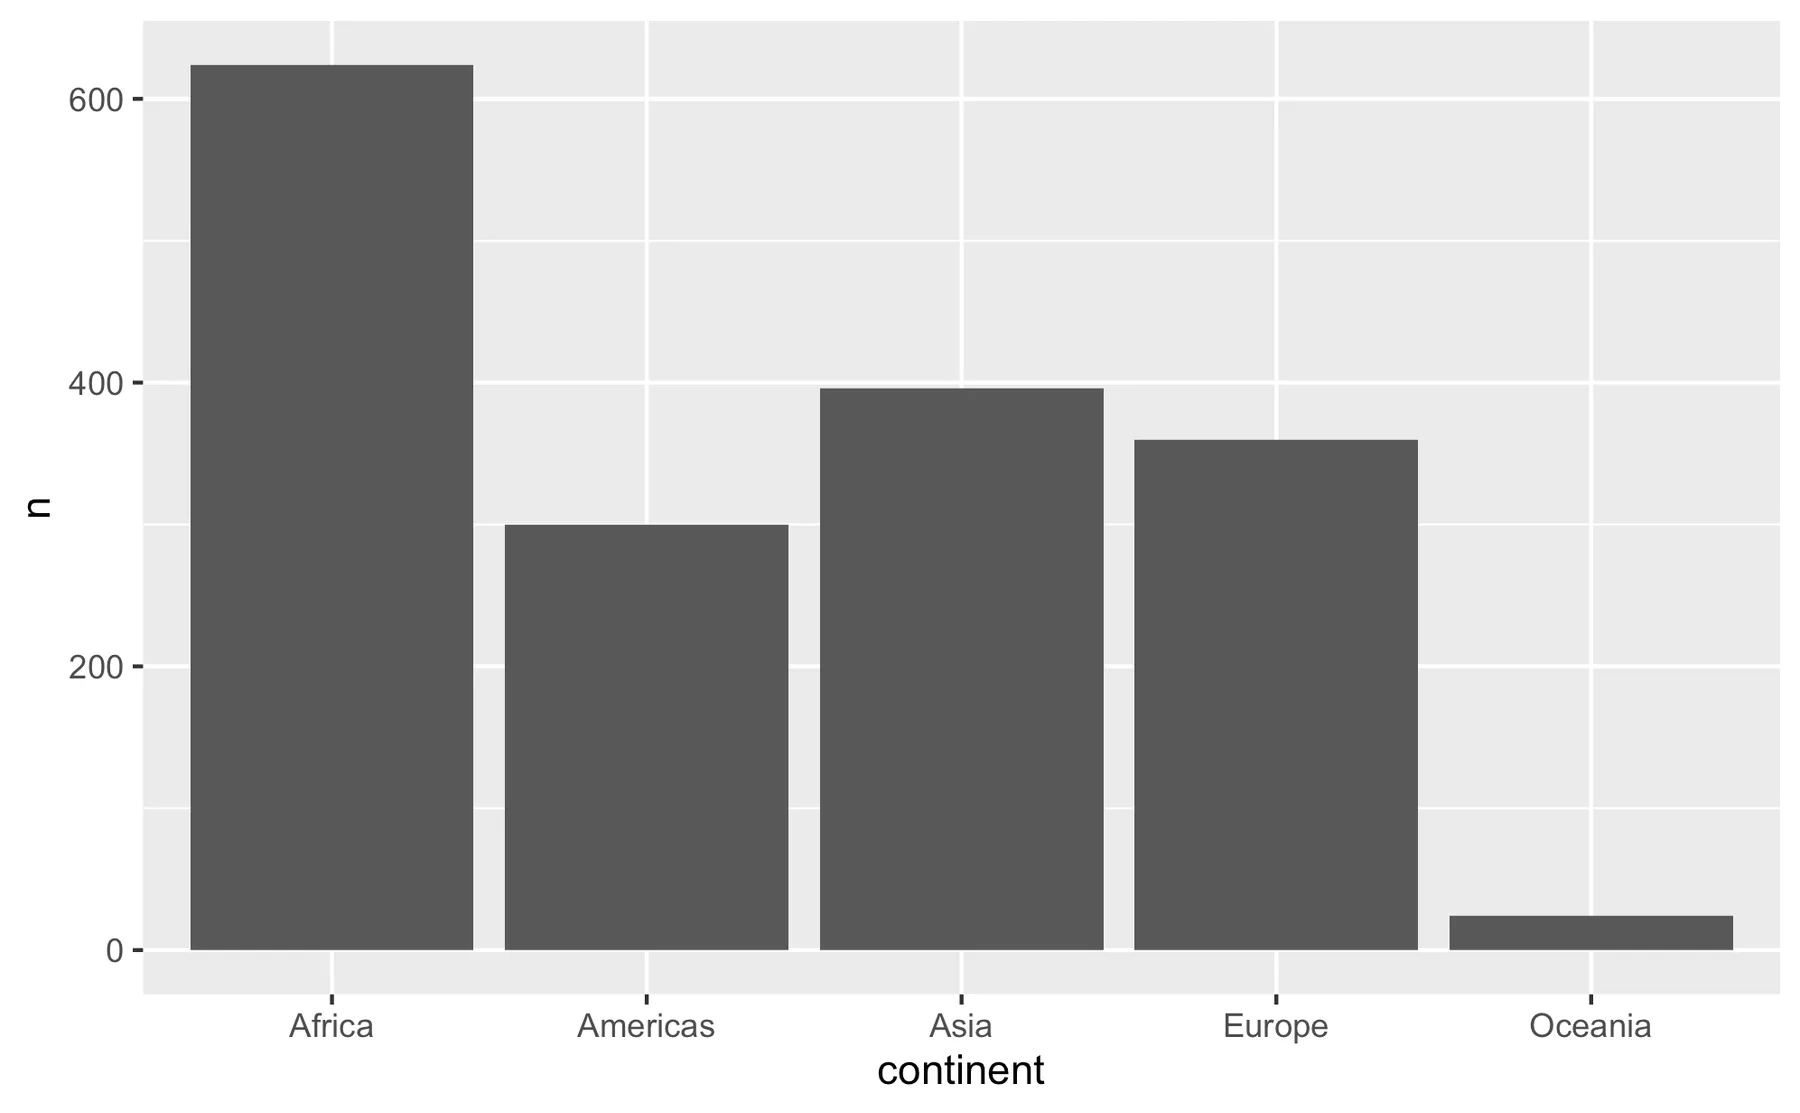
Der findes andre transformationer (beregninger) indbygget i geometriske objekter. Du er allerede stødt på geom_smooth() i det foregående kapitel. Her følger andre eksempler på geoms, der udfører beregninger, når de anvendes:
geom_bar(),geom_histogram(),geom_freqpoly()beregner summer og proportioner.geom_boxplot(),geom_violin()beregner fordelinger.geom_smooth()laver en regressionsmodel, som visualiseres.
I det næste eksempel bruger vi gapminder til at gøre følgende:
- Linje 2: Vi beholder kun lande i Afrika ved at filtrere med argumentet
continent=="Africa". - Linje 2: Vi beholder kun data fra år 1997 ved at filtrere med argumentet
year==1997. - Linje 2: Vi kobler
ggplot()direkte sammen med de foregående operationer med|> - Linje 4: Vi laver et søjlediagram, hvor land er y-aksen og forventet levealder er x-aksen. Eftersom disse værdier allerede er beregnet, bruges argumentet
stat="identity":
gapminder |>
  filter(continent=="Africa", year==1997) |>
  ggplot()+
  geom_bar(aes(y=country,
               x=pop),
           stat="identity")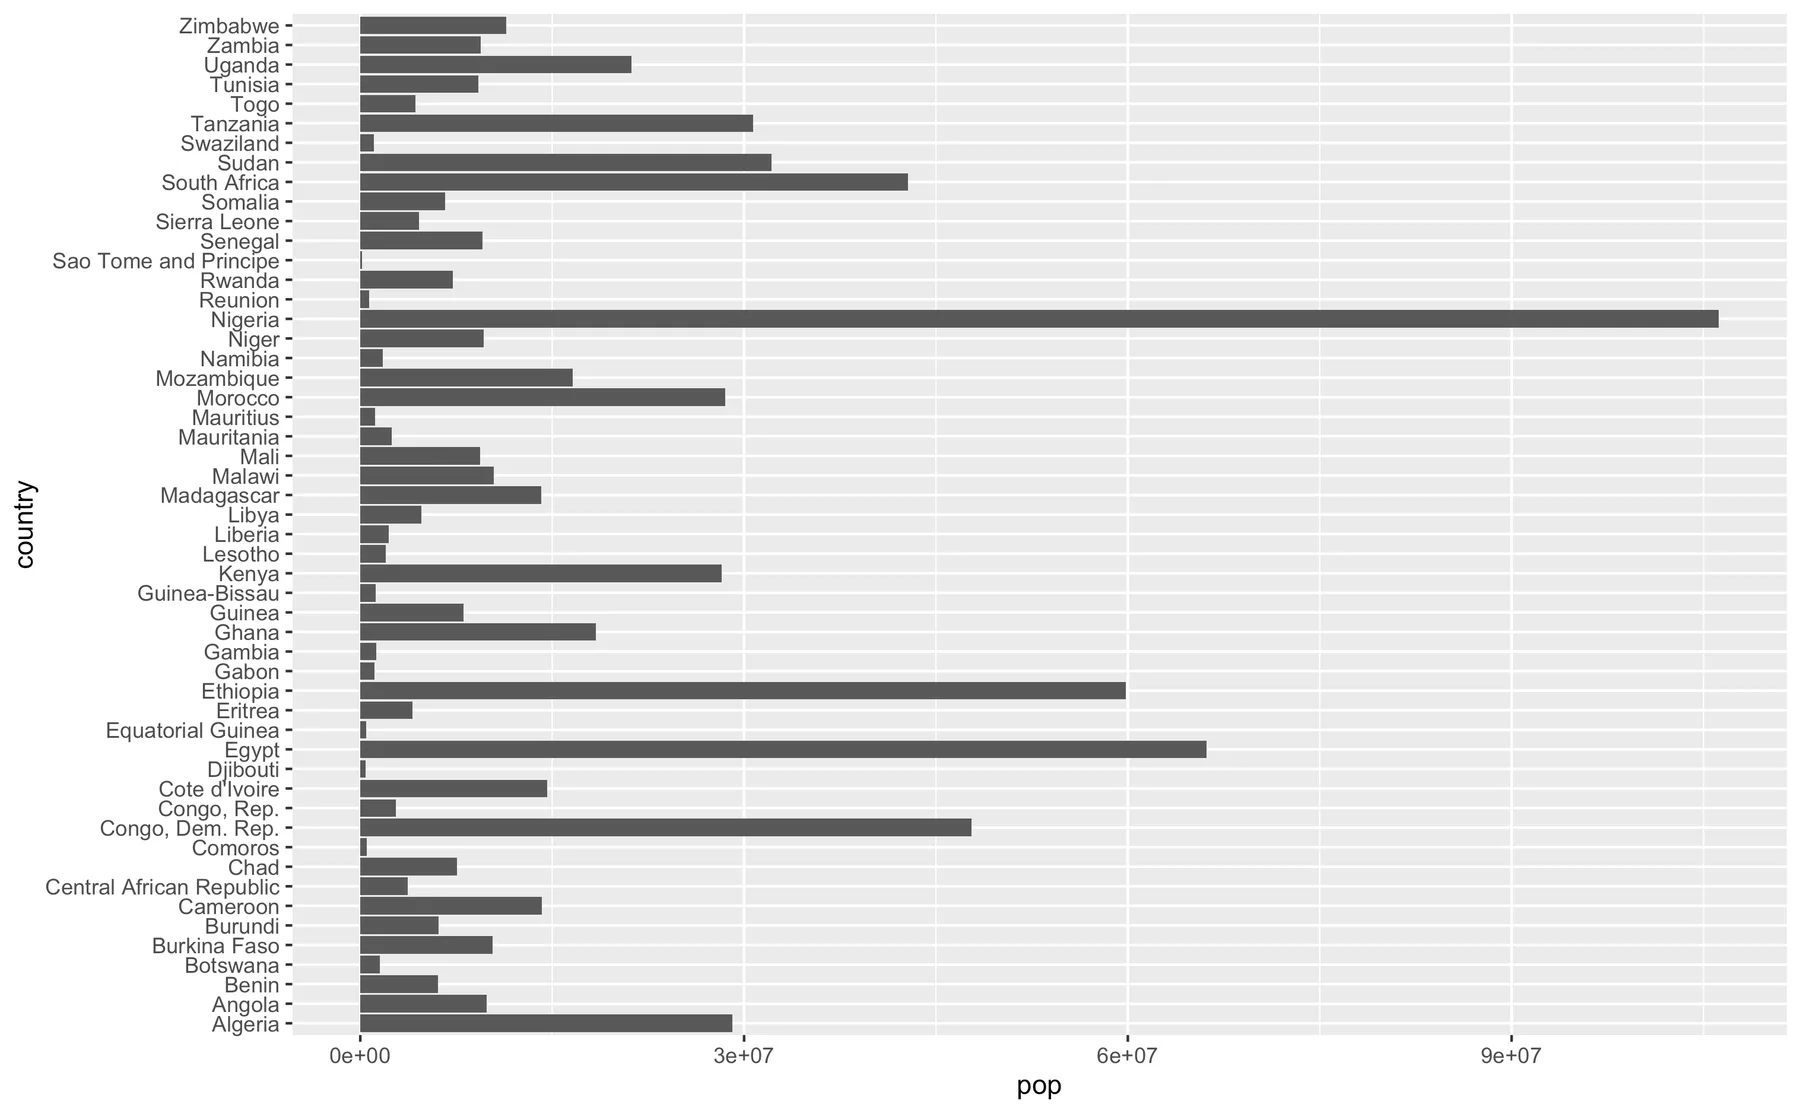
Vi fortsætter med at sortere y-aksen efter forventet levealder (lifeExp). Det kan gøres direkte i aes() med funktionen reorder(). I reorder angives, hvad der skal sorteres (country), og den kolonne, der skal sorteres efter (pop, som er befolkningstallet). Se linje 4 nedenfor.
gapminder |>
  filter(continent=="Africa", year==1997) |>
  ggplot()+
  geom_bar(aes(y=reorder(country, pop),
               x=pop),
           stat="identity")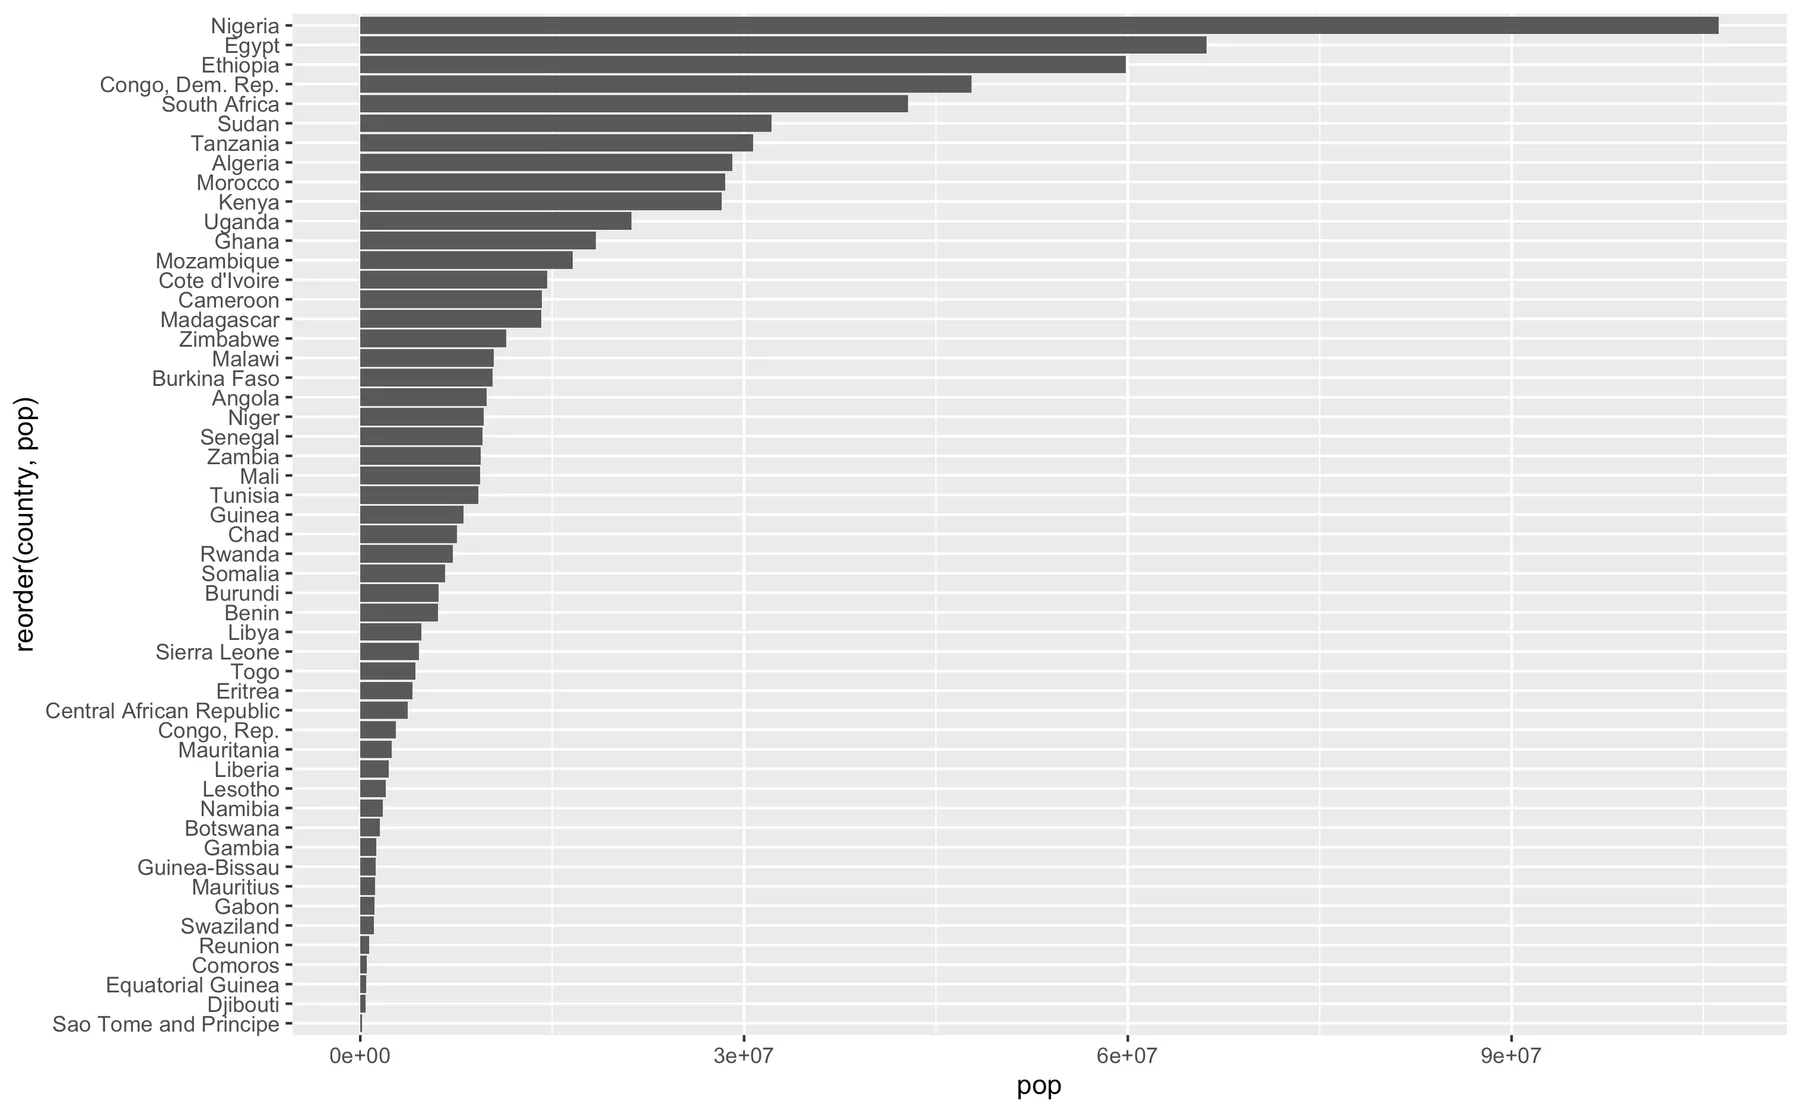
Et minustegn (-) foran pop i reorder() resulterer i omvendt sortering som følger (se linje 4):
gapminder |>
  filter(continent=="Africa", year==1997) |>
  ggplot()+
  geom_bar(aes(y=reorder(country, -pop),
               x=pop),
           stat="identity")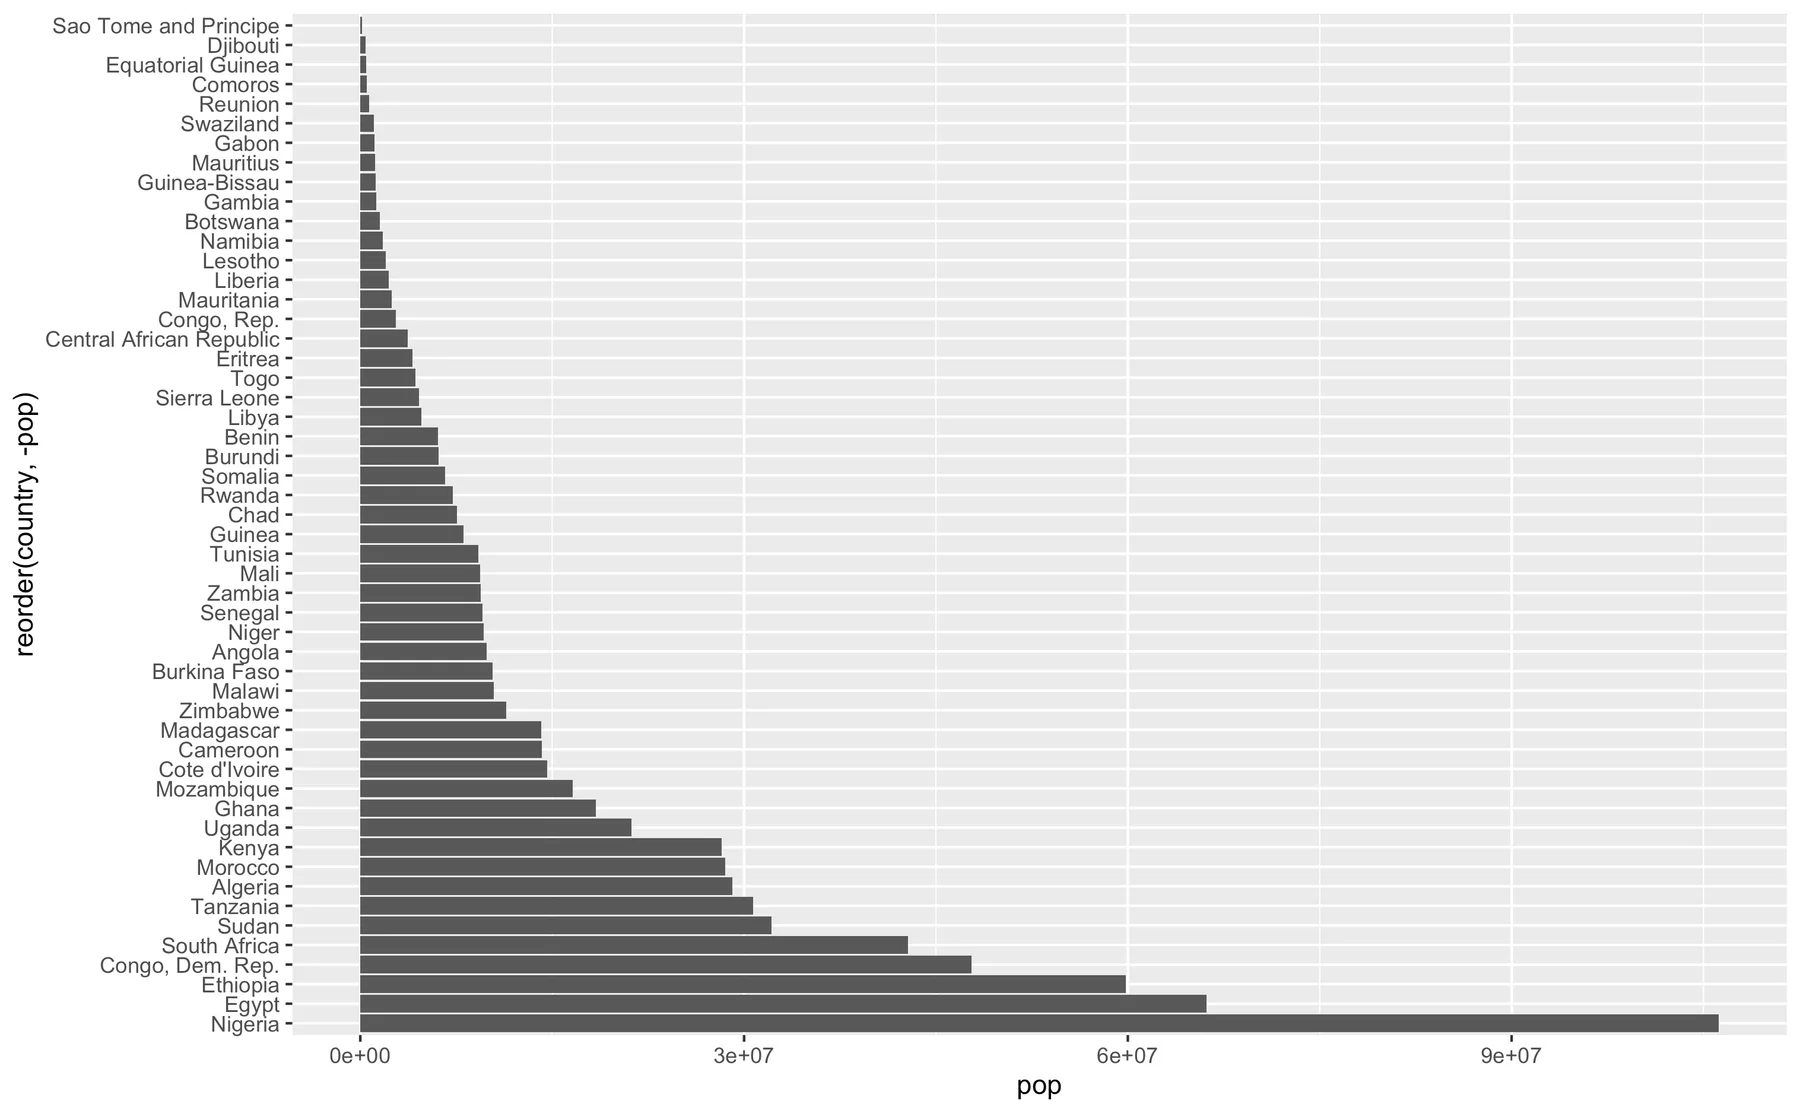
Vi har også brug for at visualisere den forventede levealder (lifeExp) for hvert land og kan gøre det med argumentet fill() på følgende måde (linje 6):
gapminder |>
  filter(continent=="Africa", year==1997) |>
  ggplot()+
  geom_bar(aes(y=reorder(country, pop),
               x=pop,
               fill=lifeExp),
           stat="identity")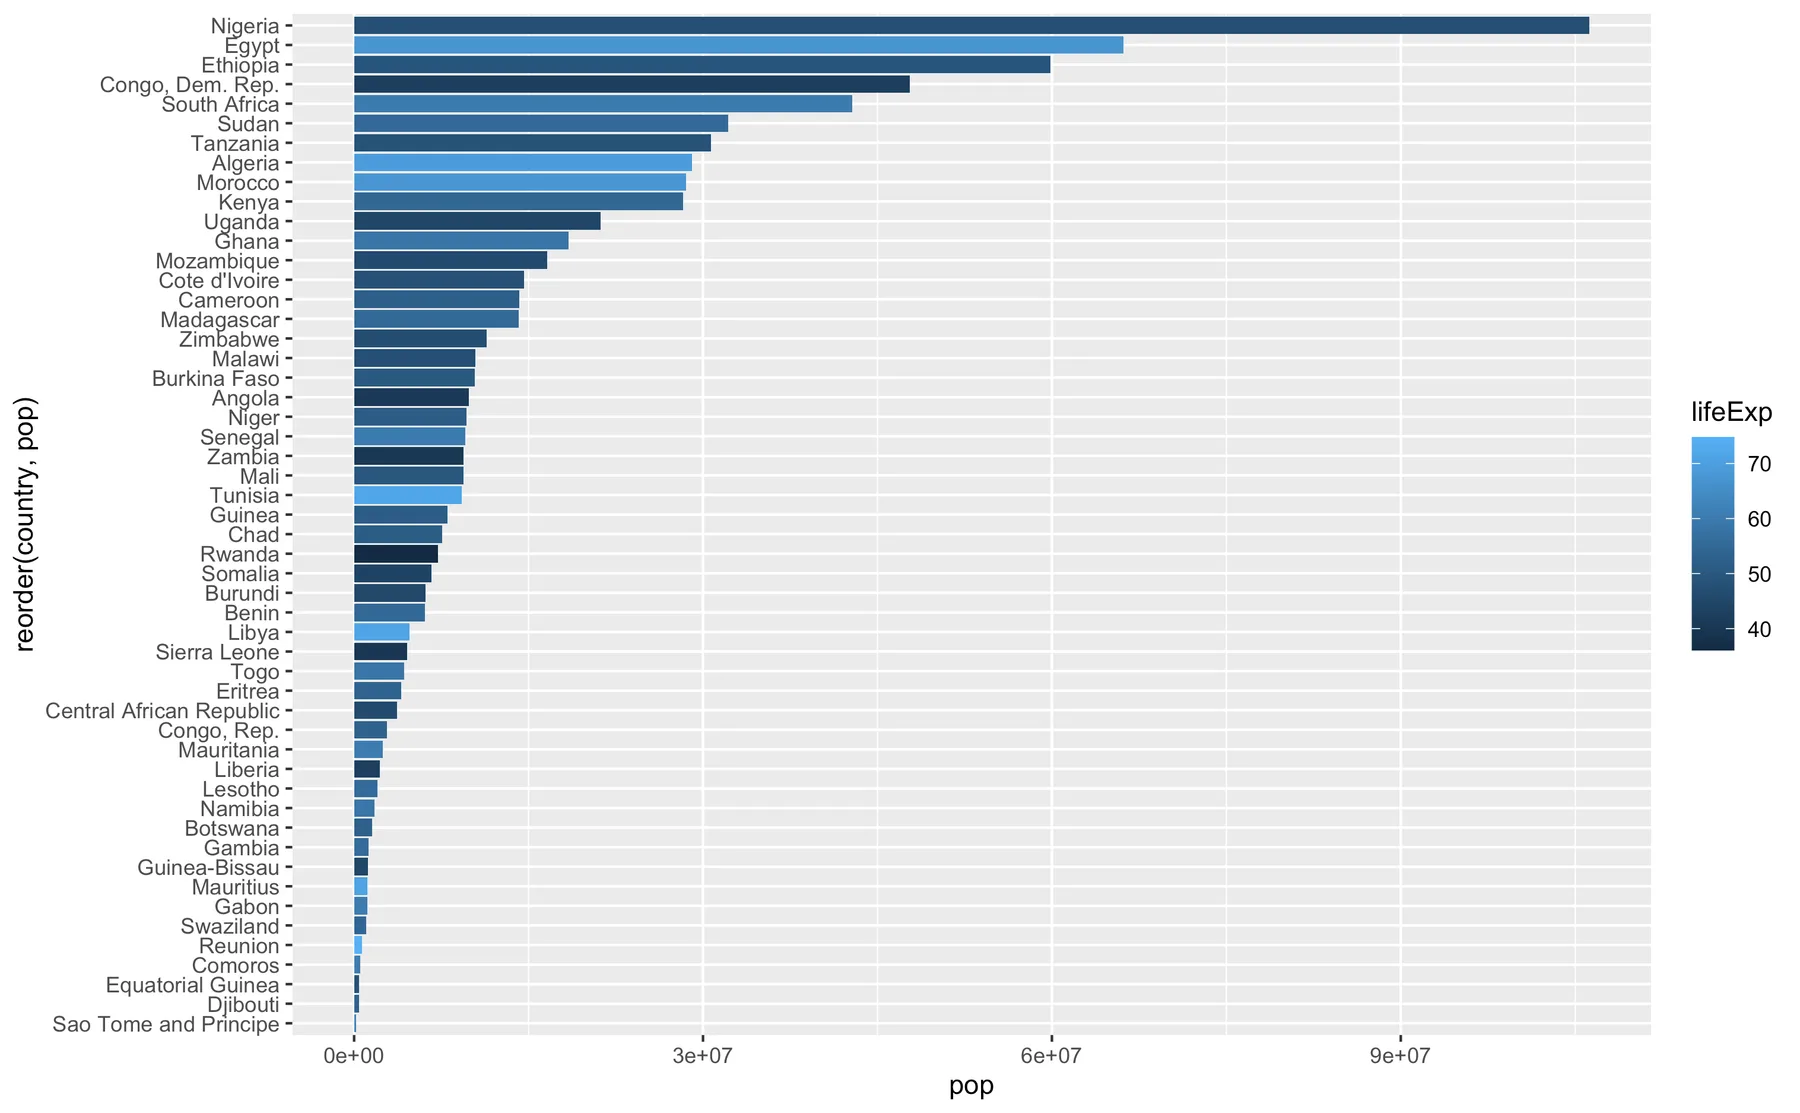
Proportioner
Med geom_bar() kan proportioner (prop) beregnes i stedet for antal (count). Det gøres ved en "efterberegning" (after_stat) på y og ved at angive group=1, hvilket betyder, at den samlede andel på tværs af alle kontinenter skal være 1:
ggplot(data = gapminder) +
  geom_bar(mapping = aes(x = continent,
                         y = after_stat(prop),
                         group = 1))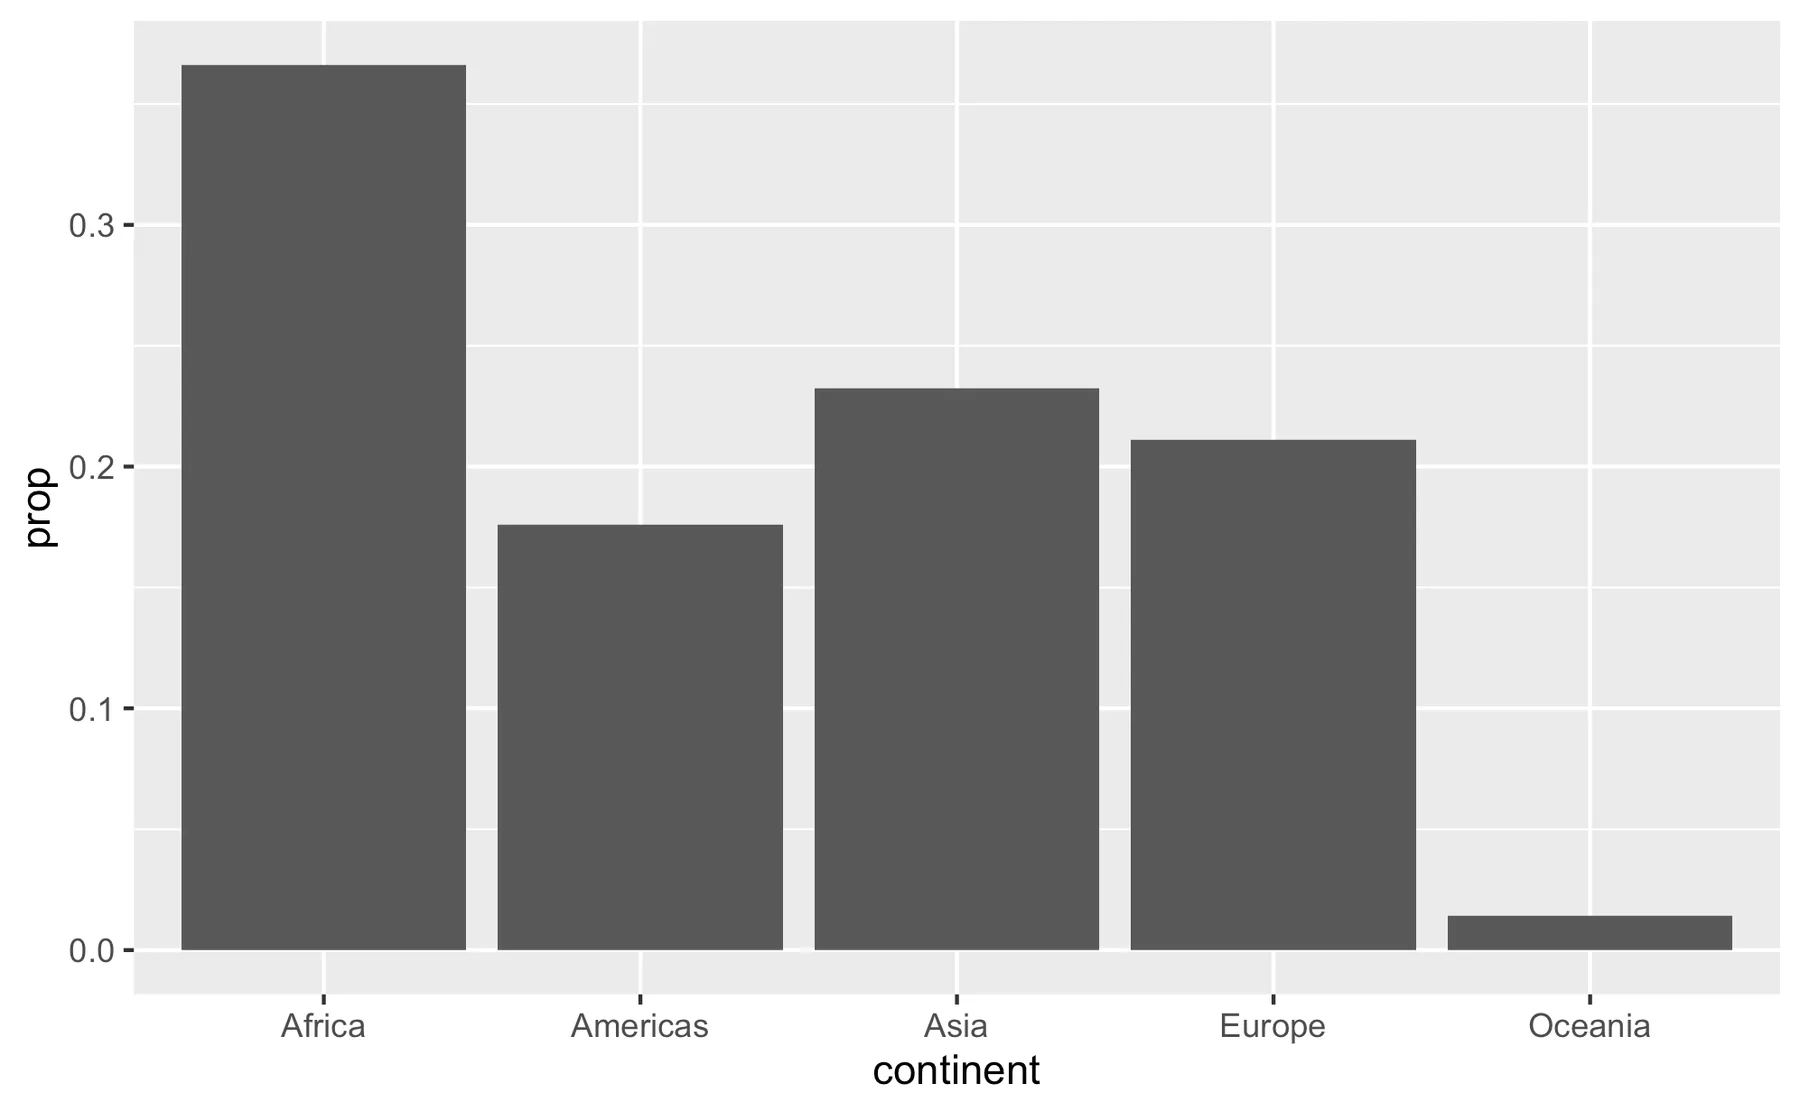
Stat summary: stat_summary()
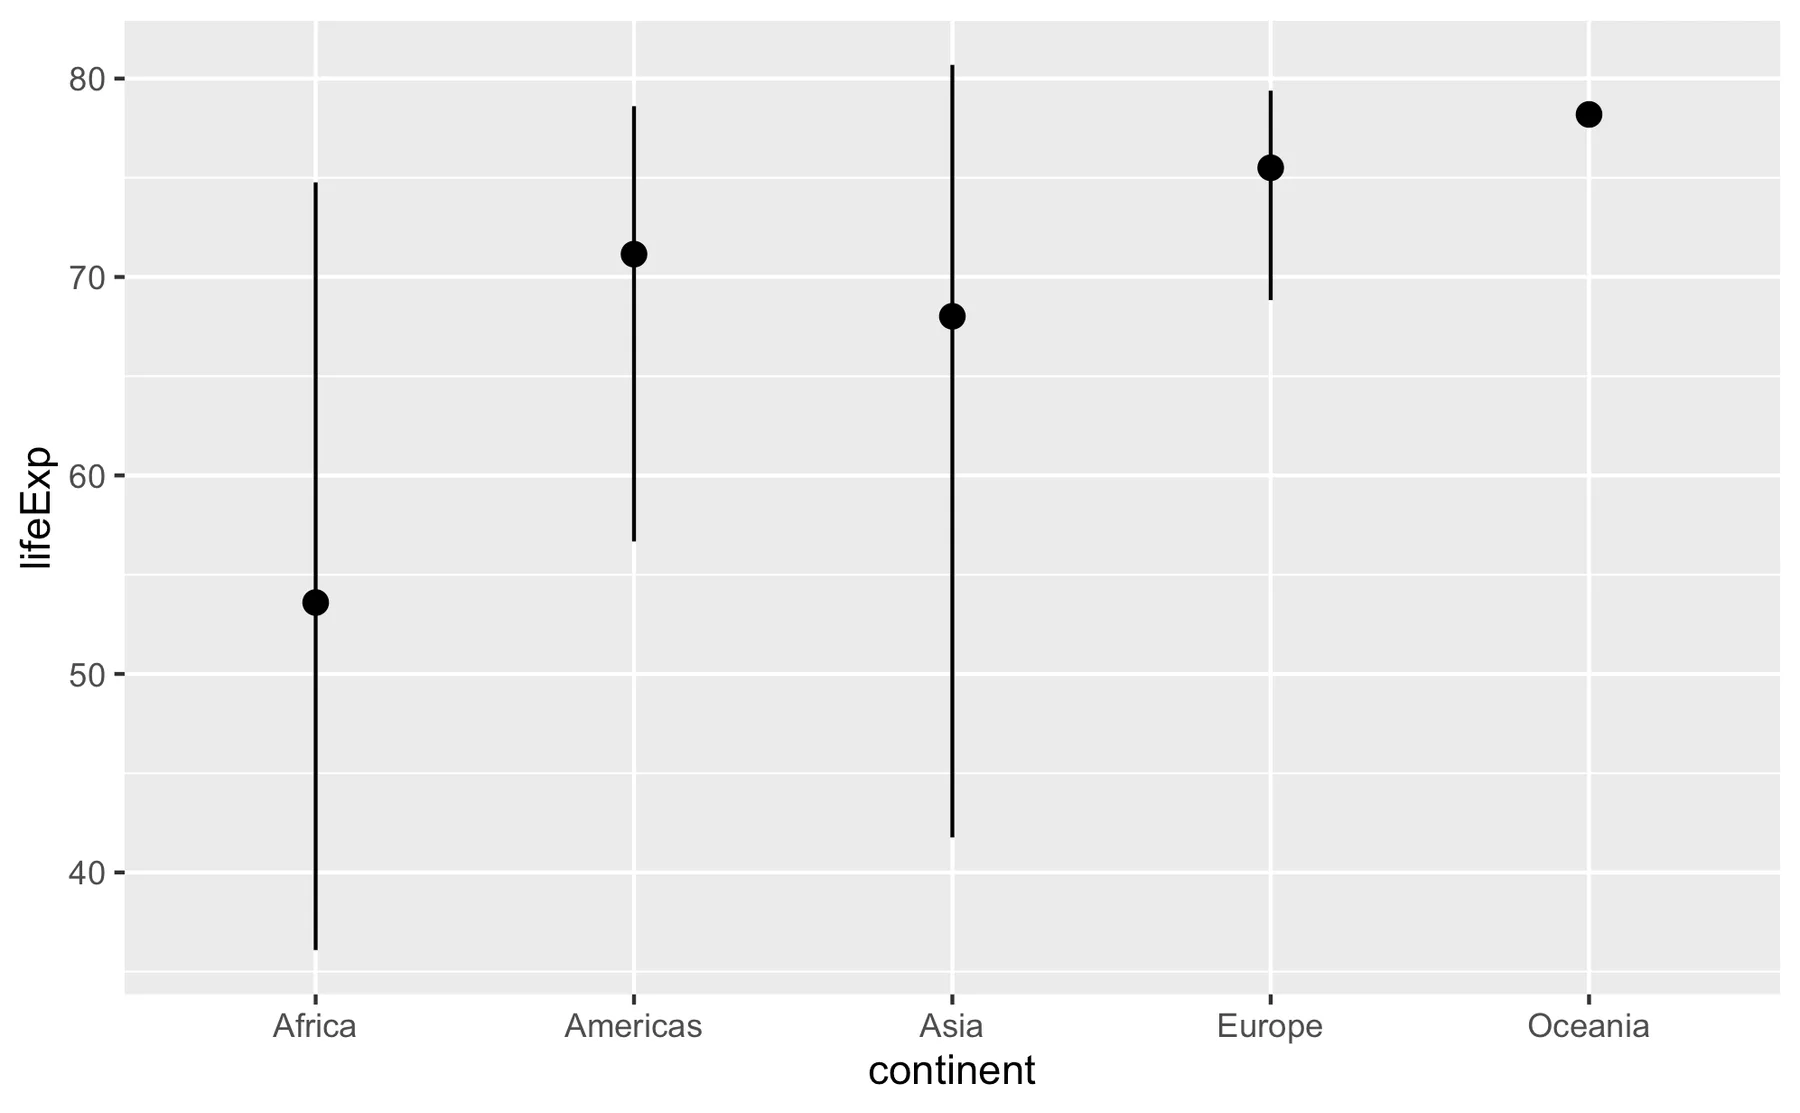
Vi kan også bruge stat_summary() til at vælge, hvilke parametre der skal beregnes og visualiseres. Med stat_summary() har vi større fleksibilitet med hensyn til beregningerne. Vi angiver selv, hvilke funktioner der skal bruges, og vi vælger desuden, hvilken type geom der skal illustrere resultatet. Herunder bruger vi stat_summary() til at beregne middelværdi, mindste værdi og største værdi for forventet levealder på hvert kontinent, og dette visualiseres med geomet "pointrange" (geom_pointrange()):
## Vi bruger kun data fra 1997
ggplot(data = filter(gapminder, year==1997)) +
  stat_summary(
    aes(x = continent,
        y = lifeExp),
    fun = mean,
    fun.min = min,
    fun.max = max,
    geom = "pointrange"
  )
Segmenterede søjlediagrammer
Vi vender tilbage til mpg-data for at illustrere yderligere funktioner i geom_bar(). I det næste eksempel bruger vi fill til at markere andele af en søjle. Vi ønsker at markere andele af kolonnen drv (bilens drivlinje) i hver søjle. I koden nedenfor har vi også justeret grafens tema med funktionen theme() for at vinkle teksten på x-aksen 45° (temaer diskuteres i et senere kapitel).
mpg |>
  ggplot(aes(x=manufacturer,
             fill=drv)) +
  geom_bar() +
  # Giver teksten på x-aksen 45° hældning
  theme(axis.text.x = element_text(angle=45))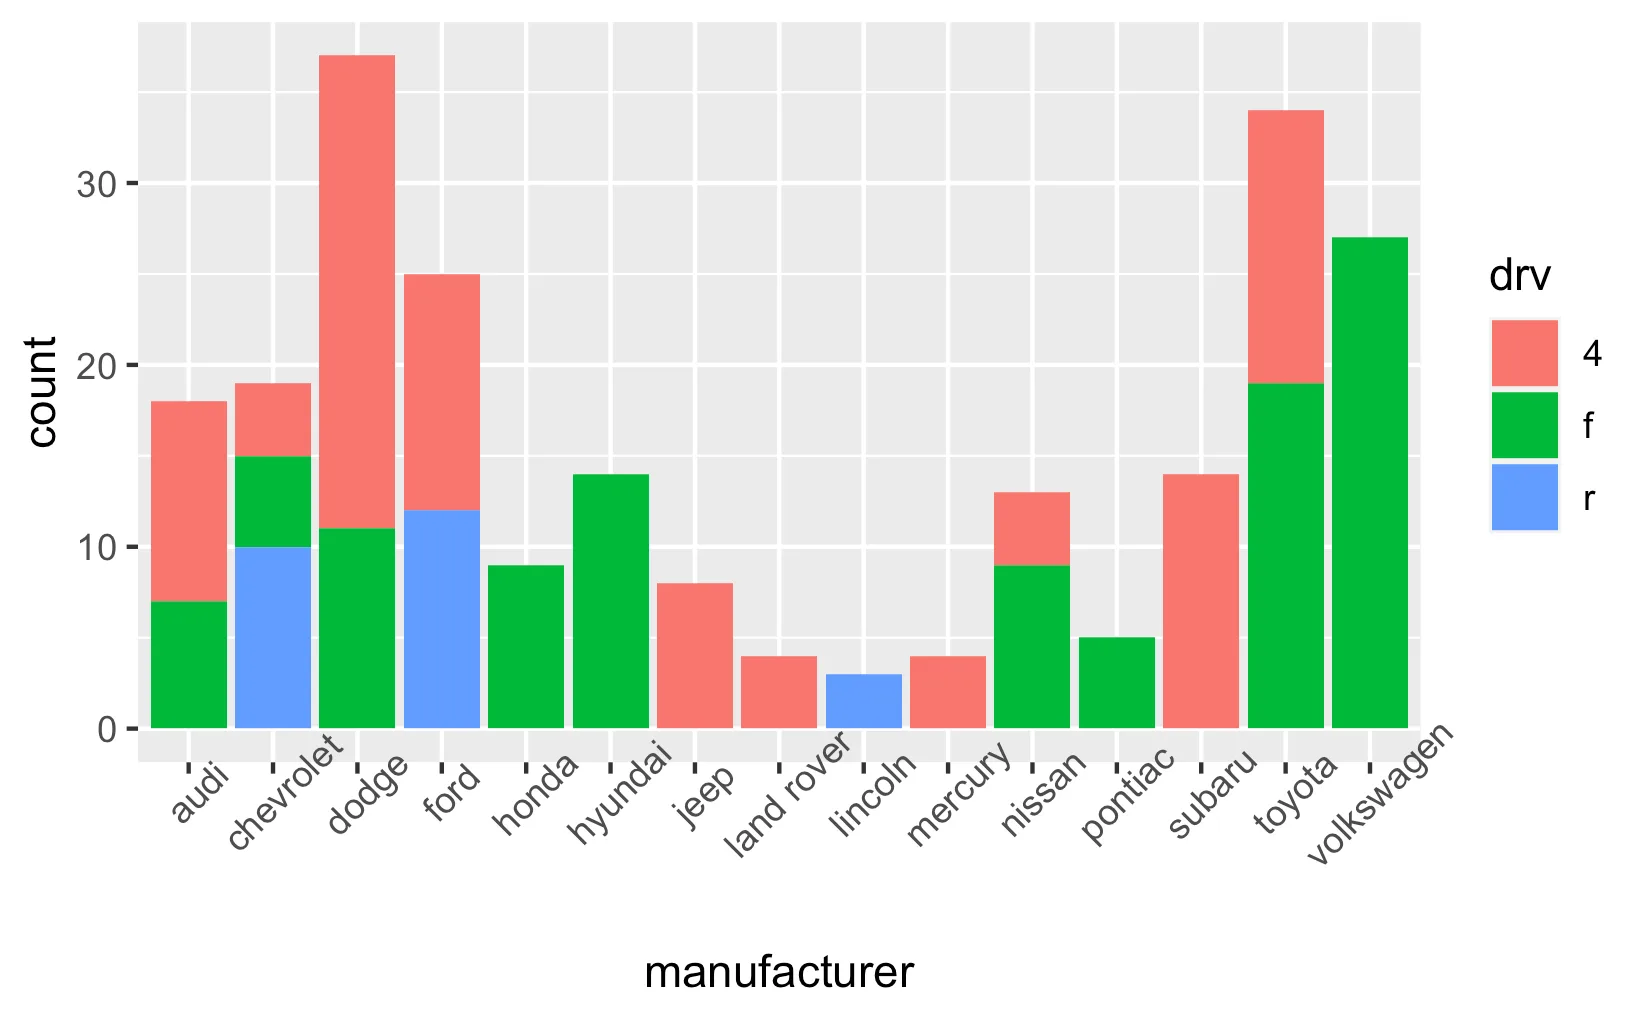
Det ser ud til, at producenten Volkswagen kun fremstiller biler med forhjulstræk (f), mens Subaru kun fremstiller biler med firehjulstræk. Land Rover fremstiller kun baghjulstrukne biler.
I eksemplet ovenfor skrev vi geom_gar() uden argumenter. Det betyder, at position fik sin standardværdi, som er "identity". Der findes også alternativerne "dodge" og "fill", som resulterer i følgende grafer:
mpg |>
  ggplot(aes(x=manufacturer,
             fill=drv)) +
  geom_bar(position="dodge") +
  theme(axis.text.x = element_text(angle=45))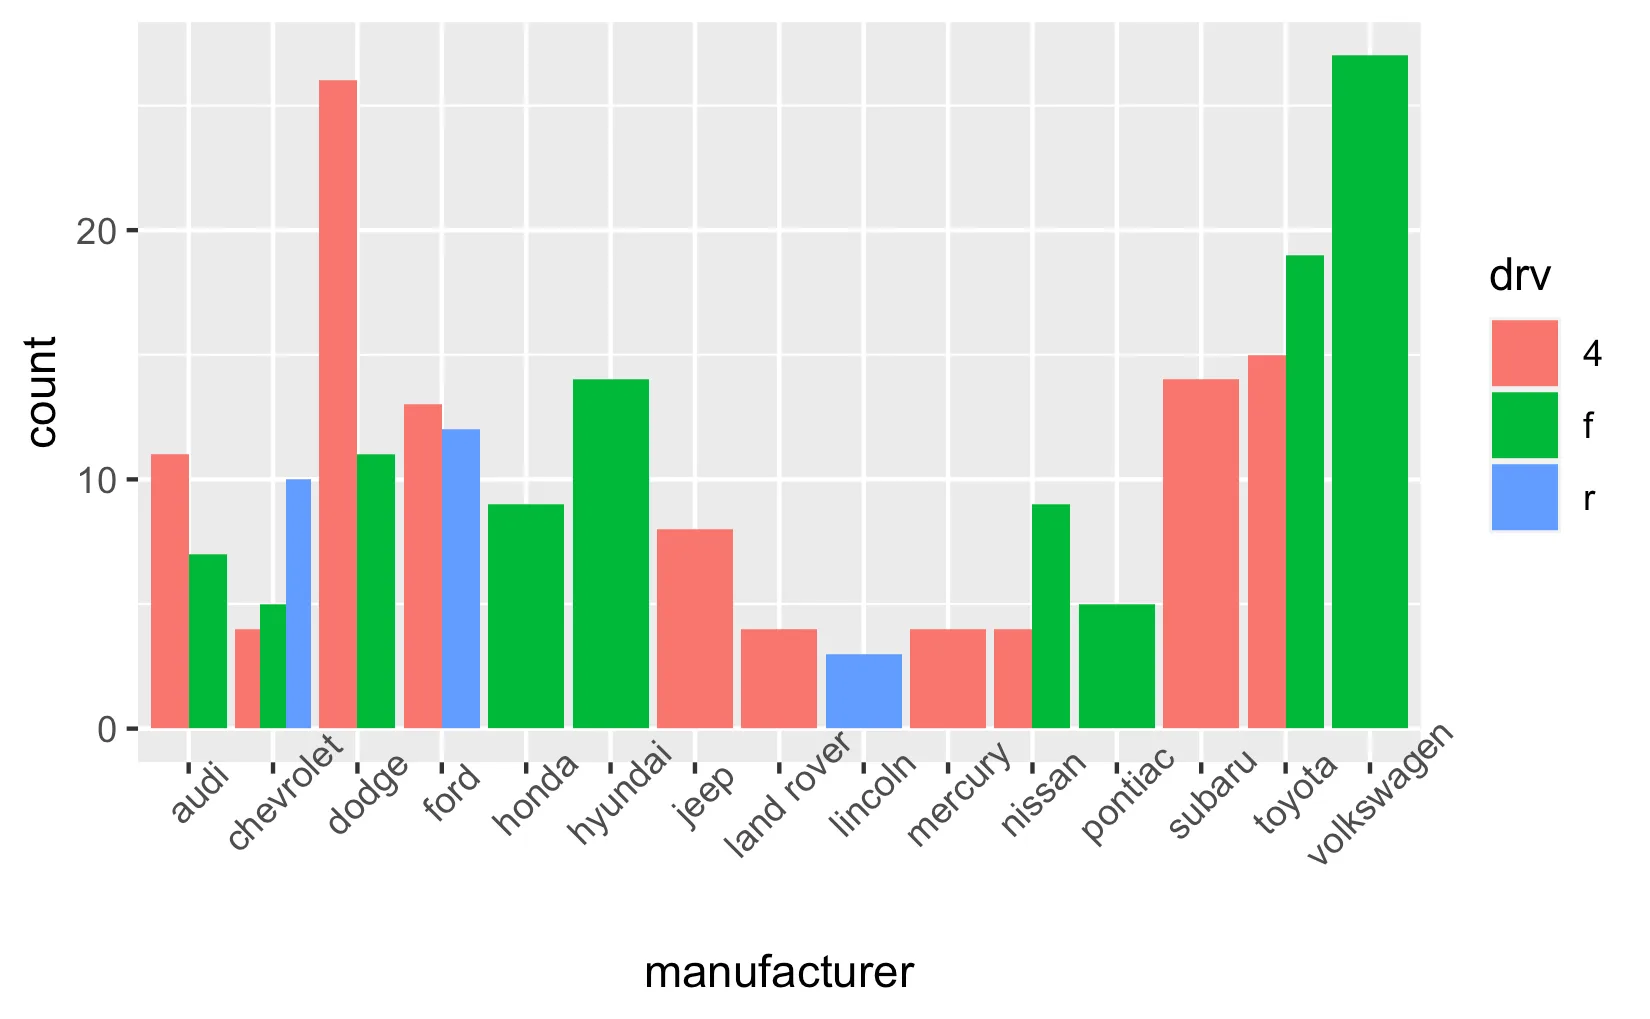
Som det fremgår ovenfor, resulterer position="dodge" i, at segmenterne placeres ved siden af hinanden i stedet for at blive stablet oven på hinanden. Vi fortsætter med position="fill":
mpg |>
  ggplot(aes(x=manufacturer,
             fill=drv)) +
  geom_bar(position="fill") +
  theme(axis.text.x = element_text(angle=45))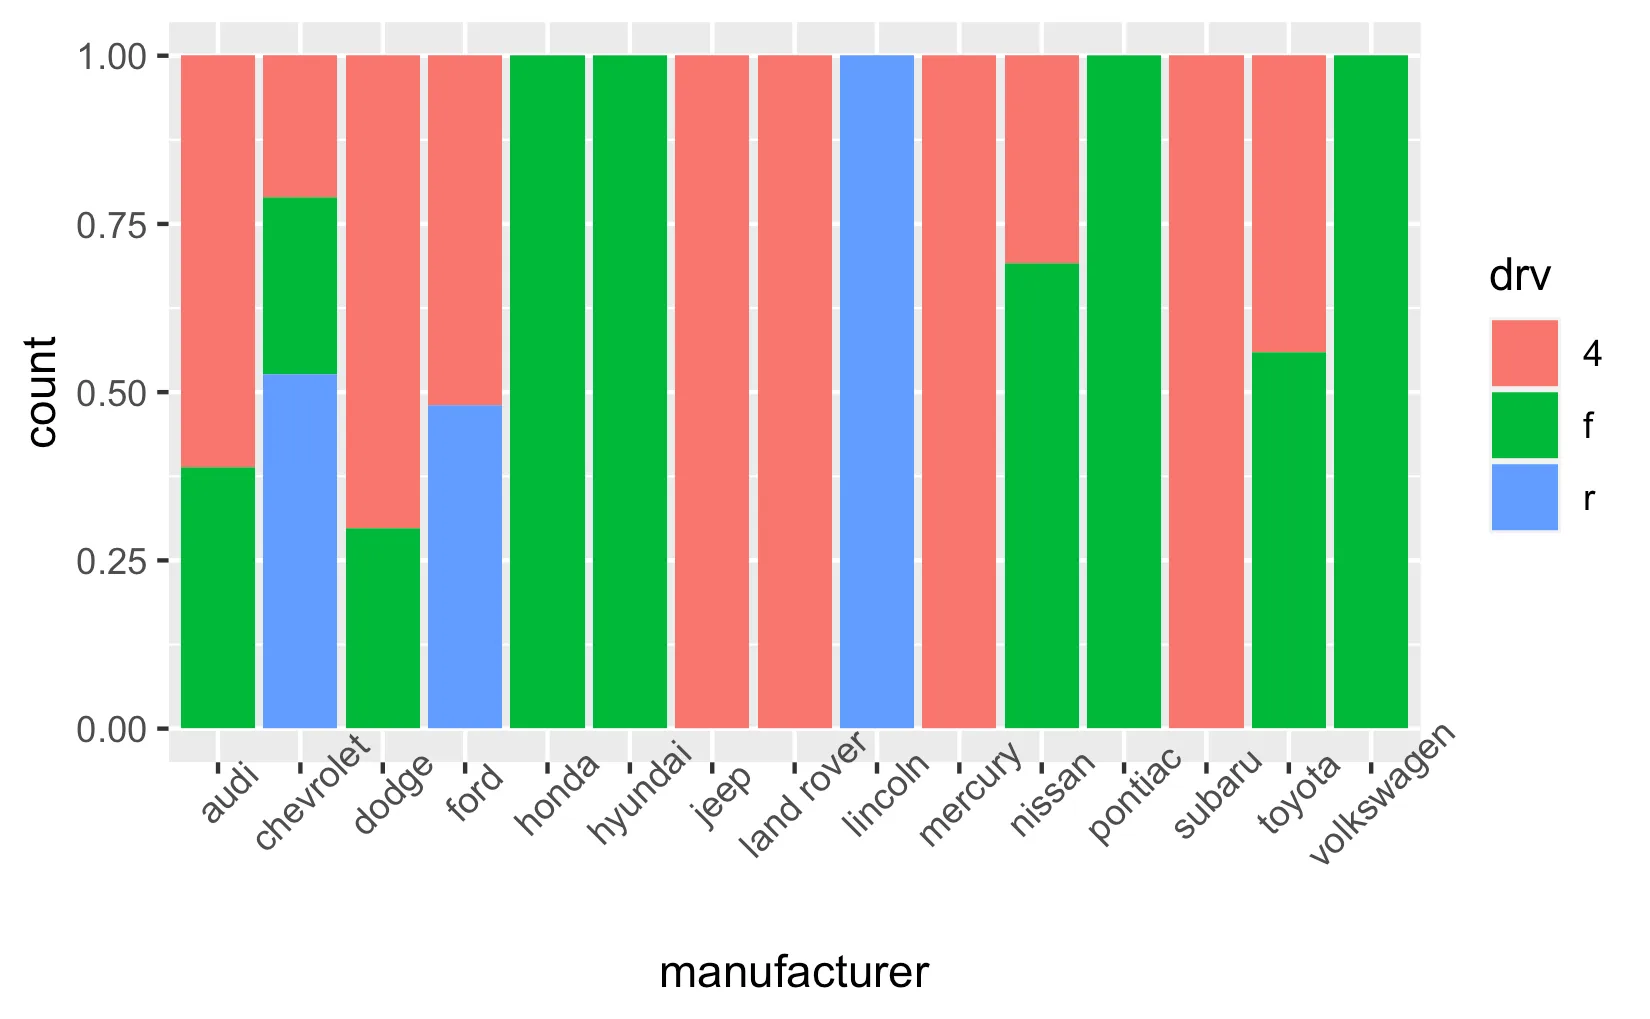
Som det fremgår ovenfor, resulterer position="fill" i, at segmenterne i hver søjle præsenteres som andele (proportioner) i stedet for antal.