Det er vigtigt at få et hurtigt overblik over kolonnerne i en data frame. Denne type analyse bruges til at sikre sig, at alle kolonner har det forventede indhold. Medmindre dataindsamlingen er foregået meget omhyggeligt, er det sandsynligt, at en eller flere variabler ikke har den forventede formatering. Forekomsten af et enkelt ikke-numerisk tegn i en kolonne med datoer eller numeriske værdier er nok til, at hele kolonnen bliver fortolket som en tekstkolonne i R.
Der findes en række forskellige pakker og funktioner til at generere oversigter over data frames. Nedenfor følger en række funktioner med små, men vigtige nuancer.
Vi begynder med pakken mlr, som indeholder funktionen summarizeColumns(). Pakken mlr skal være installeret, for at funktionen kan bruges. Installér og aktivér pakken på følgende måde:
install.packages("mlr")
library(mlr)
mlr har en tendens til at bruge scientific notation, hvilket betyder, at store og små tal skrives ud som eksponenttal; for eksempel skrives 100000000 ud som 1e+08. Du kan slå scientific notation fra med følgende kommando:
## Slå scientific notation fra i R
options(scipen = 999)
Brug derefter funktionen summarizeColumns() til at gennemgå indholdet i vores data frame (rhc):
summarizeColumns(rhc)| name (variabelnavn) | type (variabeltype) | na (antal missing) | mean (middelværdi) | disp (SD for numeriske værdier; kvalitativ variation for kategoriske) | median (medianværdi) | mad (median absolute deviation; NA for kategoriske kolonner) | min (mindste værdi) | max (største værdi) | nlevs (antal niveauer for kategoriske variabler; 0 for numeriske) |
|---|---|---|---|---|---|---|---|---|---|
| adld3p | integer | 4296 | 1.18207088 | 1.819057175 | 0.0000000 | 0.00000000 | 0.00000000 | 7.0000000 | 0 |
| age | numeric | 0 | 61.37588300 | 16.681929290 | 64.0470000 | 16.96239695 | 18.04199000 | 101.8479600 | 0 |
| alb1 | numeric | 0 | 3.09274278 | 0.783276789 | 3.5000000 | 0.29680955 | 0.29998780 | 29.0000000 | 0 |
| amihx | integer | 0 | 0.03487358 | 0.183475574 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| aps1 | integer | 0 | 54.66765475 | 19.956433845 | 54.0000000 | 19.27380000 | 3.00000000 | 147.0000000 | 0 |
| bili1 | numeric | 0 | 2.26706698 | 4.801537560 | 1.0097656 | 0.43001193 | 0.09999084 | 58.1953125 | 0 |
| ca | character | 0 | NA | 0.236442895 | NA | NA | 384.00000000 | 4379.0000000 | 3 |
| card | character | 0 | NA | 0.336704446 | NA | NA | 1931.00000000 | 3804.0000000 | 2 |
| cardiohx | integer | 0 | 0.17663470 | 0.381392509 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| cat1 | character | 0 | NA | 0.565823888 | NA | NA | 7.00000000 | 2490.0000000 | 9 |
| cat2 | character | 4535 | NA | NA | NA | NA | 2.00000000 | 826.0000000 | 6 |
| chfhx | integer | 0 | 0.17802964 | 0.382571052 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| chrpulhx | integer | 0 | 0.18988666 | 0.392245516 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| crea1 | numeric | 0 | 2.13301689 | 2.053079758 | 1.5000000 | 0.88970479 | 0.09999084 | 25.0976562 | 0 |
| das2d3pc | numeric | 0 | 20.49688754 | 5.317185677 | 19.7460900 | 5.46708750 | 11.00000000 | 33.0000000 | 0 |
| death | character | 0 | NA | 0.351002616 | NA | NA | 2013.00000000 | 3722.0000000 | 2 |
| dementhx | integer | 0 | 0.09834350 | 0.297804507 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| dnr1 | character | 0 | NA | 0.114036617 | NA | NA | 654.00000000 | 5081.0000000 | 2 |
| dschdte | integer | 1 | 11660.05040112 | 513.447322056 | 11777.0000000 | 658.27440000 | 10757.00000000 | 12560.0000000 | 0 |
| dth30 | character | 0 | NA | 0.334437663 | NA | NA | 1918.00000000 | 3817.0000000 | 2 |
| dthdte | integer | 2013 | 11753.86915637 | 538.812330065 | 11831.5000000 | 675.32430000 | 10757.00000000 | 12783.0000000 | 0 |
| edu | numeric | 0 | 11.67846146 | 3.145831004 | 12.0000000 | 2.96520000 | 0.00000000 | 30.0000000 | 0 |
| gastr | character | 0 | NA | 0.164254577 | NA | NA | 942.00000000 | 4793.0000000 | 2 |
| gibledhx | integer | 0 | 0.03225806 | 0.176700102 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| hema | character | 0 | NA | 0.061726242 | NA | NA | 354.00000000 | 5381.0000000 | 2 |
| hema1 | numeric | 0 | 31.86547859 | 8.363786134 | 30.0000000 | 6.82227582 | 2.00000000 | 66.1875000 | 0 |
| hrt1 | integer | 0 | 115.17890148 | 41.244941234 | 124.0000000 | 29.65200000 | 0.00000000 | 250.0000000 | 0 |
| immunhx | integer | 0 | 0.26904969 | 0.443504514 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| income | character | 0 | NA | 0.437489102 | NA | NA | 451.00000000 | 3226.0000000 | 4 |
| liverhx | integer | 0 | 0.06992153 | 0.255036968 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| lstctdte | integer | 0 | 11781.25789015 | 524.094168229 | 11868.0000000 | 673.10040000 | 10756.00000000 | 12644.0000000 | 0 |
| malighx | integer | 0 | 0.22946818 | 0.420527489 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| meanbp1 | numeric | 0 | 78.52005231 | 38.046582141 | 63.0000000 | 26.68680000 | 0.00000000 | 259.0000000 | 0 |
| meta | character | 0 | NA | 0.046207498 | NA | NA | 265.00000000 | 5470.0000000 | 2 |
| neuro | character | 0 | NA | 0.120836966 | NA | NA | 693.00000000 | 5042.0000000 | 2 |
| ninsclas | character | 0 | NA | 0.703923278 | NA | NA | 322.00000000 | 1698.0000000 | 6 |
| ortho | character | 0 | NA | 0.001220575 | NA | NA | 7.00000000 | 5728.0000000 | 2 |
| paco21 | numeric | 0 | 38.74897496 | 13.183444618 | 37.0000000 | 8.89560000 | 1.00000000 | 156.0000000 | 0 |
| pafi1 | numeric | 0 | 222.27370952 | 114.953087434 | 202.5000000 | 122.31450000 | 11.59961000 | 937.5000000 | 0 |
| ph1 | numeric | 0 | 7.38841349 | 0.109811941 | 7.3999980 | 0.08890114 | 6.57910200 | 7.7695310 | 0 |
| pot1 | numeric | 0 | 4.06669330 | 1.028353060 | 3.7998050 | 0.74130000 | 1.09985400 | 11.8984380 | 0 |
| psychhx | integer | 0 | 0.06730602 | 0.250573071 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
Du kan kombinere dplyr-funktioner (f.eks. filter, select) med summarizeColumns() for at gennemgå kolonnernes karakteristika i en undergruppe af datasættet. Herunder laver vi tabellen igen, men medtager kun patienter, som ikke havde cancer (ca="No"):
rhc |>
  filter(ca=="No") |>
  summarizeColumns()
Kun de første 4 variabler vises nedenfor.
| name | type | na | mean | disp | median | mad | min | max | nlevs |
|---|---|---|---|---|---|---|---|---|---|
| adld3p | integer | 3258 | 1.16859946 | 1.810469232 | 0.0000000 | 0.00000000 | 0.00000000 | 7.0000000 | 0 |
| age | numeric | 0 | 60.88398987 | 16.971172590 | 63.4929800 | 17.66669125 | 18.14600000 | 101.8479600 | 0 |
| alb1 | numeric | 0 | 3.11450956 | 0.703468345 | 3.5000000 | 0.29680955 | 0.29998780 | 11.0000000 | 0 |
| amihx | integer | 0 | 0.03653802 | 0.187646040 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| ... | ... | ... | ... | ... | ... | ... | ... | ... | ... |
summarizeColumns() genererer ingen information om kategoriske variablers (factors) niveauer. For at få denne information bruges følgende kommando:
summarizeLevels(rhc)$ca
Metastatic No Yes
384 4379 972
$card
No Yes
3804 1931
$cat1
ARF CHF Cirrhosis Colon Cancer Coma COPD
2490 456 224 7 436 457
Lung Cancer MOSF w/Malignancy MOSF w/Sepsis
39 399 1227
$cat2
Cirrhosis Colon Cancer Coma Lung Cancer MOSF w/Malignancy MOSF w/Sepsis
38 2 90 15 229 826
$death
No Yes
2013 3722
$dnr1
No Yes
5081 654
$dth30
No Yes
3817 1918
$gastr
No Yes
4793 942
$hema
No Yes
5381 354
$income
> $50k $11-$25k $25-$50k Under $11k
451 1165 893 3226Screening med Hmisc
Pakken Hmisc indeholder en række nyttige funktioner til eksploration og analyse. Funktionen describe() bruges til at beskrive alle kolonner i en data frame. Begynd med at installere Hmisc og aktivere pakken:
install.packages("Hmisc")
library(Hmisc)
Nu opretter vi objektet rhc_described ved at anvende funktionen describe() på vores data frame. Derefter skriver vi resultatet ud med funktionen html().
rhc_described <- describe(rhc)
html(rhc_described, size = 80)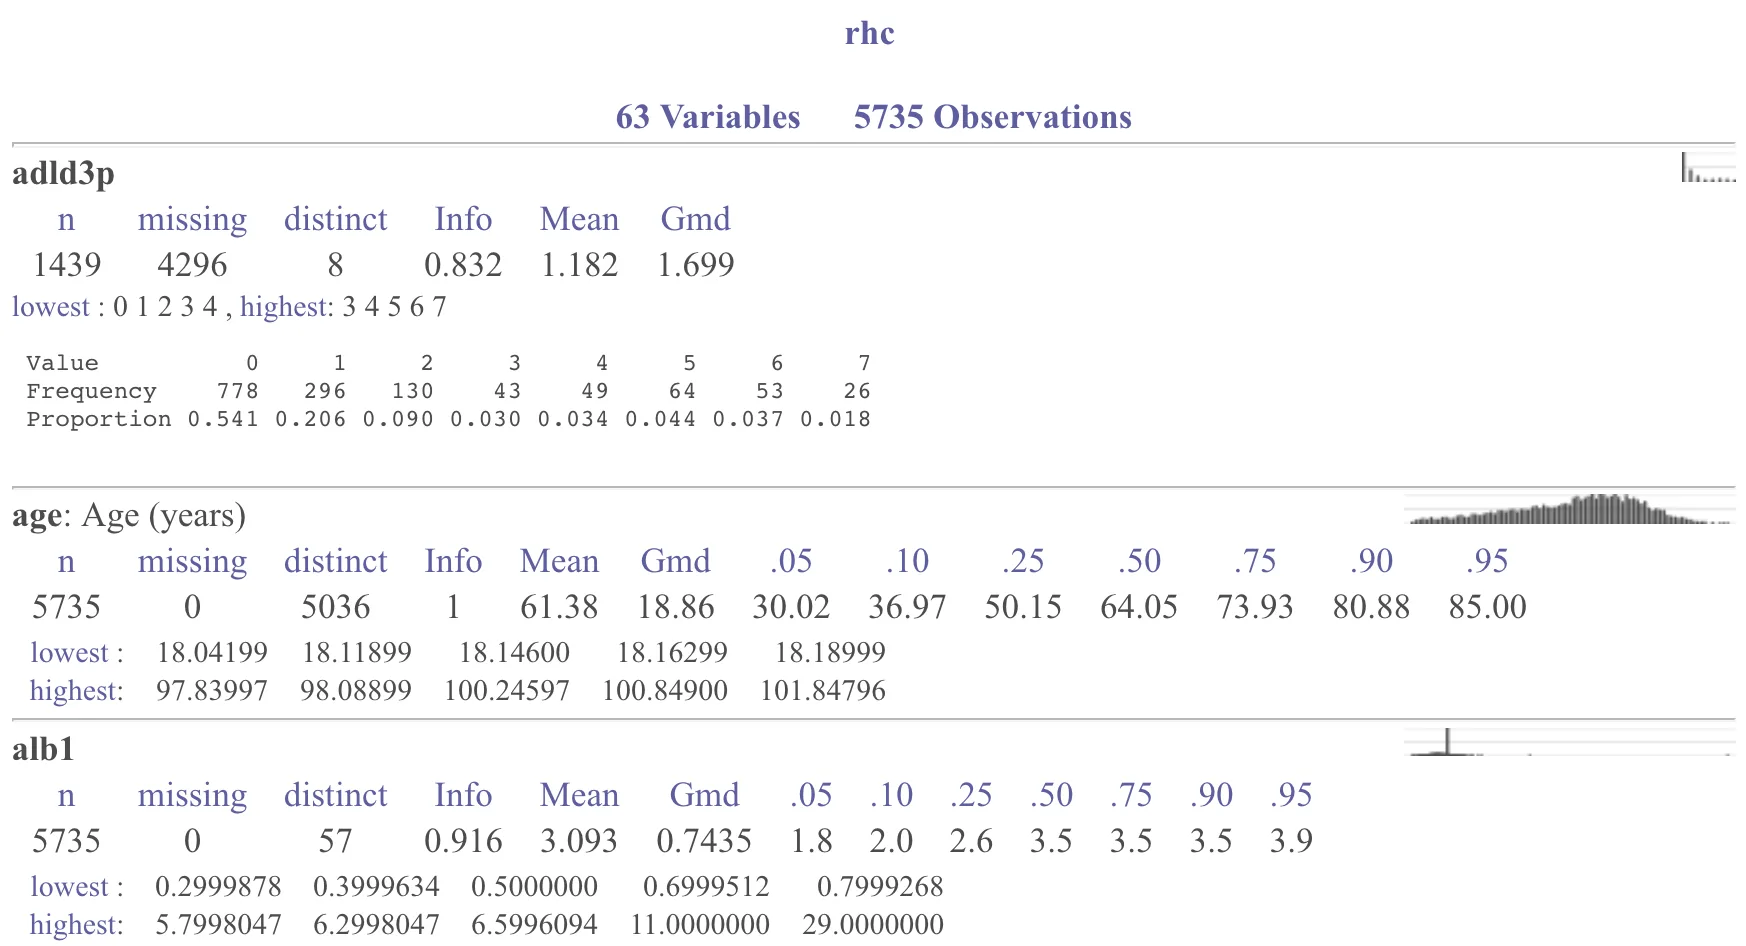
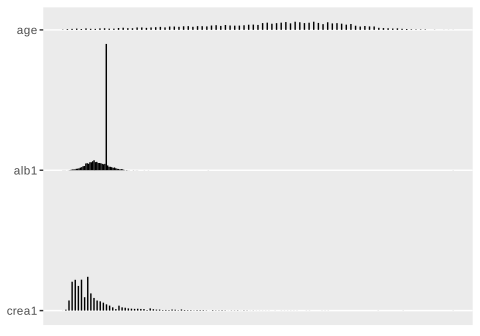
I næste trin bruger vi flere funktioner i Hmisc til at generere frekvensdiagrammer og histogrammer. Se kommentarerne i koden for detaljer:
## Anvender funktionen plot() på vores objekt rhc_described
rhc_described_plots <- plot(rhc_described)

## Undersøger fordelinger i kategoriske data
rhc_described_plots$Categorical

## Undersøger histogrammer for kontinuerte data
rhc_described_plots$Categorical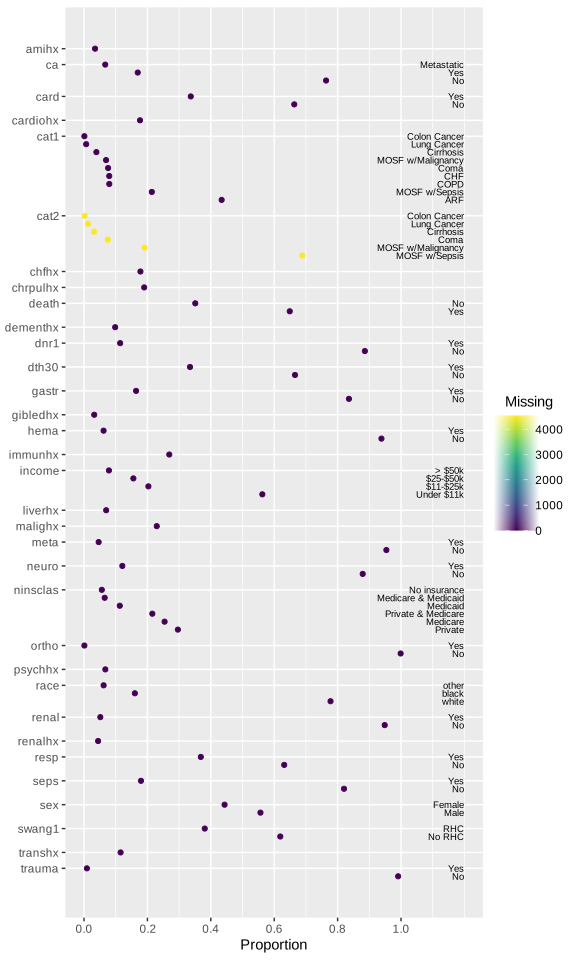
Generér kolonnedata stratificeret efter en kategorisk variabel
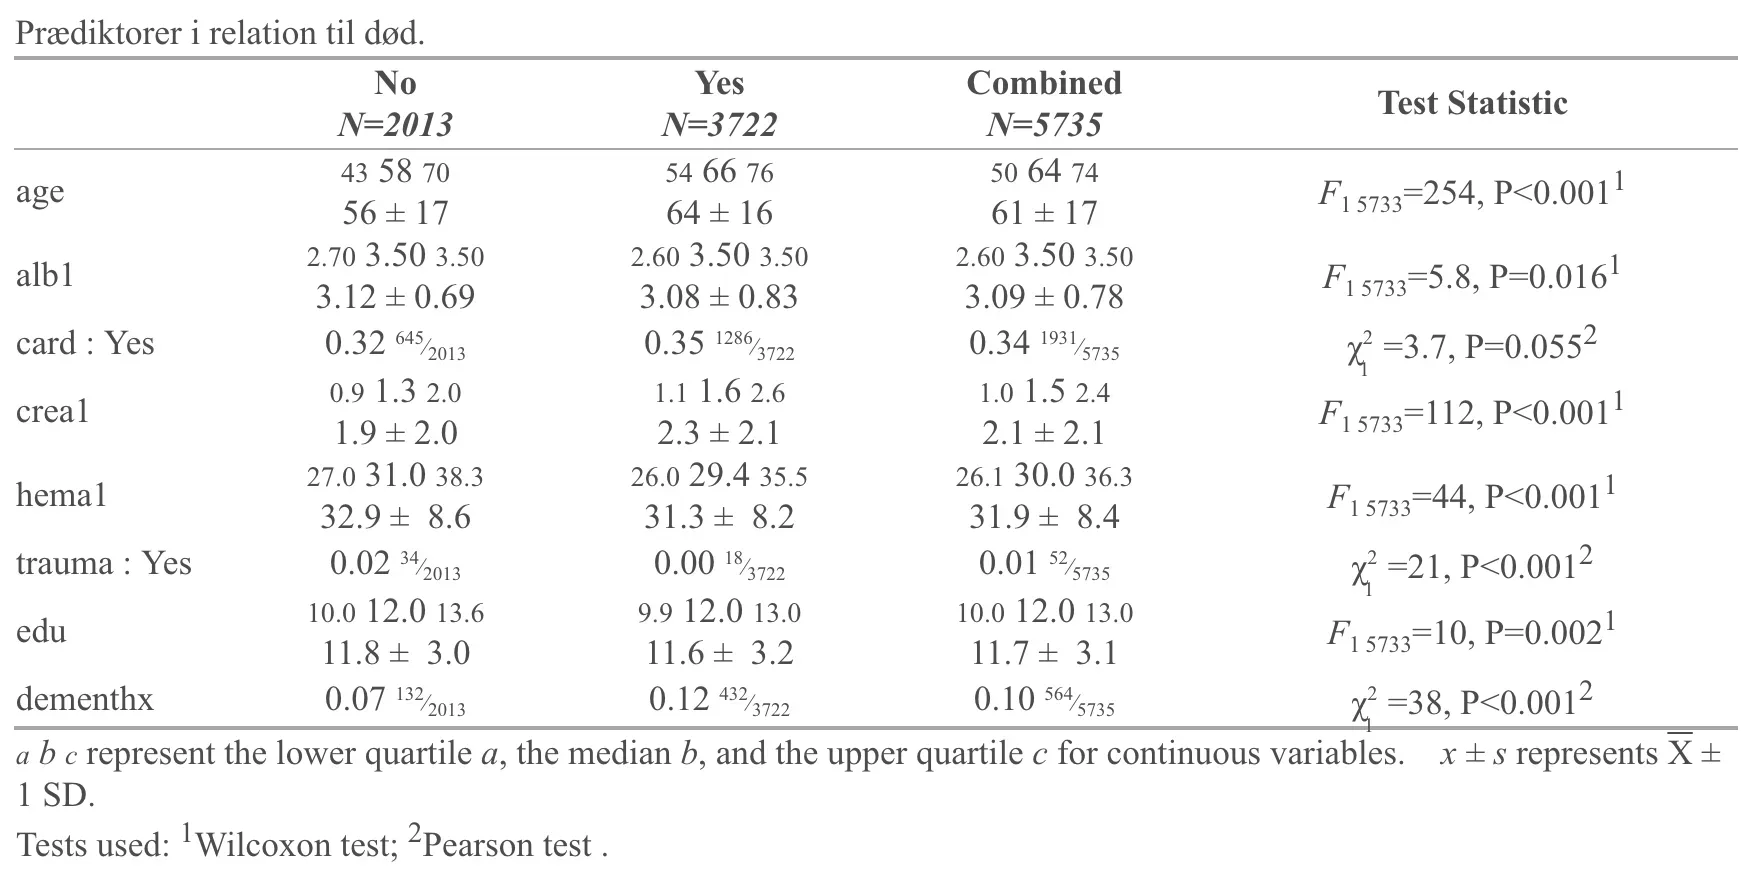
Hmisc indeholder funktionen summaryM(), som viser variablernes karakteristika stratificeret efter en kategorisk variabel. Den kategoriske variabel er typisk et udfaldsmål (event, outcome) i studiet. Funktionen summaryM() er speciel, idet den bruger en formel til at angive de variabler, der skal vises. Funktionen beregner også forskellige typer hypotesetest for gruppeforskelle. Om sådanne hypotesetest (P-værdier) er nyttige eller ej, afhænger af konteksten. Det er oftest uhensigtsmæssigt at udføre hypotesetest rutinemæssigt på jagt efter gruppeforskelle eller for at identificere, hvilke variabler der skal inkluderes i en statistisk model.
Herunder demonstreres funktionen. Bemærk, at de variabler, vi vil undersøge, placeres til venstre for tilde (~), adskilt af +, og outcome placeres til højre for ~. Vi anvender funktionen html() på resultatet for at få et æstetisk tiltalende resultat.
rhc_summary <- summaryM(age + alb1 + card + crea1 + hema1 + trauma + edu + dementhx ~ death,
              data = rhc,
              overall = TRUE,
              test = TRUE)

html(rhc_summary,
     caption='Prediktorer i relation till död',
     exclude1 = TRUE,
     npct = 'both',
     digits = 2,
     prmsd = TRUE,
     brmsd = TRUE)