
Strenge og regular expressions (regex)
Strenge er information, der består af tal, symboler og/eller bogstaver. En streng kan således være en blanding af disse komponenter. I R defineres en streng ved hjælp af anførselstegn. Nedenfor defineres en streng, som gemmes i objektet my_string:
## Gem en streng i et objekt
my_string <- "Detta är en sträng!"

## Udskriv objektet
my_string[1] "Detta är en sträng!"Før vi går videre, aktiverer vi pakken tidyverse, som inkluderer pakken stringr, der indeholder alle de funktioner, der er nødvendige for at håndtere strenge.
library(tidyverse)── Attaching packages ─────────────────────────────────────── tidyverse 1.3.2 ──
ggplot2 3.3.6 purrr 0.3.4
tibble 3.1.8 dplyr 1.0.10
tidyr 1.2.0 stringr 1.4.1
readr 2.1.2 forcats 0.5.1
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
dplyr::filter() masks stats::filter()
dplyr::lag() masks stats::lag()Flere strenge kan defineres med funktionen [c()](https://rdrr.io/r/base/c.html), som kombinerer flere elementer til en vektor:
my_string <- c("Detta är en sträng!", "Detta är en annan sträng")

my_string[1] "Detta är en sträng!" "Detta är en annan sträng"Strengene ovenfor blev oprettet med dobbelte anførselstegn (" "). Strenge kan bestå af et enkelt tegn eller indeholde hele bøger. Herunder defineres tre strenge: en kort streng (my_string_short), en streng, der udelukkende består af tal (my_string_numbers), og en lang streng (my_string_long):
## En kort streng
my_string_short <- c("Detta är en sträng!")

## En streng udelukkende med tal
my_string_numbers <- c("123")

## En lang streng
my_string_long <- c("Salvador Domingo Felipe Jacinto Dalí i Domènech, 1:e markis av Púbol, född 11 maj 1904 i Figueres, Katalonien, Spanien, död 23 januari 1989 i Figueres, var en katalansk (spansk) surrealistisk konstnär. Dalí är mest känd för sina bisarra, absurda och drömska målningar, influerade av bland annat Freuds psykoanalys, Einsteins relativitetsteorier och renässansmåleri.[2][3] Ett av hans mest kända verk, Minnets envishet, blev klart 1931. Utöver måleri omfattade Dalís praktik även film, skulptur, fotografi och text. Han samarbetade med Walt Disney kring den Oscars-nominerade tecknade kortfilmen Destino, som släpptes postumt 2003. Han samarbetade också med Alfred Hitchcock i arbetet med filmen Trollbunden.")
Strenge og anførselstegn
Brug dobbelte anførselstegn (""), når du definerer en streng. Brug kun enkelte anførselstegn ('') til at definere en streng, der indeholder dobbelte anførselstegn.
En streng kan også oprettes med enkelte anførselstegn (' '):
my_string <- c('Detta är en sträng!')
my_string[1] "Detta är en sträng!"Det anbefales dog, at strenge defineres med dobbelte anførselstegn.
Lad os prøve at definere en streng, der indeholder anførselstegn:
my_string <- c("Han fick smeknamnet "Yoggi" men det gillade han inte")
my_stringError: unexpected symbol in "my_string <- c("Han fick smeknamnet "Yoggi"Der opstår Error (fejl), fordi R ikke ved, hvordan anførselstegnene omkring Yoggi ("Yoggi") skal fortolkes. Det skyldes, at anførselstegn har en særlig betydning i strenge, nemlig at markere strengens start og slutning. R tror, at strengen slutter ved det første anførselstegn før bogstavet Y ("Y..), men da dette anførselstegn efterfølges af flere bogstaver, opstår der Error. Vi har derfor brug for en metode til at fortælle R, at anførselstegnene i strengen faktisk er en del af strengen og ikke et tegn med en særlig funktion! Der findes flere tegn (., *, ] osv.), som kan forårsage en sådan tvetydighed, så der opstår Error.
For at undgå denne tvetydighed bruges omvendt skråstreg (\, backslash*). Backslash fortæller R, at anførselstegnene omkring “Yoggi” skal betragtes som en del af strengen. Det betyder, at **backslash (\) bruges til at undslippe (eng. escape) anførselstegnets særlige funktion*. Lad os prøve at indlæse strengen igen, men denne gang med \ foran hvert anførselstegn i strengen:
my_string <- c("Han fick smeknamnet \"Ylle\" men det gillade han inte")Det virkede uden Error! Lad os udskrive strengen:
my_string[1] "Han fick smeknamnet \"Ylle\" men det gillade han inte"Bemærk, at backslash (\) er markeret, når strengen udskrives. Årsagen er, at R angiver, hvor escape er blevet brugt. Hvis du vil udskrive (*eng*. print) en streng uden escape (\), bruger du funktionen [writeLines()](https://rdrr.io/r/base/writeLines.html):
writeLines(my_string)Han fick smeknamnet "Ylle" men det gillade han intePå samme måde skal enkelte anførselstegn have \ foran for at undgå tvetydighed:
my_string <- c('Han fick smeknamnet \'Ylle\' men det gillade han inte')
writeLines(my_string)
Han fick smeknamnet 'Ylle' men det gillade han inteNetop for anførselstegn kan man også undgå tvetydighed ved at bruge dobbelte anførselstegn til at definere strengen og enkelte anførselstegn inde i strengen, eller omvendt. Her følger et eksempel:
my_string1 <- c("Han fick smeknamnet 'Svurre' men det gillade han inte")
writeLines(my_string)
Han fick smeknamnet 'Svurre' men det gillade han intemy_string2 <- c('Han fick smeknamnet "Svurre" men det gillade han inte')
writeLines(my_string)Han fick smeknamnet 'Svurre' men det gillade han inteNedenstående tabel viser andre specialtegn og formateringer, hvor escape er nødvendig for at undgå tvetydighed:
| Escape character | Betydning |
|---|---|
| \n | newline |
| \r | carriage return |
| \t | tab |
| \b | backspace |
| \a | alert (bell) |
| \f | form feed |
| \v | vertical tab |
| \\ | backslash \ |
| \’ | ASCII apostrophe ’ |
| \” | ASCII quotation mark ” |
| \` | ASCII grave accent (backtick) ` |
| \nnn | character with given octal code (1, 2 or 3 digits) |
| \xnn | character with given hex code (1 or 2 hex digits) |
| \unnnn | Unicode character with given code (1--4 hex digits) |
| \Unnnnnnnn | Unicode character with given code (1--8 hex digits) |
8.1 Stringr og regular expressions (regex)
Pakken stringr indeholder alle de nødvendige funktioner til at håndtere strenge i R. Nedenfor gennemgås de vigtigste funktioner og derefter, hvordan regular expressions kan bruges til at lave effektive matchninger i strenge. De fleste funktioner i stringr har præfikset str_. Lad os begynde med at definere en streng:
my_string <- c("Det är roligt att lära sig R!")8.1.1 Identiske strenge
Vi opretter nu to vektorer, der består af en identisk streng (“Sommarlov”), og bruger funktionen [identical()](https://rdrr.io/r/base/identical.html) til at afgøre, om de er identiske:
word_1 <- "Sommarlov"
word_2 <- "Sommarlov"
identical(word_1, word_2)[1] TRUESom ved mange andre R-funktioner kan du bruge udråbstegn (!) foran funktionens navn for at få den modsatte effekt. Hvis funktionen [identical()](https://rdrr.io/r/base/identical.html) afgør, om to strenge er identiske, så afgør [identical()](https://rdrr.io/r/base/identical.html), om strengene ikke er identiske. Vi undersøger nu, om ordene ikke er identiske:
!identical(word_1, word_2)[1] FALSE8.1.2 Ændre store og små bogstaver
Med funktionerne [str_to_lower()](https://stringr.tidyverse.org/reference/case.html), [str_to_sentence()](https://stringr.tidyverse.org/reference/case.html), [str_to_title()](https://stringr.tidyverse.org/reference/case.html) og [str_to_upper()](https://stringr.tidyverse.org/reference/case.html) i pakken stringr kan du ændre brugen af store og små bogstaver i en streng på følgende måde:
## Konverterer bogstaver til små bogstaver
str_to_lower(my_string)[1] "det är roligt att lära sig r!"## Konverterer strengen til sætning
str_to_sentence(my_string)[1] "Det är roligt att lära sig r!"## Konverterer strengen til titelform
str_to_title(my_string)[1] "Det Är Roligt Att Lära Sig R!"## Konverterer bogstaver til store bogstaver
str_to_upper(my_string)[1] "DET ÄR ROLIGT ATT LÄRA SIG R!"8.1.3 Længden af en streng
Længden (antal tegn) af en streng kan beregnes med [str_length()](https://stringr.tidyverse.org/reference/str_length.html):
str_length(my_string)[1] 29Som alle andre funktioner i stringr er [str_length()](https://stringr.tidyverse.org/reference/str_length.html) vektoriseret, hvilket betyder, at hvis du anvender den på en vektor, udføres beregningen på hvert element i vektoren:
str_length(c("Hej", "Ja", "Kanske"))[1] 3 2 68.1.4 Placeringer i strenge
Vi kan identificere, hvor i strengen et bestemt tegn er placeret. Det gøres med funktionen [str_locate()](https://stringr.tidyverse.org/reference/str_locate.html). Følgende eksempel beregner, på hvilken position bogstavet “t” findes, hvis det forekommer:
my_string <- c("Det är roligt att lära sig R!")
str_locate(my_string, 't')
start end
[1,] 3 3Ifølge resultatet blev “t” matchet mellem position 3 og 3, hvilket betyder, at bogstavet er det tredje tegn i strengen. Bemærk dog, at der er flere “t” i strengen, og for at identificere dem alle skal vi bruge funktionen [str_locate_all()](https://stringr.tidyverse.org/reference/str_locate.html):
str_locate_all(my_string, 't')[[1]]
     start end
[1,]     3   3
[2,] 13 13
[3,] 16 16
[4,] 17 17Vi ser, at der i alt er 4 “t”, og at de forekommer som tegn 3, 13, 16 og 17.
8.1.5 Sortere strenge
For at sortere en character-vektor bruges funktionen [str_sort()](https://stringr.tidyverse.org/reference/str_order.html):
my_names <- c('Benny', 'Adam', 'Caesar')
str_sort(my_names)[1] "Adam" "Benny" "Caesar"Nu opretter vi en data frame med fornavne og efternavne. Fremover vil vi bruge funktioner fra pakken dplyr til at oprette og modificere kolonner.
## Opretter fornavne
first_name <- c('Maria', 'Mohammed', 'Magnus')

## Opretter efternavne
last_name <- c('Svensson', 'Ayman', 'Bentzel')

## Kombinerer til en tibble (data frame)
my_data <- tibble(first_name, last_name)

## Udskriver vores data frame
my_data
## A tibble: 3 × 2
first_name last_name
<chr> <chr>
1 Maria Svensson
2 Mohammed Ayman
3 Magnus Bentzel8.1.6 Kombinere strenge
Vi slår fornavn og efternavn sammen til én streng med funktionen [str_c()](https://stringr.tidyverse.org/reference/str_c.html). Funktionen har argumentet sep, som angiver, hvilket tegn der skal adskille strengene. Vi vælger at adskille strengene med et mellemrum.
Eksempel med base R (ikke dplyr):
my_data$full_name <- str_c(my_data$first_name,
                           my_data$last_name,
                           sep = " ")

my_data
## A tibble: 3 × 3
first_name last_name full_name
<chr> <chr> <chr>
1 Maria Svensson Maria Svensson
2 Mohammed Ayman Mohammed Ayman
3 Magnus Bentzel Magnus BentzelEksempel med dplyr:
my_data %>%
  mutate(full_name = str_c(first_name, last_name, sep = " "))
## A tibble: 3 × 3
first_name last_name full_name
<chr> <chr> <chr>
1 Maria Svensson Maria Svensson
2 Mohammed Ayman Mohammed Ayman
3 Magnus Bentzel Magnus BentzelVed at bruge dplyr får vi ren og enkel kode uden at bruge $, [] eller lignende. Nye kolonner oprettes med funktionen mutate().
Du kan sætte flere end to strenge sammen med [str_c()](https://stringr.tidyverse.org/reference/str_c.html):
a = "Hej"
b = "jag"
c = "heter"
d = "Adam"

str_c(a, b, c, d, sep = " ")[1] "Hej jag heter Adam"8.1.7 Tælle antal matchninger i en streng
Med [str_count()](https://stringr.tidyverse.org/reference/str_count.html) kan vi beregne, hvor mange gange en bestemt streng eller et bestemt tegn forekommer i en streng. Lad os undersøge, hvor mange gange bogstavet ‘m’ forekommer i fornavnene. Vi opretter til det formål en ny variabel, som vi kalder antal_m:
my_data %>%
  mutate(antal_m = str_count(first_name, 'm'))
## A tibble: 3 × 4
first_name last_name full_name antal_m
<chr> <chr> <chr> <int>
1 Maria Svensson Maria Svensson 0
2 Mohammed Ayman Mohammed Ayman 2
3 Magnus Bentzel Magnus Bentzel 0R skelner mellem store og små bogstaver. Bogstavet m er ikke ækvivalent med bogstavet M. Vi prøver igen med bogstavet M:
my_data %>%
  mutate(antal_m = str_count(first_name, 'M'))
## A tibble: 3 × 4
first_name last_name full_name antal_m
<chr> <chr> <chr> <int>
1 Maria Svensson Maria Svensson 1
2 Mohammed Ayman Mohammed Ayman 1
3 Magnus Bentzel Magnus Bentzel 18.1.8 Detektere strenge, tegn og symboler i strenge
Med funktionen [str_detect()](https://stringr.tidyverse.org/reference/str_detect.html) kan vi afgøre, om tal, bogstaver, symboler, tegn eller strenge forekommer i en streng. Funktionen [str_detect()](https://stringr.tidyverse.org/reference/str_detect.html) returnerer en boolsk værdi (TRUE, FALSE). Vi opretter nu variablen finns_m, som angiver, om bogstavet "m" findes i strengen:
my_data %>%
  mutate(finns_m = str_detect(first_name, 'm'))
## A tibble: 3 × 4
first_name last_name full_name finns_m
<chr> <chr> <chr> <lgl>
1 Maria Svensson Maria Svensson FALSE
2 Mohammed Ayman Mohammed Ayman TRUE
3 Magnus Bentzel Magnus Bentzel FALSEMed funktionerne string_ends() og string_starts() kan man afgøre, om en streng begynder eller slutter med en bestemt streng. Vi undersøger, om strengen begynder med M og slutter med s. Vi opretter to nye variabler, som angiver dette:
my_data %>%
  mutate(starts_M = str_starts(first_name, 'M'),
         ends_s = str_ends(first_name, 's'))
## A tibble: 3 × 5
first_name last_name full_name starts_M ends_s
<chr> <chr> <chr> <lgl> <lgl>
1 Maria Svensson Maria Svensson TRUE FALSE
2 Mohammed Ayman Mohammed Ayman TRUE FALSE
3 Magnus Bentzel Magnus Bentzel TRUE TRUE8.1.9 Erstat strenge og tegn
Erstat hele eller dele af en streng med funktionen [str_replace()](https://stringr.tidyverse.org/reference/str_replace.html). Nu erstatter vi bogstavet M med en asterisk (*):
my_data %>%
  mutate(new_first_name = str_replace(first_name, 'M', '*'))
## A tibble: 3 × 4
first_name last_name full_name new_first_name
<chr> <chr> <chr> <chr>
1 Maria Svensson Maria Svensson *aria
2 Mohammed Ayman Mohammed Ayman *ohammed
3 Magnus Bentzel Magnus Bentzel *agnusFunktionen [str_replace()](https://stringr.tidyverse.org/reference/str_replace.html) erstatter kun den første instans (forekomst) af det mønster, du søger efter. Brug funktionen [str_replace_all()](https://stringr.tidyverse.org/reference/str_replace.html) til at erstatte alle instanser. Nedenfor erstatter vi alle m med *:
my_data %>%
  mutate(new_first_name = str_replace_all(first_name, 'm', '*'))
## A tibble: 3 × 4
first_name last_name full_name new_first_name
<chr> <chr> <chr> <chr>
1 Maria Svensson Maria Svensson Maria
2 Mohammed Ayman Mohammed Ayman Moha**ed
3 Magnus Bentzel Magnus Bentzel Magnus8.1.10 Erstat NA med “NA”
Missing data er den engelske betegnelse for information, der mangler. Oftest bruges blot ordet missing om data, der mangler. Missing betegnes med NA (Not Available) i R. Vi kan oprette missing i en character-vektor ved at angive værdien som NA uden anførselstegn:
x <- c("abc", NA)
x[1] "abc" NABemærk, at strengen “abc” er omgivet af anførselstegn for at angive, at det er en streng. NA er derimod ikke omgivet af anførselstegn, fordi det er missing. Vi kan erstatte missing (NA) med strengen NA (“NA").
x <- c("abc", NA)
str_replace_na(x)[1] "abc" "NA"8.1.11 Udtrække dele af strenge (substring)
Funktionen [str_sub()](https://stringr.tidyverse.org/reference/str_sub.html) kan udtrække dele af strenge. Funktionen har argumenterne start og end, som angiver, hvor udtrækningen begynder og slutter. Her udtrækker vi første til anden position:
x <- c("Sommarlov")
str_sub(string=x, start=1, end=2)[1] "So"Som sædvanlig kan vi angive værdier for argumenterne string, start og end uden at angive argumenternes navne, forudsat at vi angiver værdierne i den rigtige rækkefølge:
x <- c("Sommarlov")
str_sub(x, 1, 2)[1] "So"Negative start og end angiver, at udtrækningen begynder i slutningen af strengen. Her udtrækker vi alle tegn fra det næstsidste til det sidste:
x <- c("Sommarlov")
str_sub(x, -2, -1)[1] "ov"Hvis du forsøger at udtrække mere, end der findes i strengen, vil [str_sub()](https://stringr.tidyverse.org/reference/str_sub.html) returnere så meget som muligt:
x <- c("Sommarlov")
str_sub(x, 1, 100)[1] "Sommarlov"8.2 Regular expressions (Regex)
I praksis kan du få brug for at lave endnu mere sofistikerede matchninger, og da er regular expressions uvurderlige. Regular expressions (regex) er en sekvens af tegn, der søger efter et mønster i en streng.
Andre ressourcer om regular expressions:
- https://www.regular-expressions.info/ giver detaljeret information om, hvordan regular expressions fungerer.
- https://regex101.com er et interaktivt værktøj, som lader dig teste dine regular expressions live for at se, om de opfører sig, som du forventer.
Regular expressions kan ved første øjekast virke komplicerede, men når du har forstået, hvordan de fungerer, vil du indse, at de er ekstremt effektive til at håndtere strenge. Ofte kræves der en del afprøvning, før man har et fungerende regular expression, og for at se, hvordan dit regular expression matcher tegnene i en streng, findes funktionerne [str_view()](https://stringr.tidyverse.org/reference/str_view.html) og [str_view_all()](https://stringr.tidyverse.org/reference/str_view.html). De viser, hvordan regular expressions matcher en streng. Funktionerne markerer den del af strengen, der matcher dit regular expression. Vi bruger nu funktionen til at se, om vores regular expression identificerer bogstavet X i strengene nedenfor. Den streng, der skal gennemsøges, angives i argumentet string, og det mønster, vi vil finde, angives i pattern:
my_strings <- c("Xxx", "Yyy", "Xxx")
str_view(string=my_strings, pattern='X')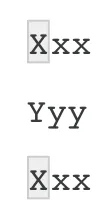
Den lodrette streg (|) betyder “eller”. Med den lodrette streg kan vi lede efter forskellige tegn, og kun ét af dem behøver at blive matchet. Nedenfor angiver vi pattern='X|x', hvilket betyder, at vi leder efter X eller x.
my_strings <- c("Xxx", "xXx")
str_view(string=my_strings, pattern='X|x')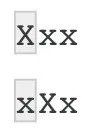
Som det fremgår ovenfor, blev kun det første X eller x matchet, hvilket skyldes, at vi brugte [str_view()](https://stringr.tidyverse.org/reference/str_view.html). Funktionen [str_view_all()](https://stringr.tidyverse.org/reference/str_view.html) kan matche alle forekomster af en streng. Her følger et eksempel:
my_strings <- c("Xxx", "xXx")
str_view_all(string=my_strings, pattern='X|x')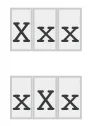
Med funktionerne [str_view()](https://stringr.tidyverse.org/reference/str_view.html) og [str_view_all()](https://stringr.tidyverse.org/reference/str_view.html) kan du altså se, hvordan et regular expression (regex) matcher en streng. Her følger et eksempel, hvor vi bruger [str_view()](https://stringr.tidyverse.org/reference/str_view.html) til at undersøge, om vores regular expression kan matche H i begyndelsen af en streng. I regular expressions bruges ^ til at angive begyndelsen af en streng. For at matche H i begyndelsen af en streng skrives derfor følgende:
str_view(string='Hej', pattern='^H')
Det ser ud til, at vores regular expression matcher H som forventet.
Punktum (.) er et regular expression, der matcher hvilket som helst tegn. Nedenfor tester vi, om vi kan matche A. med nogen af flere strenge i en vektor:
my_strings <- c("A", "AB", "ABC")
str_view(my_strings, 'A.')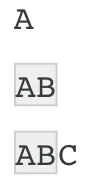
Den første streng A matches ikke, fordi der ikke er noget tegn efter A. Strengene AB og ABC matches, fordi de indeholder A efterfulgt af endnu et tegn.
I det næste eksempel har vi strengen X.X, som vi vil matche præcist. Punktummet skal ikke behandles som et specialtegn, men matches præcist. Hvis det blot havde været en streng, kunne vi have matchet på X\.X, men da vi vil bruge regex til at matche, skal vi tilføje endnu en backslash \, hvilket skyldes, at regex også bruger dette symbol som escape-symbol. Derfor kræves følgende kode for at matche X.X præcist:
Hvis du i stedet vil matche præcist “A.C”, skal escape (\) bruges på følgende måde:
my_strings <- c("X.X")
str_view(my_strings, "X\\.X")
Hvordan matches \ i en streng med regular expression? Først og fremmest skal \ fortolkes som et almindeligt tegn (uden særlig funktion), hvilket kræver endnu en \. Vi begynder med at skrive et fornavn og et efternavn adskilt af \\. Det burde give én \, når vi udskriver det med [writeLines()](https://rdrr.io/r/base/writeLines.html):
my_string <- "Monika \\ Svensson"
writeLines(my_string)
Monika \ SvenssonVi har altså brug for to backslash (\\) for at få en streng med én backslash. For at oprette et regex kræves nu endnu en backslash pr. backslash. For at matche en backslash i en streng kræves altså følgende kode:
str_view(my_string, "\\\\")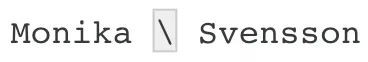
Det betyder, at da regular expressions og strenge bruger det samme escape-symbol (\), kræves der dobbelte escapes, når du bruger regular expressions til særlige tegn og symboler. Det er muligt at undgå escape på selve tegnet og kun angive escape for regular expression ved at bruge [raw()](https://rdrr.io/r/base/raw.html). Det står for raw vectors,
str_view(my_string, r"(\\)")For at matche en asterisk (*) gælder samme princip:
str_view(string=c("abc", "a.c", "a*c", "a c"), pattern="\\*")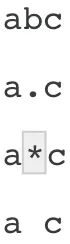
Der findes flere regular expressions til at matche i strenge, og de kan kombineres. De er som følger:
| Sequence | Matches |
|---|---|
. |
Any character except newline |
[xyz] |
Any character listed between the brackets (x, y, and z in this example) |
[a-z] |
Any character between a and z, inclusive |
[^xyz] |
The opposite of [xyz] |
\d |
ASCII digits (0 through 9, inclusive) |
\D |
Anything except ASCII digits |
\s |
ASCII spaces (space, tab, newline, carriage return, form feed) |
\S |
Anything except ASCII spaces |
\w |
The same as [0-9A-Za-z_] |
\W |
Anything except the characters matched by \w |
[[:alnum:]] |
The same as [0-9A-Za-z] |
[[:alpha:]] |
The same as [A-Za-z] |
[[:ascii:]] |
Any ASCII character |
[[:blank:]] |
ASCII tab or space |
[[:cntrl:]] |
ASCII/Unicode control characters |
[[:digit:]] |
The same as [0-9] |
[[:graph:]] |
All “graphical” (printable) ASCII characters |
[[:lower:]] |
The same as [a-z] |
[[:print:]] |
The same as [[:graph:]] |
[[:punct:]] |
The same as [!-/:-@[-`{-~] |
[[:space:]] |
The same as [\t\n\v\f\r ] |
[[:upper:]] |
The same as [A-Z] |
[[:word:]] |
The same as \w |
[[:xdigit:]] |
The same as [0-9A-Fa-f] |
\pN |
Unicode character class by using single-letter class names (“N” in this example) |
\p{Greek} |
Unicode character class by unicode name (“Greek” in this example) |
\PN |
The opposite of \pN |
\P{Greek} |
The opposite of \p{Greek} |
xy |
x followed immediately by y |
x|y |
either x or y, preferring x |
x* |
zero or more x, preferring more |
x*? |
zero or more x, preferring fewer |
x+ |
one or more x, preferring more |
x+? |
one or more x, preferring fewer |
x? |
zero or one x, preferring one |
x?? |
zero or one x, preferring zero |
x{n,m} |
between n and m repetitions of x, preferring more |
x{n,m}? |
between n and m repetitions of x, preferring fewer |
x{n,} |
at least n repetitions of x, preferring more |
x{n,}? |
at least n repetitions of x, preferring fewer |
x{n} |
exactly n repetitions of x |
(x) |
unnamed capture group for sub-pattern x |
(?P<name>x) |
named capture group, named name, for sub-pattern x |
(?:x) |
non-capturing sub-pattern x |
\* |
Literal * for any punctuation character * |
\Q...\E |
Literal ... for any text ... as long as it does not include literally \E |
8.3 Ankre (^, $)
Der findes også regular expressions, der angiver, hvor matchninger skal ske. De mest almindelige symboler er ^, som angiver, at matchning skal ske i begyndelsen af en streng, og $, som angiver, at matchning skal ske i slutningen af strengen.
| Sequence | Matches |
|---|---|
^ |
At the beginning of the given string |
$ |
At the end of the given string |
\A |
At the beginning of the given string |
\z |
At the end of the given string |
\b |
At an ASCII word boundary (transition between \w and either \W, \A or \z, or vice-versa) |
\B |
Not at an ASCII word boundary |
8.3.1 Character set (class)
Et character set er en liste over tegn, der skal matches. Listen angives i []. For at matche på bogstaverne a, b eller c bruges følgende character set: [abc]. Character set er en fordel, fordi man slipper for at angive escape (\) for regular expression-symboler. Du behøver ikke escape for følgende symboler: $ . | ? * + ( ) [ {. Det betyder, at du kan skrive disse symboler og matche på dem direkte i et character set (uden at angive escape). For at matche på ., , a b eller c bruges følgende character set: [.*abc]
Der findes dog symboler, som har en særlig funktion også inde i et character set, og de er som følger:
]^negerer listen.[^abc]matcher alt undtagen a, b og c.[a-zA-Z0-9]matcher alle små bogstaver, store bogstaver og tal
-definerer et interval, der følger alfabetisk eller numerisk rækkefølge.- Eksempel:
[a-d]matcher bogstaverne a, b, c eller d. - Eksempel:
[0-4]matcher tallene 0, 1, 2, 3, 4
- Eksempel:
\bruges til at escape],^og-i et character set.[a\\-c]matchera-c.[\^\-]matcher^-.
Nu matcher strenge, der begynder med a og slutter med b, og som derimellem har enten asterisk (*) eller bogstavet b:
str_view(c("abc", "a.c", "a*c", "a c"), "a[*b]c")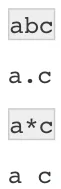
Bemærk, at det lykkedes os at matche asterisk (*) uden at bruge \\, hvilket forklares ved, at vi i stedet brugte [], som kaldes character class. Lad os prøve igen, men nu udskifter vi det første a med hvilket som helst tegn (.):
str_view(c("abc", "a.c", "a*c", "a c"), ".[*]c")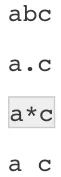
For at matche på mellemrum (blanktegn) kan man bruge et almindeligt mellemrum, med eller uden character class:
str_view(string=c("a c", "a.c", "a*c"), pattern="a[ ]c")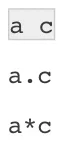
str_view(string=c("a c", "a.c", "a*c"), pattern="a c")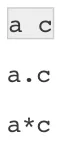
8.3.2 Alternerende matchning
Du kan matche på flere alternativer ved at bruge den lodrette streg (|) på følgende måde:
str_view(c("a", "b", "c", "d"), "a|b")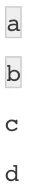
Du kan matche på flere end to alternativer:
str_view(c("a", "b", "c", "d"), "a|b|c")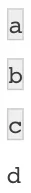
Hvis du matcher inde i et ord, kræves der parenteser på følgende måde:
str_view(c("glad", "glöd"), "gl(a|ö)d")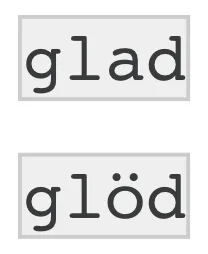
my_words <- c("Sommarlov", "Okidoki", "Tackar", "Bolag")

## Starter ordet med bogstavet S?
str_detect(my_words, "^S")[1] TRUE FALSE FALSE FALSE## Hvor mange ord slutter på bogstavet i eller r?
str_detect(my_words, "[ir]$")[1] FALSE TRUE TRUE FALSEstr_subset(my_words, "x$")character(0)8.3.3 Negere matchning
I stedet for at finde alle strenge, der indeholder et bestemt symbol, kan vi negere matchningen. Det kan gøres ved at bruge udråbstegn (!) foran [str_detect()](https://stringr.tidyverse.org/reference/str_detect.html). Udråbstegn (!) betyder “omvendt” eller “ikke”. Det vil sige, at !str_detect() betyder, at en streng ikke kan matches. Lad os teste:
## Hvilke ord begynder ikke med S?
my_words <- c("Sommarlov", "Okidoki", "Tackar", "Bolag")
!str_detect(my_words, "^S")[1] FALSE TRUE TRUE TRUEDu kan også negere matchning ved hjælp af character class. Det gøres ved at begynde character class med ^ . Med følgende kode identificeres ord, der ikke begynder med S:
## Hvilke ord begynder ikke med S?
my_words <- c("Sommarlov", "Okidoki", "Tackar", "Bolag")
str_detect(my_words, "^[^S]")[1] FALSE TRUE TRUE TRUE8.4 Gentagen matchning
Vi kan styre, hvor mange gange en streng kan matches, med følgende tegn:
my_string <- "AAAAAA"

str_view(my_string, "AA?")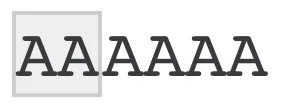
str_view(my_string, "AA+")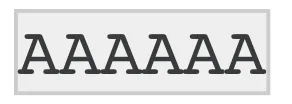
str_view(my_string, "AA*")Med klammer kan du angive, hvor mange gange en matchning skal ske:
{n}: n antal gange{n,}: n eller flere gange{,m}: højst m gange{n,m}: mellem n og m gange
str_view(my_string, "A{2}")str_view(my_string, "A{2,}")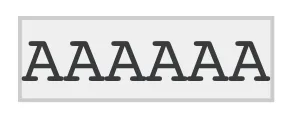
str_view(my_string, "A{2,3}")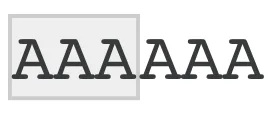
8.4.1 Shorthand character classes
Der findes character sets, som er blevet forkortet, fordi de bruges så ofte. De er som følger:
\d: matcher hvilket som helst ciffer\D: matcher alt, der ikke er et ciffer\s: matcher alle mellemrum (f.eks. mellemrum, tab, linjeskift);\S: matcher alt, der ikke er mellemrum\w: matcher alle cifre og bogstaver\W: matcher alt, der ikke er et ciffer eller bogstav
I regular expressions skal de angives med en ekstra backslash. For \d bliver det således \\d.
Lad os matche alle cifre og alt, der ikke er cifre:
str_view_all("Hej! 123456 @ # %", "\\d")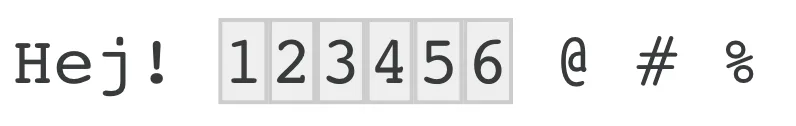
str_view_all("Hej! 123456 @ # %", "\\D")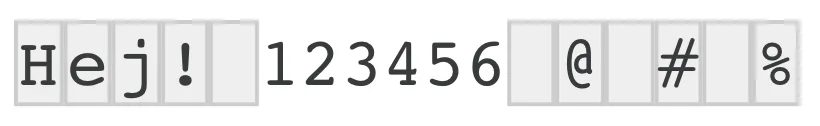
Match alle bogstaver og cifre og det modsatte.
str_view_all("Hej! 123456 @ # %", "\\w")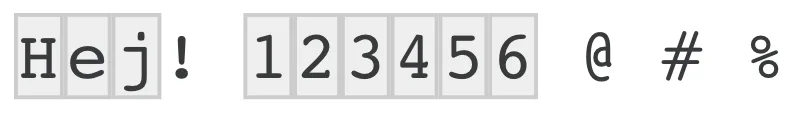
str_view_all("Hej! 123456 @ # %", "\\W")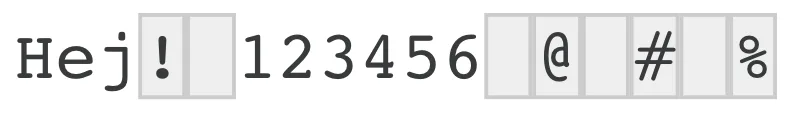
Match alle mellemrum og det modsatte.
str_view_all("Hej! 123456 @ # %", "\\s")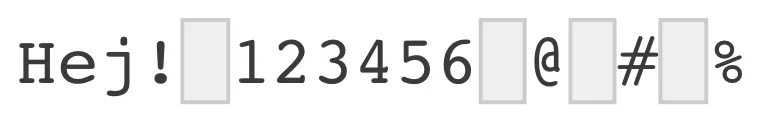
str_view_all("Hej! 123456 @ # %", "\\S")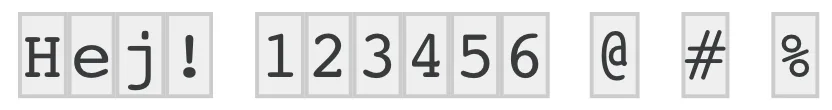
Match alle sekvenser med 5 bogstaver eller cifre, eller 2 cifre:
str_view_all("Hej jag heter Maggi och har telefonnummer 123456", "\\w{5}|\\d{2}")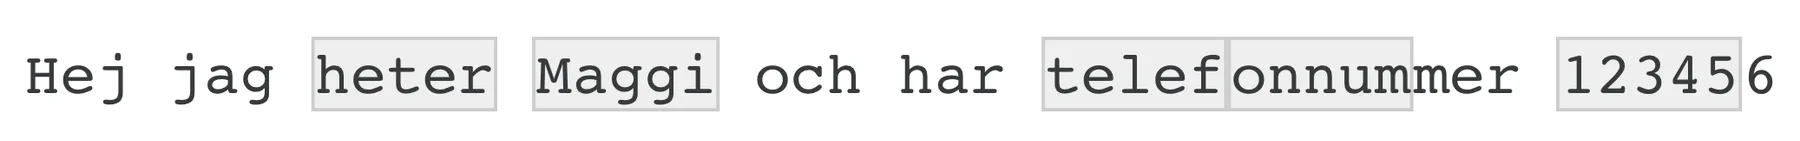
8.4.2 Operatorernes prioritering
Ved matematiske beregninger findes der en prioritering af operander. Multiplikation går forud for addition og subtraktion. Beregningen 1*2+3 vil blive beregnet som (1*2)+3, fordi multiplikation prioriteres. For regular expressions findes der også prioriteringer. Kvantifikatorer (for eksempel +) prioriteres højere end alternationer (|). Hvis et regular expression giver et uventet resultat, kan det være nødvendigt at tydeliggøre prioriteringen ved hjælp af parenteser. Her følger et eksempel:
## Mindre tydeligt regular expression
str_view("Jag hittade en vattenkanna", "an+")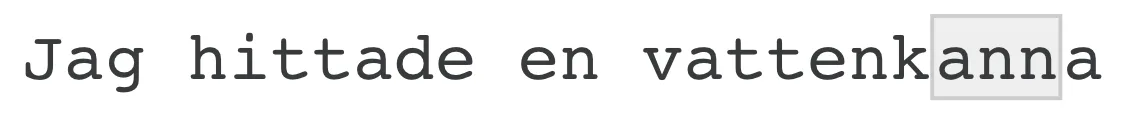
## Tydeligere regular expression
str_view("Jag hittade en vattenkanna", "a(n+)")
8.4.3 Boolske matchninger og betingelser
Du kan bruge den lodrette streg og & som sædvanlig også med strenge. Det betyder, at disse to kommandoer er ækvivalente:
## Opret en vektor med ord
my_words <- c("hej", "bra", "ja", "kanske", "lite", "mycket", "troligen", "sannolikt", "utmärkt")

## Identificér alle ord, der indeholder "a" eller "b"
my_words[str_detect(my_words, "a") | str_detect(my_words, "b")][1] "bra" "ja" "kanske" "sannolikt"## Identificér alle ord, der indeholder "a" eller "b"
my_words[str_detect(my_words, "a|b")][1] "bra" "ja" "kanske" "sannolikt"Du kan på lignende måde lave andre nyttige betingelser:
## Identificér alle ord, der indeholder "a" og "n" og "k"
my_words[str_detect(my_words, "a") & str_detect(my_words, "n") & str_detect(my_words, "k")][1] "kanske" "sannolikt"