
I dette kapitel bruges data fra Right Heart Catetherization (RHC) til at demonstrere funktioner til tabulering af data. Du kan downloade data med følgende kommando:
rhc <- read.csv("https://hbiostat.org/data/repo/rhc.csv", header = TRUE)Funktioner i base R
Base R er grundinstallationen uden nogen tilføjelsespakker. Den mest anvendte funktion til tabeller i base R er table().
En enkelt kategorisk variabel kan tabuleres med funktionen table():
table(rhc$sex)Female Male
2543 3192En krydstabel oprettes på følgende måde:
table(rhc$sex, rhc$death) No Yes
Female 919 1624
Male 1094 2098Bemærk, at det første argument (sex) placeres som rækker, og det andet argument (death) bliver kolonner i krydstabellen.
Vi kan lave en krydstabel stratificeret efter en tredje variabel. For at stratificere den foregående tabel efter variablen ca (cancer) skriver vi følgende:
table(rhc$sex, rhc$death, rhc$ca)ca = Metastatic
No Yes
Female 24 175
Male 12 173
ca = No
No Yes
Female 798 1151
Male 960 1470
ca = Yes
No Yes
Female 97 298
Male 122 455Tabulering med tilføjelsespakker
Pakkerne janitor, dplyr, gtsummary, crosstable og rstatix indeholder kraftfulde funktioner til at lave deskriptive tabeller. Installér pakkerne med følgende kommando:
install.packages(c("rstatix", "janitor", "gtsummary", "crosstable"))Rstatix
Med funktionen get_summary_stats() genererer vi deskriptive data for udvalgte variabler. I eksemplet nedenfor vælger vi variablerne age, aps1, urin1, adld3p, paco21 og ph1:
library(rstatix)
rhc %>%
  get_summary_stats(
    age, aps1, urin1, adld3p, paco21, ph1,
    type = "full")
## A tibble: 6 × 13
variable n min max median q1 q3 iqr mad mean sd se ci
adld3p 1439 0 7 0 0 2 2 0 1.18 1.82 0.048 0.094
age 5735 18.0 102. 64.0 50.1 73.9 23.8 17.0 61.4 16.7 0.22 0.432
aps1 5735 3 147 54 41 67 26 19.3 54.7 20.0 0.264 0.517
paco21 5735 1 156 37 31 42 11 8.90 38.7 13.2 0.174 0.341
ph1 5735 6.58 7.77 7.4 7.34 7.46 0.12 0.089 7.39 0.11 0.001 0.003
urin1 2707 0 9000 1927 1110 2955 1845 1357. 2192. 1525. 29.3 57.5Argumentet type er ovenfor angivet som type="full", hvilket giver ovenstående parametre. Argumentet har følgende muligheder: "full", "common", "robust", "five_number", "mean_sd", "mean_se", "mean_ci", "median_iqr", "median_mad", "quantile", "mean", "median", "min", "max".
Janitor
Med janitor kan man lave fleksible tabeller. Vi begynder med en beskrivelse af variablen cat1 (sygdomskategori):
library(janitor)

rhc %>% tabyl(cat1, show_na = T)
cat1 n percent
ARF 2490 0.434176112
CHF 456 0.079511770
Cirrhosis 224 0.039058413
Colon Cancer 7 0.001220575
Coma 436 0.076024412
COPD 457 0.079686138
Lung Cancer 39 0.006800349
MOSF w/Malignancy 399 0.069572799
MOSF w/Sepsis 1227 0.213949433Derefter tilføjer vi variablen sex, hvilket giver en krydstabel:
rhc %>% tabyl(cat1, sex, show_na = T) cat1 Female Male
ARF 1108 1382
CHF 143 313
Cirrhosis 81 143
Colon Cancer 5 2
Coma 230 206
COPD 208 249
Lung Cancer 12 27
MOSF w/Malignancy 190 209
MOSF w/Sepsis 566 661Med janitors "adorn"-funktioner kan vi tilføje yderligere information til tabellerne. Adorn-funktioner kan kombineres. De er følgende:
| Funktionens navn | Funktion |
|---|---|
adorn_totals() |
Tilføjer total. Har argumentet where =, som kan være “row”, “col” eller “both”. |
adorn_percentages() |
Konverterer antal til proportioner. Har argumentet denominator = “row”, “col” eller “all”. |
adorn_pct_formatting() |
Konverterer proportioner til procent. |
adorn_rounding() |
Afrunder decimalerne i proportioner. |
adorn_ns() |
Tilføjer antal i en tabel med proportioner eller procent. |
adorn_title() |
Tilføjer en overskrift på rækkerne og kolonnerne i krydstabellen. |
Vi laver en krydstabel med procenttal:
rhc %>%
  tabyl(cat1, sex, show_na = T) %>%
  adorn_totals(where="col") %>%
  adorn_totals(where="row") %>%
  adorn_percentages() %>%
  adorn_pct_formatting()
cat1 Female Male Total
ARF 44.5% 55.5% 100.0%
CHF 31.4% 68.6% 100.0%
Cirrhosis 36.2% 63.8% 100.0%
Colon Cancer 71.4% 28.6% 100.0%
Coma 52.8% 47.2% 100.0%
COPD 45.5% 54.5% 100.0%
Lung Cancer 30.8% 69.2% 100.0%
MOSF w/Malignancy 47.6% 52.4% 100.0%
MOSF w/Sepsis 46.1% 53.9% 100.0%
Total 44.3% 55.7% 100.0%Vi tilføjer nu antallet ud over procenttallene:
rhc %>%
  tabyl(cat1, sex) %>%
  adorn_totals(where = "row") %>%
  adorn_percentages(denominator = "col") %>%
  adorn_pct_formatting() %>%
  adorn_ns(position = "front") %>%
  adorn_title(
    row_name = "Sjukdom",
    col_name = "Kön")
Kön
Sjukdom Female Male
ARF 1108 (43.6%) 1382 (43.3%)
CHF 143 (5.6%) 313 (9.8%)
Cirrhosis 81 (3.2%) 143 (4.5%)
Colon Cancer 5 (0.2%) 2 (0.1%)
Coma 230 (9.0%) 206 (6.5%)
COPD 208 (8.2%) 249 (7.8%)
Lung Cancer 12 (0.5%) 27 (0.8%)
MOSF w/Malignancy 190 (7.5%) 209 (6.5%)
MOSF w/Sepsis 566 (22.3%) 661 (20.7%)
Total 2543 (100.0%) 3192 (100.0%)Du kan gemme tabellen direkte i Microsoft Word, PowerPoint, HTML eller som et billede ved hjælp af pakken flextable, hvis funktioner kan anvendes direkte som i følgende eksempel. Funktionen save_as_docx() gemmer tabellen i Microsoft Word. Alternativt kan funktionerne save_as_html(), save_as_word(), save_as_ppt() eller save_as_image() bruges.
install.packages("flextable")
library(flextable)

rhc %>%
  tabyl(cat1, sex) %>%
  adorn_totals(where = "row") %>%
  adorn_percentages(denominator = "col") %>%
  adorn_pct_formatting() %>%
  adorn_ns(position = "front") %>%
  flextable() %>% # opretter en flextable
  autofit() %>% # Sikrer maks. 1 linje per celle
  save_as_docx(path="min_tabell.docx") # Gemmer i Word-format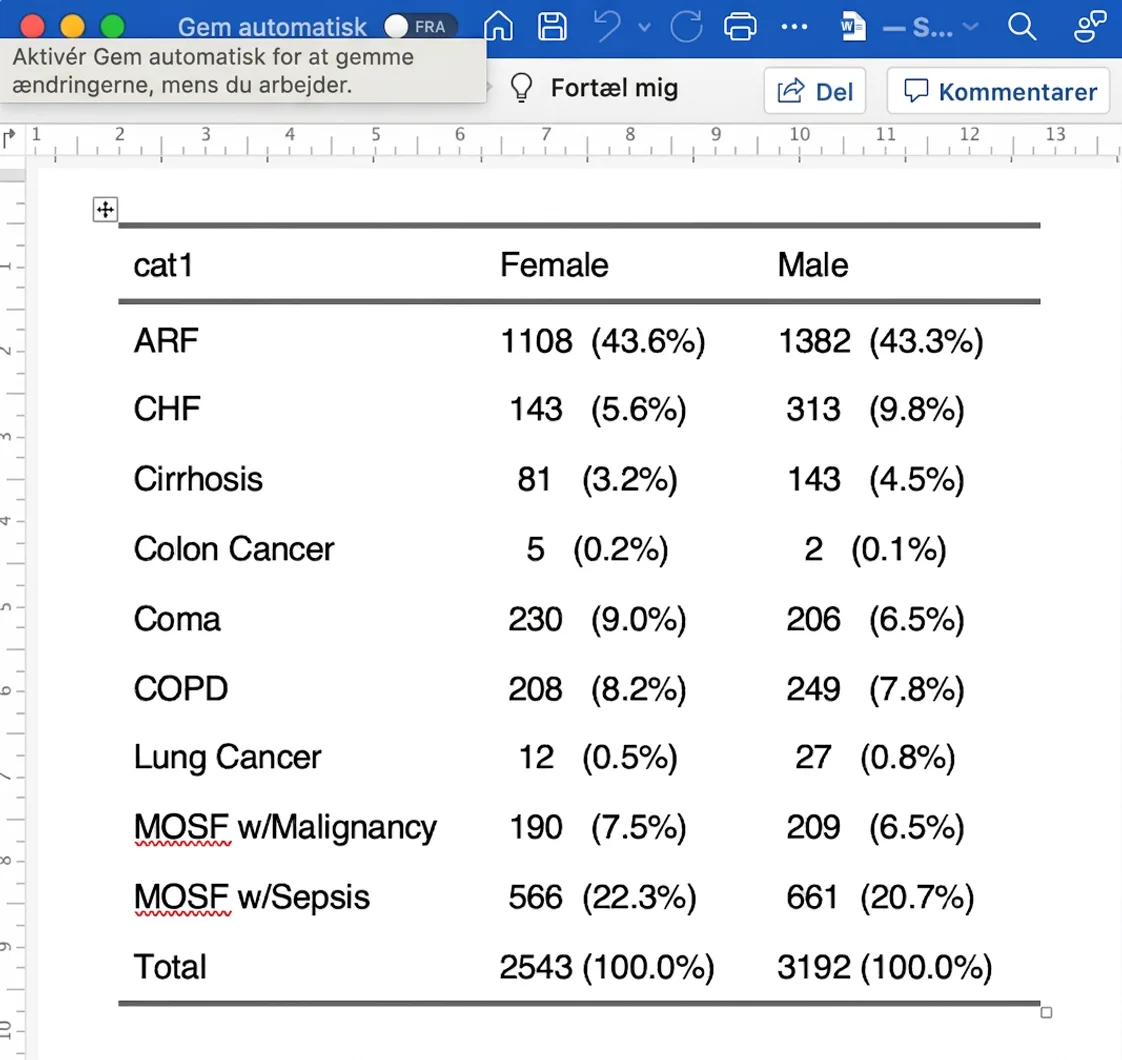
Crosstable
library(crosstable)Vi laver nu en krydstabel for sex og death. Vi angiver en særlig funktion for percent_pattern (den behøver du ikke at huske):
crosstable(data=rhc,
           # Variabler, der skal krydstabuleres
           cols=c(age, sex),
           # Hvilke procentsatser skal vises?
           total = "both",
           # Hvordan skal procentsatserne vises?
           percent_pattern="{n} ({p_row}/{p_col})") %>%
       # Pænere formatering
       as_flextable()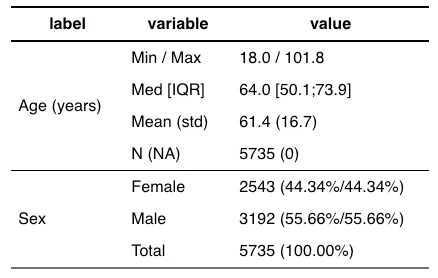
Som du kan se, gav funktionen ikke en krydstabel, hvilket skyldes, at vi glemte argumentet by. Det retter vi nu:
crosstable(rhc,
           cols=c(age, sex),
           by=death,
           total = "both",
           percent_pattern="{n} ({p_row}/{p_col})") %>%
  as_flextable()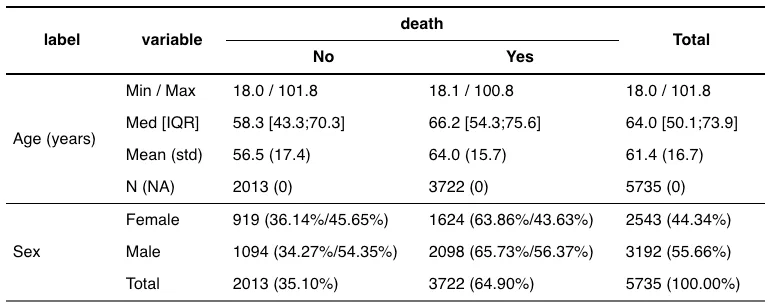
Funktionen kan bruges til at inspicere alle variablerne stratificeret efter eksempelvis death. For at inspicere alle variabler angives cols=everything():
crosstable(rhc,
           cols=everything(),
           by=death,
           total = "both",
           percent_pattern="{n} ({p_row}/{p_col})") %>%
  as_flextable()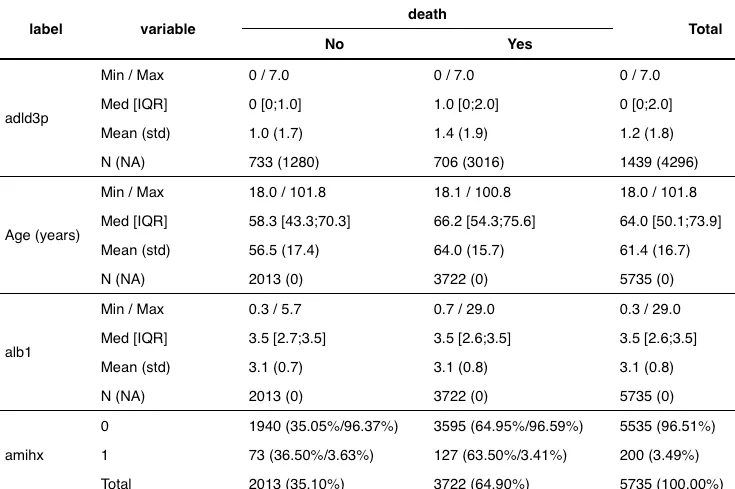
Figuren er forkortet.