
Hvad er kunstig intelligens (AI)?
Kunstig intelligens (AI) er ikke længere en fremtidsvision, men en integreret del af vores hverdag. Vi møder den i alt fra de algoritmer, der styrer vores feeds på sociale medier og anbefalingerne i streamingtjenester, til avancerede systemer, der tolker røntgenbilleder, diagnosticerer sygdomme, kører biler, skriver kode og analyserer finansmarkederne.
Enkelt sagt handler AI om at få computere til at udføre opgaver, der normalt kræver menneskelig intelligens: at genkende mønstre, drage konklusioner, træffe beslutninger, forstå sprog og løse problemer. I mange specifikke sammenhænge udviser computere allerede en evne, der overgår menneskets, såkaldt smal AI (narrow AI), det vil sige systemer, der er meget dygtige inden for et afgrænset område, men som mangler evnen til at ræsonnere uden for det.
Vi står over for en digital transformation, der ofte sammenlignes med industrialiseringen. Men mens den industrielle revolution mekaniserede det manuelle arbejde, ændrer AI-revolutionen forudsætningerne for det kognitive og intellektuelle arbejde. Det påvirker alt fra administrative erhverv til kreative skabelsesprocesser og akademisk forskning.
En kort historik: Fra simple regelbaserede systemer til generativ AI
Idéen om tænkende maskiner er ikke ny. Allerede i 1950'erne blev begrebet "kunstig intelligens" introduceret, og de første årtier var domineret af regelbaserede systemer, såkaldte ekspertsystemer, hvor programmører forsøgte at indkode eksplicitte regler for, hvordan en computer skulle agere i forskellige situationer. Metoden fungerede ved strengt afgrænsede problemer, men var vanskelig at skalere op, fordi virkeligheden sjældent lader sig indfange i et fast regelsæt.
I 2000'erne og 2010'erne skete der et paradigmeskift med maskinlæringens gennembrud. I stedet for at programmere regler i hånden fik computerne nu lov til at lære mønstre direkte fra store mængder data. Udviklingen blev drevet af tre faktorer, der forstærkede hinanden: adgangen til enorme datamængder via internettet, kraftigere hardware (ikke mindst grafikkort, der viste sig at være fremragende til at træne neurale netværk) og nye, mere effektive algoritmer. Gennembrud inden for billedgenkendelse omkring 2012 viste, at såkaldte dybe neurale netværk kunne slå tidligere metoder med stor margin, og siden er udviklingen accelereret år for år.
Det seneste store spring kom i begyndelsen af 2020'erne med gennembruddet for generativ AI og store sprogmodeller, hvor værktøjer som ChatGPT blev startskuddet til en bredere offentlig bevidsthed om teknologiens potentiale.
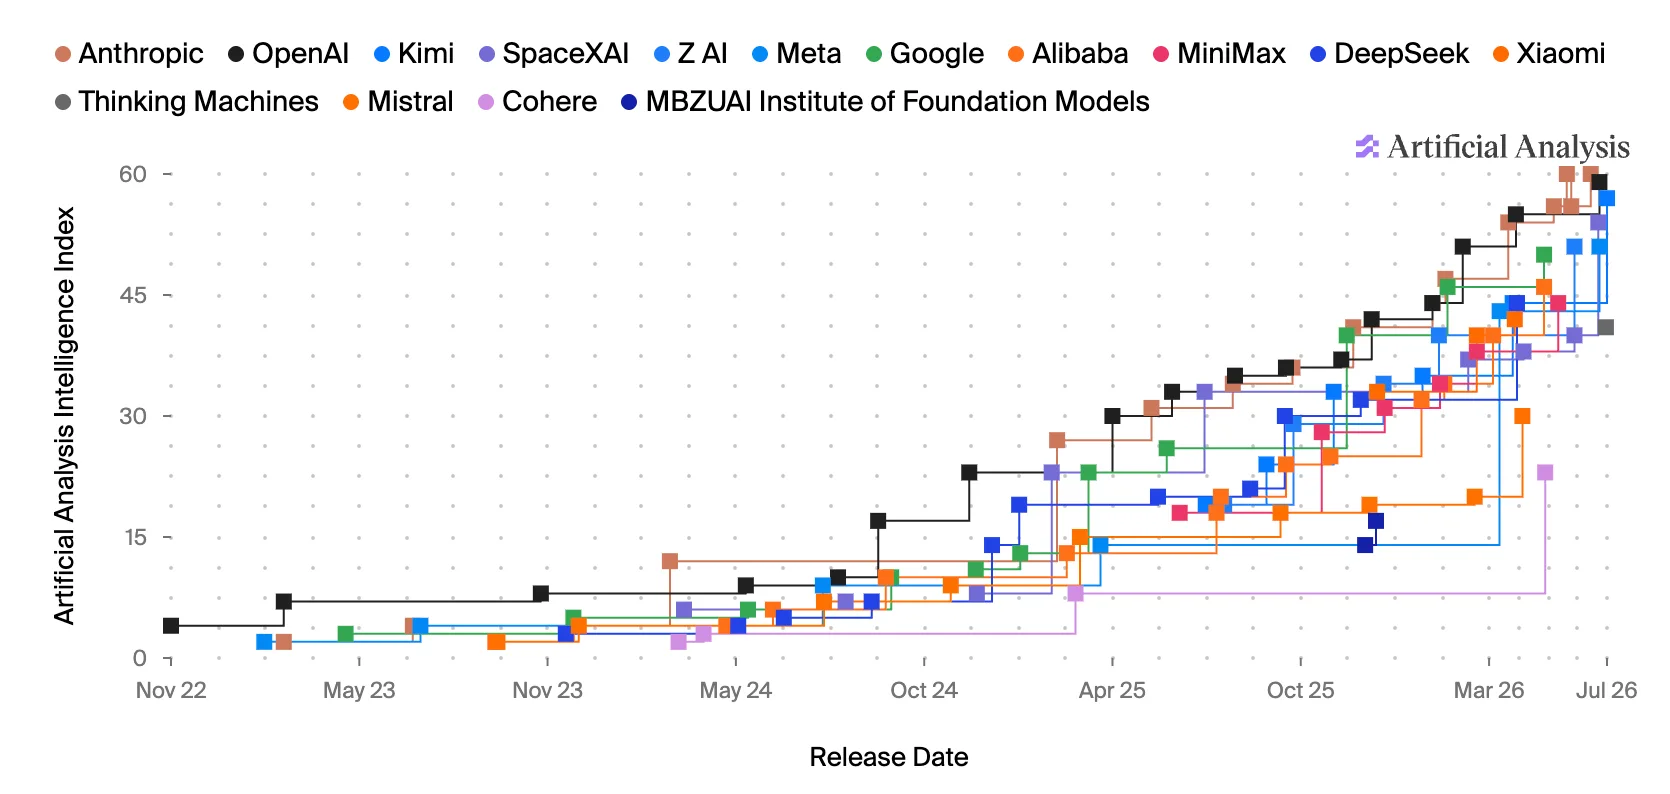
Figur 1 nedenfor viser, hvordan evnerne i AI-modeller er accelereret fra 2022 til 2026. Der ses en ekstremt hurtig udvikling i sprogmodellernes evner. Evnerne måles med standardiserede test (se Artificial Analysis).
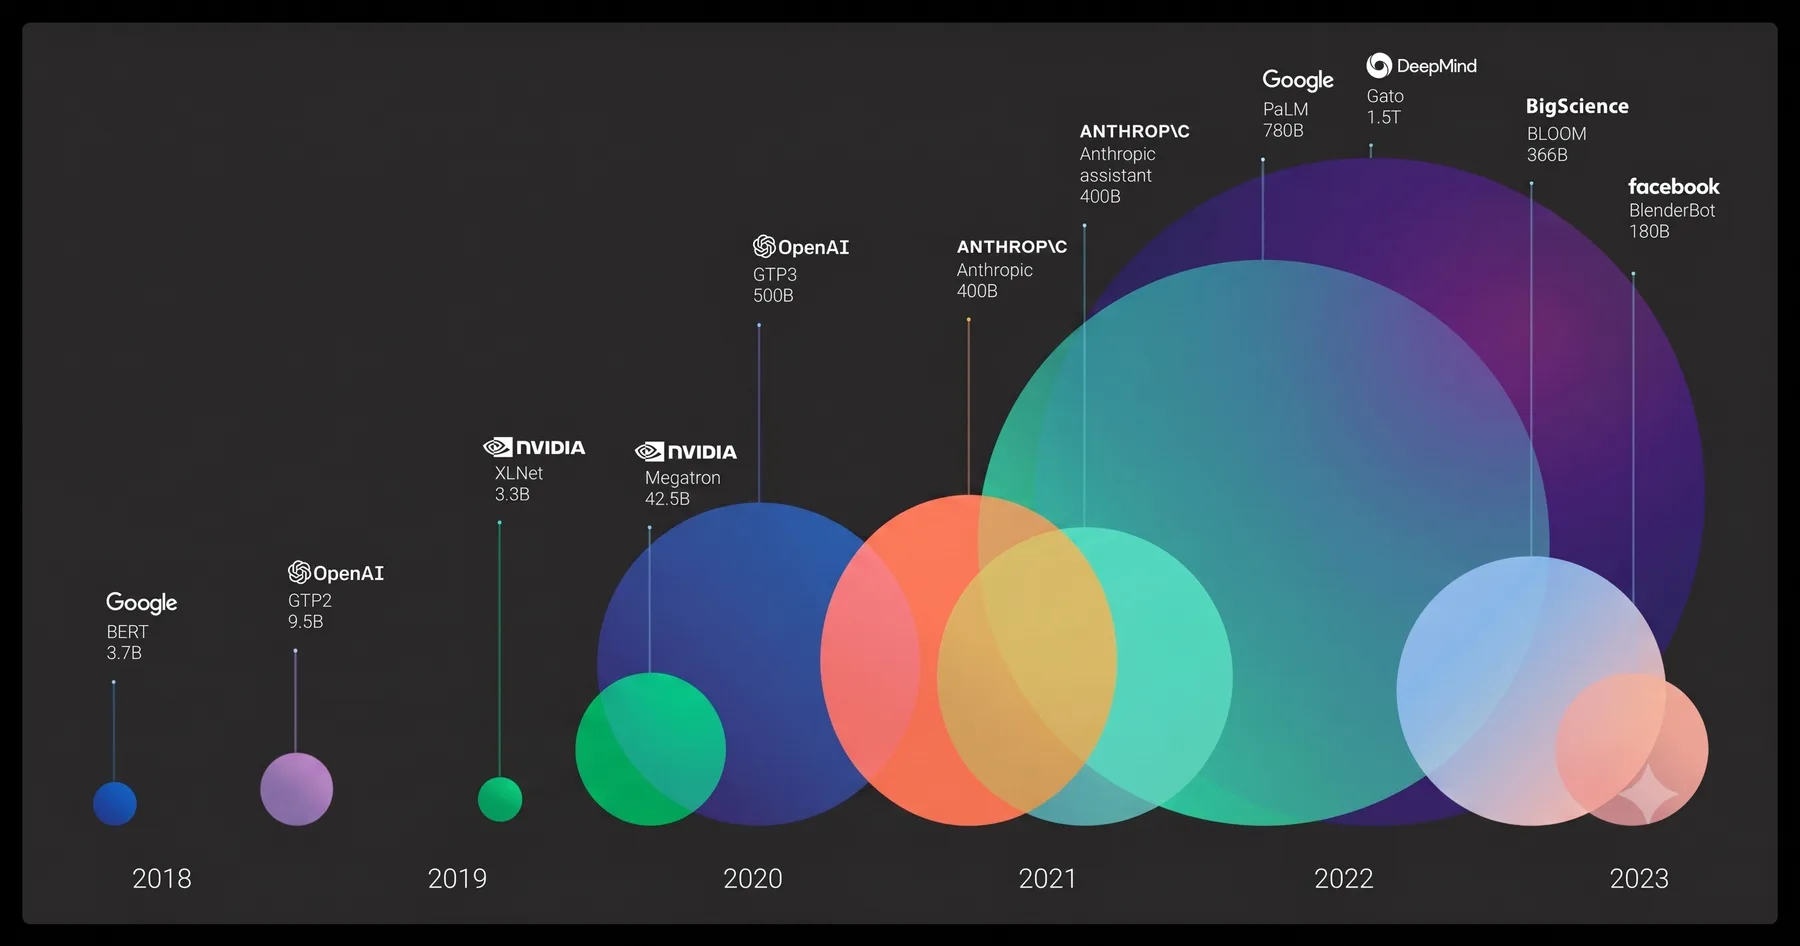
Modellernes evner forbedres i takt med, at modellernes størrelse øges. Som det fremgår af nedenstående figur, hvor cirklernes størrelse angiver sprogmodellens størrelse, er modellerne hurtigt blevet markant større, og parallelt hermed er den intellektuelle formåen steget.
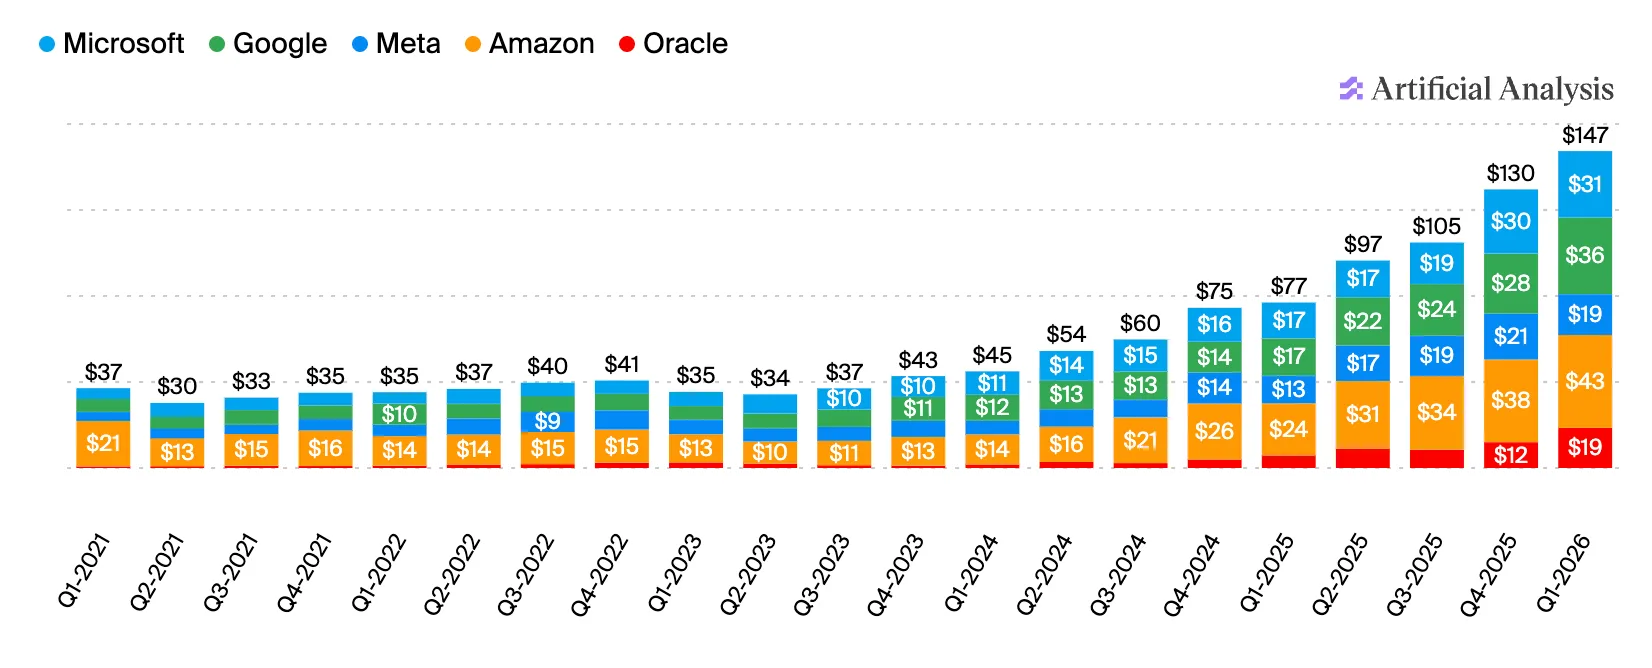
Udviklingen af sprogmodeller er i høj grad drevet af enorme investeringer foretaget af teknologivirksomheder som Microsoft, Google, Meta, Amazon og Oracle. De investeringer, som disse virksomheder har foretaget i AI-infrastruktur, fremgår af nedenstående figur. Det anslås, at disse virksomheder vil investere tusindvis af milliarder dollars i AI-infrastruktur i de kommende år. Investeringerne foretages i jagten på at kunne tilbyde (superhuman) intelligens fra enorme datafabrikker.
Grundlaget: maskinlæring, dyb læring og neurale netværk
For at forstå nutidens AI er det værd at afklare nogle centrale begreber. Maskinlæring (machine learning) er en fællesbetegnelse for metoder, hvor computere "lærer" at udføre en opgave ved at analysere data i stedet for at blive eksplicit programmeret til hvert enkelt scenarie. Man inddeler normalt maskinlæring i tre hovedtyper.
Ved superviseret læring trænes modellen på data, hvor facit allerede er kendt, for eksempel tusindvis af billeder mærket "kat" eller "hund", og modellen lærer at genkende de mønstre, der adskiller dem. Ved ikke-superviseret læring mangler facit, og modellen skal i stedet selv finde strukturer eller grupperinger i dataene, eksempelvis ved at inddele kunder i forskellige segmenter. Ved forstærkningslæring lærer systemet gennem forsøg og fejl og belønnes for ønsket adfærd, en metode der blandt andet har ligget bag AI, som har mestret avancerede spil på et overmenneskeligt niveau.
Dyb læring (deep learning) er en undergruppe af maskinlæring, der bygger på kunstige neurale netværk, løst inspireret af hvordan hjernens nerveceller er forbundet. Ved at stable mange lag af disse netværk oven på hinanden kan systemet lære stadig mere abstrakte repræsentationer af dataene, fra simple kanter og former i et tidligt lag til hele ansigter eller begreber i et senere. Det er netop dyb læring, kombineret med en arkitektur kaldet transformere (transformers), der ligger til grund for nutidens store sprogmodeller.
Det store skift: fra smal AI til generativ AI og store sprogmodeller
Den tidligere generation af AI var hovedsageligt analytisk. Den blev trænet i at genkende mønstre, sortere data og udføre specifikke, ofte repetitive opgaver inden for givne rammer. Mange troede længe, at AI udelukkende ville kunne håndtere disse strukturerede processer. Dette ændrede sig grundlæggende i begyndelsen af 2020'erne med gennembruddet for generativ AI og store sprogmodeller (LLM). Nutidens AI er ikke længere begrænset til blot at analysere eksisterende data; den kan skabe helt nyt indhold: tekster, billeder, musik, video og programkode, ofte på et niveau, der er svært at skelne fra menneskeskabt materiale.
Denne evne til at generere indhold ud fra en instruktion (en såkaldt "prompt") har åbnet for helt nye anvendelsesområder, fra at opsummere rapporter og skrive udkast til at udarbejde designforslag eller fejlsøge programkode på sekunder. Nutidens mest avancerede modeller er også "multimodale", hvilket betyder, at de kan forstå og kombinere flere typer data samtidig, for eksempel tekst, billede, lyd og video i samme ræsonnement.
Agentisk AI: fra passive assistenter til autonome agenter
Et af de største skift inden for kunstig intelligens lige nu er overgangen fra generativ AI til agentisk AI (agentic AI). Tidligere krævede AI-modeller konstant styring gennem specifikke instruktioner for at løse én opgave ad gangen. En AI-agent fungerer i stedet mere autonomt: Du giver den et overordnet mål, og agenten planlægger selv de nødvendige trin for at nå dertil.
Styrken i dette ligger i, at agenten kan interagere med omverdenen. Den kan søge information på internettet, bruge eksterne programmer og værktøjer, træffe beslutninger baseret på sine egne delresultater og rette sine fejl undervejs. I stedet for blot at skrive et udkast til en e-mail kan en AI-agent analysere et problem, indsamle data fra forskellige systemer, sammenstille en rapport og selvstændigt handle på indsigterne. Det forvandler AI fra et passivt værktøj til en aktiv samarbejdspartner, der kan drive komplekse projekter fra start til mål. Samtidig rejser denne autonomi nye spørgsmål om ansvar og kontrol: Hvem bærer ansvaret, når en agent på egen hånd træffer en forkert beslutning?
AI i praksis: sundhedsvæsen, uddannelse, transport, kreative erhverv og forskning
Potentialet i AI ligger ikke primært i at erstatte mennesket, men i at forstærke vores evner. Ved at automatisere rutineopgaver kan vi fokusere mere på menneskelig kontakt, dybdegående analyse og innovation. Nedenfor følger nogle eksempler på, hvordan AI allerede ændrer forskellige samfundssektorer.
Sundhedsvæsenet. Et tydeligt eksempel findes i sundhedsvæsenet:
- Nutidens udfordring: En læge har ofte begrænset tid pr. patient. Under en kort konsultation skal lægen læse journaler, interviewe patienten, foretage en medicinsk vurdering, ordinere behandling, skrive henvisninger og til sidst dokumentere det hele i journalsystemet. Tidspresset risikerer at gå ud over både patientsikkerheden og arbejdsmiljøet.
- AI-løsningen: Med moderne AI-værktøjer kan systemet lytte til samtalen, automatisk opsummere den til et korrekt medicinsk journalnotat, gennemsøge patienthistorikken og foreslå relevante behandlingsmuligheder baseret på den nyeste forskning. Når AI tager sig af dokumentationen, kan lægen i stedet bruge sin tid på undersøgelsen og det personlige møde med patienten.
Uddannelse. AI bruges i stigende grad til at skabe individuelt tilpassede undervisningsmaterialer, der følger hver elevs studietempo, samt til at støtte lærere i rettelse og opfølgning, hvilket frigør tid til det pædagogiske møde med eleven.
Transport. Selvkørende køretøjer og AI-baseret trafikoptimering viser, hvordan mønstergenkendelse i realtid kan forbedre både sikkerhed og effektivitet i transportsystemerne.
Kreative erhverv. Inden for design, musik, film og markedsføring bruges generative værktøjer til hurtigt at udarbejde udkast, visualiseringer og varianter, hvilket grundlæggende ændrer de kreatives arbejdsgange.
Forskning med "Co-Scientists". Inden for forskning og avanceret analyse er AI ved at omdefinere den videnskabelige arbejdsmetode. Specialiserede AI-systemer, undertiden kaldet "co-scientists", fungerer som autonome forskningspartnere, der kan automatisere store dele af forskningskæden: analysere enorme mængder eksisterende forskningsdata, generere nye hypoteser, designe eksperimenter og simulere resultater. Ved at koble sådanne AI-modeller sammen med automatiserede robotlaboratorier ("cloud labs") kan eksperimenter køres i stor skala døgnet rundt. Denne symbiose mellem menneskelig intuition og maskinel slutningsevne accelererer opdagelsestempoet inden for medicin, materialevidenskab og klimaforskning.
Kapløbet mellem AI-laboratorierne
Udviklingen af de mest kraftfulde sprogmodeller, ofte kaldet "frontier-modeller", har i lang tid været drevet af nogle få amerikanske AI-laboratorier som OpenAI, Anthropic og Google, med lukket (closed source) kildekode og lukkede modelvægte. Frem til sommeren 2026 var det i praksis disse aktører, der satte barren for, hvad AI overhovedet kunne klare.
I juli 2026 skete der dog et trendbrud. Det kinesiske AI-laboratorium Moonshot AI, baseret i Beijing, offentliggjorde da Kimi K3, en model med åbne vægte (open weight) og hele 2,8 billioner parametre. I flere specifikke sammenligninger, blandt andet inden for agentisk kodning, klarede Kimi K3 sig bedre end Anthropics daværende førende modeller Claude Fable 5 og Claude Mythos, samtidig med at den lå meget tæt på konkurrenten GPT-5.6 fra OpenAI. Det var første gang, en åbent tilgængelig model, endda udviklet i Asien, overhalede de lukkede vestlige frontier-modeller på væsentlige punkter, selvom billedet er nuanceret, eftersom de lukkede modeller fortsat lå en smule foran på andre typer test.
Det, der gør dette særligt betydningsfuldt, er prisbilledet. Ifølge Moonshots officielle prisliste koster Kimi K3 omkring 0,30 dollar pr. million cachede input-tokens, 3 dollars pr. million almindelige input-tokens og 15 dollars pr. million output-tokens. Claude Fable 5 koster til sammenligning 10 dollars pr. million input-tokens og 50 dollars pr. million output-tokens, omtrent tre gange så meget i begge ender. Forskellen viser, hvor hurtigt AI-intelligens er ved at blive en handelsvare (commodity): Evner, som for blot en måned eller to siden var forbeholdt nogle få aktører til en høj pris, kan nu fås for en brøkdel af omkostningen, undertiden endda gratis at downloade og køre selv.
Dette stiller nye krav til den, der bruger AI. Forskellige modeller er gode til forskellige ting og kræver desuden helt forskellig infrastruktur. En mindre, effektiviseret model kan i dag køres lokalt på en enkelt kraftig GPU hos en entusiast eller en mindre virksomhed. Kimi K3 er derimod, trods sine åbne vægte, i praksis svær at køre lokalt for langt de fleste: Med 2,8 billioner parametre i alt (hvoraf kun en mindre andel aktiveres pr. token takket være en såkaldt Mixture-of-Experts-arkitektur) kræves der alligevel en betydelig mængde hukommelse og flere sammenkoblede grafikkort for selv at drive modellen. De fleste brugere vil derfor også fremover bruge sådanne modeller via et API frem for at køre dem på egen hardware.
Samlet betyder dette, at den, der ønsker at bruge AI på en god måde, skal tilegne sig en vis viden: hvilken model der passer til hvilken opgave, hvad den koster at køre i stor skala, og hvilken infrastruktur den kræver. Da både regnekraft og energi er begrænsede ressourcer, bør AI også bruges ansvarligt; at vælge en mindre, billigere model, når opgaven ikke kræver den allermest avancerede (og energikrævende) frontier-model, er en del af en bæredygtig og bevidst brug af AI.
Muligheder og nytte: AI forandrer arbejdslivet
Ligesom den industrielle revolution frigjorde muskelkraft gennem mekanisering, frigør AI-revolutionen nu kognitiv kapacitet. Ved at automatisere rutineopgaver som dataindsamling, dokumentation og første udkast kan medarbejdere bruge mere tid på det, der faktisk kræver menneskelig dømmekraft: relationer, kreativitet og komplekse beslutninger. AI virker også demokratiserende, fordi den giver flere mennesker adgang til kompetencer, der tidligere krævede specialistviden, for eksempel hjælp til programmering, tekstudkast eller dataanalyse. Samlet betyder dette hurtigere beslutningsprocesser, mere personligt tilpassede tjenester og en mulighed for, at mindre organisationer kan konkurrere med ressourcer, der tidligere kun fandtes hos store aktører.
Det er usandsynligt, at vi inden for de nærmeste år vil se en såkaldt kunstig generel intelligens, AGI, det vil sige en AI, der har en fuldstændig menneskelig begavelse med egen bevidsthed, drømme og spontanitet. Menneskelig intelligens er dybt forankret i vores biologiske og emotionelle eksistens. De mest kraftfulde aktuelle sprogmodeller begår fortsat banale fejl, hvilket afslører, at de er langt fra AGI. Det betyder, at nutidens generative AI, det vil sige sprogmodeller, kan udvise både yderst imponerende evner og samtidig fejle i simple, grundlæggende opgaver, der kræver eksakt logik eller regning. Et eksempel er, at generativ AI i flere studier har klaret sig bedre end læger i specifikke diagnostiske opgaver, men den samme model kan fejle i at tælle, hvor mange ord sætningen "Hvordan har du det?" indeholder.
Udviklingen er dog eksponentiel. Generativ AI bliver hurtigt bedre, og stadig flere mangler elimineres gennem løbende forbedringer. Forbedringerne betyder oftest, at modellerne bliver større, og at arkitekturen justeres til det bedre. Succeserne med generativ AI har også gjort det tydeligt for os, at mange af de arbejdsopgaver, vi betragter som intellektuelle, kan løses uden bevidst tænkning. AI-modeller mangler nemlig bevidsthed og subjektiv oplevelse, selvom det undertiden hævdes, at de "tænker". Komplicerede vurderinger inden for sundhedsvæsen, finans, ingeniørkunst og matematik har kunnet løses med AI, selvom modellerne altså ikke tænker i egentlig forstand. Det har rejst nærmest eksistentielle spørgsmål om, hvordan menneskets rolle vil udvikle sig i de kommende år. Vi ved i dag ikke, hvor hurtigt eller hvor meget AI vil udvikle sig. Vi ved ikke, om sprogmodeller nogensinde vil opnå AGI, og flere førende forskere mener, at AGI ikke kan opnås med de eksisterende metoder til at bygge sprogmodeller. Hvad vi derimod ved, er, at stadig flere arbejdsopgaver helt eller delvist vil kunne varetages af AI. Med al sandsynlighed vil menneske og maskine arbejde side om side i de kommende år, og derefter kan man antage, at menneskets rolle i de fleste nuværende arbejdsopgaver vil ændre sig. Det vil give mennesket mulighed for at bruge mere tid på det, der kræver fysisk tilstedeværelse, menneskelige relationer, kreativitet og etiske afvejninger, det, der altid har krævet et menneske, men som vi hidtil sjældent har haft tid til i vores arbejdsliv.
Udfordringer, risici og etik
Trods de imponerende fremskridt er det vigtigt at være realistisk og forstå teknologiens begrænsninger. AI-systemer mangler bevidsthed, følelser og ægte biologisk forståelse; de opererer ved hjælp af avanceret statistik og sandsynlighedsberegninger. Når vi integrerer AI i samfundet, står vi over for flere store udfordringer:
- Hallucinationer: Sprogmodeller kan undertiden generere information, der lyder helt overbevisende, men som faktisk er forkert, hvilket stiller krav om kildekritik og menneskelig gennemgang.
- Bias og fordomme: En AI bliver aldrig bedre end de data, den trænes på. Hvis træningsdataene indeholder menneskelige fordomme eller skævheder, vil AI'en reproducere og undertiden forstærke dem.
- Etik og ophavsret: Der foregår en intens juridisk og etisk debat om, hvordan data bruges til at træne modeller, samt hvem der ejer rettighederne til det AI-genererede materiale.
- Privatliv: Når AI-systemer trænes på og analyserer store mængder personlige data, opstår der spørgsmål om, hvordan informationerne indsamles, opbevares og beskyttes.
- Desinformation: Generativ AI gør det lettere at skabe overbevisende, men falske billeder, lyd og video (såkaldte deepfakes), hvilket stiller nye krav til verifikation og mediekompetence.
- Arbejdsmarked: Automatisering rejser berettigede spørgsmål om, hvilke erhverv og arbejdsopgaver der vil ændre sig eller forsvinde, og hvilke kompetencer der vil blive efterspurgt fremover.
Regulering og styring
I takt med at AI får stadig større indflydelse på samfundet, er behovet for regelsæt vokset. I EU har man udarbejdet AI-forordningen (AI Act), et af verdens første overordnede regelsæt for kunstig intelligens, som klassificerer AI-systemer efter risikoniveau og stiller strengere krav til systemer, der vurderes som højrisiko, eksempelvis inden for sundhedsvæsen, rekruttering og retshåndhævelse. Samtidig arbejder lande, forskningsinstitutioner og virksomheder verden over med egne retningslinjer for ansvarlig AI-udvikling, ofte med fokus på gennemsigtighed, sikkerhed og menneskelig kontrol. Reguleringen befinder sig fortsat i en tidlig og hastigt foranderlig fase, og det er sandsynligt, at lovgivningen vil fortsætte med at udvikle sig i takt med teknologien.
Bæredygtighed: Energi- og ressourcebehov
Træning og drift af moderne AI-modeller, især store sprogmodeller, kræver betydelig regnekraft, hvilket igen kræver energi og køling i store datacentre. Dette ressourceforbrug er blevet et stadig vigtigere spørgsmål, i takt med at brugen af AI vokser globalt, og det rejser spørgsmål om, hvordan teknologiudviklingen kan kombineres med klimamål og bæredygtig energiforsyning. Samtidig bruges AI selv som et værktøj til at effektivisere energisystemer, optimere ressourceforbruget og fremskynde forskningen i vedvarende energi. Forholdet mellem AI og bæredygtighed går altså begge veje.
Tokenomics
Med tokenomics menes, hvordan omkostningen ved at bruge en AI-model beregnes og prissættes, altså den økonomi, der opbygges omkring tokens. Da hvert kald til en sprogmodel koster penge pr. million tokens, bliver valget af model en afvejning mellem kvalitet, hastighed og pris. I takt med at konkurrencen mellem AI-laboratorierne skærpes, falder prisen pr. token hurtigt, hvilket er en væsentlig grund til, at AI, som tidligere nævnt, i stigende grad beskrives som en handelsvare snarere end en eksklusiv ressource.
Ordliste
AI: Kunstig intelligens, en fællesbetegnelse for computersystemer, der kan udføre opgaver, som normalt kræver menneskelig intelligens, såsom at genkende mønstre, drage konklusioner og træffe beslutninger.
Generativ AI: AI, der kan skabe nyt indhold, for eksempel tekst, billeder, lyd, video eller programkode, frem for blot at analysere eller klassificere eksisterende data.
Symbolsk AI: En ældre type AI, hvor viden repræsenteres gennem eksplicitte regler og symboler, som mennesker programmerer i hånden, i modsætning til nutidens AI, der lærer mønstre direkte fra data.
Sprogmodel (LLM): En AI-model, en såkaldt stor sprogmodel, Large Language Model, der er trænet på enorme mængder tekst og kan forstå og generere menneskeligt sprog.
Neuralt netværk: En modelarkitektur inspireret af hjernens nerveceller, opbygget af sammenkoblede lag, der tilsammen lærer at genkende mønstre i data.
AI-model: Selve den trænede matematiske model, for eksempel en sprogmodel, LLM, et billedgenkendelsesnetværk, CNN, eller et andet neuralt netværk, med enten smal eller mere generel formåen.
AI-værktøj: Den grænseflade eller applikation, der gør en AI-model tilgængelig og anvendelig for en person, for eksempel chatvinduet, man skriver i, når man bruger ChatGPT.
GPU: Grafikprocessor, Graphics Processing Unit, en type processor, der er særligt effektiv til de parallelle beregninger, der kræves for at træne og køre neurale netværk (AI-modeller).
Token: Den mindste byggesten, som en sprogmodel bearbejder tekst i, ofte en del af et ord, et helt ord eller et tegn, og det er ud fra disse tokens, at modellen læser input og genererer output.
Mixture-of-Experts, Input tokens, Output tokens: Mixture-of-Experts er en arkitektur, hvor en AI-model egentlig består af mange mindre delmodeller, såkaldte eksperter, men hvor kun nogle få af disse aktiveres for hvert enkelt token, der bearbejdes. På den måde kan en model have et meget stort samlet antal parametre, samtidig med at beregningsomkostningen pr. token holdes nede, fordi langt fra alle parametre bruges samtidig. Input tokens er de tokens, der udgør det, man sender ind til modellen, for eksempel et spørgsmål eller en instruktion, mens output tokens er de tokens, modellen genererer som svar. Da output tokens normalt koster betydeligt mere pr. stk. end input tokens, bliver længden af modellens svar ofte den faktor, der påvirker den endelige omkostning mest.
Vibe-kodning: Et uformelt udtryk for at skrive programkode ved at beskrive, hvad man vil opnå, i almindeligt sprog til en AI-model, som derefter genererer koden, uden at personen selv skriver eller nødvendigvis forstår hver kodelinje i detaljer.