
Introduktion til Machine Learning (Maskinlæring)
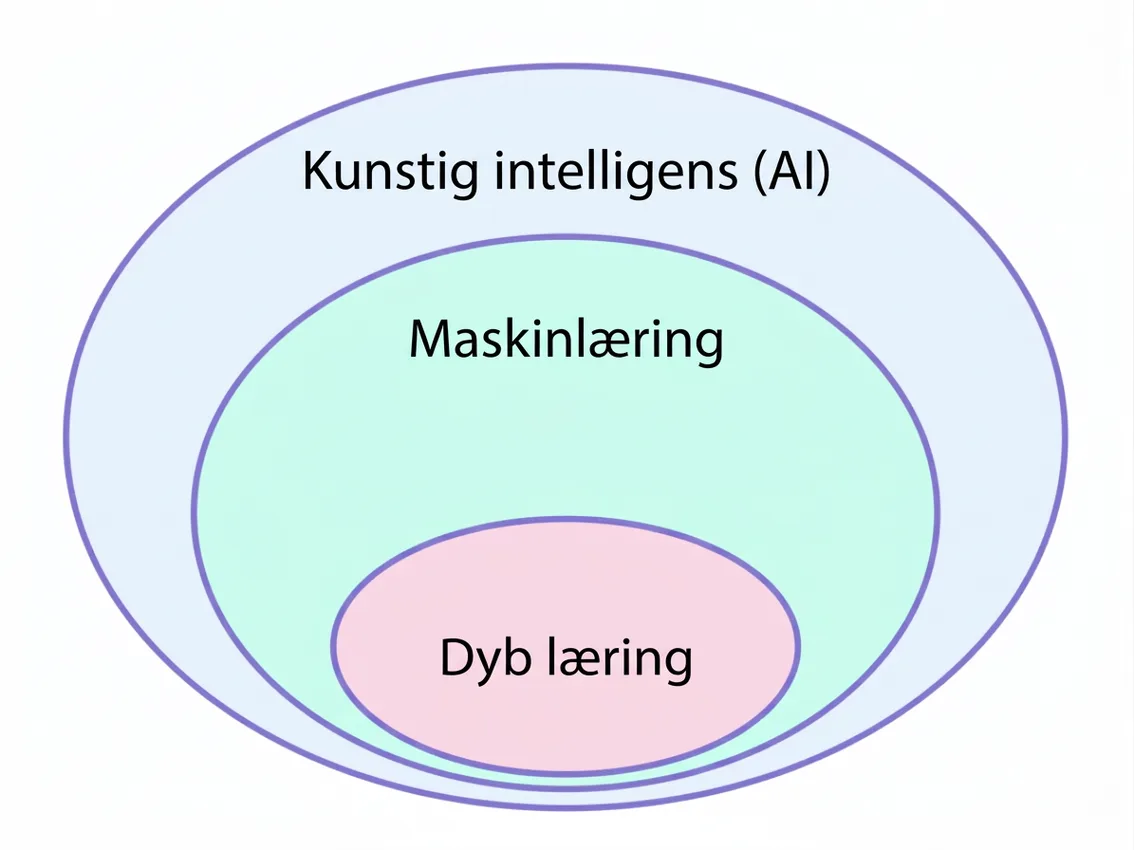
For flere årtier siden begyndte man at udvikle matematiske funktioner, der fungerer som generelle læringsprocedurer. I denne sammenhæng betyder læringsprocedure ganske enkelt en procedure, der gør det muligt for computeren at lære mønstre i data. Generel betyder, at proceduren kan anvendes i mange forskellige sammenhænge, eksempelvis til at analysere besøgende på en hjemmeside, studere kræftpatienter, vurdere aktier på børsen eller vejret i den kommende uge. Disse metoder går under betegnelsen maskinlæring (eng. machine learning), hvilket angiver, at det er en computer (maskinen), der lærer.
Princippet bag machine learning (maskinlæring)
Princippet bag machine learning er enkelt. Computeren lærer ved at finde mønstre i data, og ud fra disse skabes regler. Disse regler kan derefter bruges til at vurdere nye data, som algoritmen endnu ikke har set. For at illustrere dette tager vi et eksempel med elever i gymnasiet. Forestil dig, at vi har data om 1000 elever. Data omfatter elevens køn, forældrenes indkomst, elevens fremmøde i skolen, prøveresultater det første år og slutkarakter det sidste år (Tabel 1). Vi kan bruge machine learning til at undersøge, hvordan køn, forældres indkomst, fremmøde og prøveresultater det første år påvirker slutkarakteren det sidste år. Maskinen vil studere eleverne for at finde mønstre, der afslører, hvilke faktorer der påvirker slutkarakteren, og hvordan de påvirker den. Sandsynligvis vil computeren opdage, at elever med højt fremmøde og gode prøveresultater det første år også vil have høje slutkarakterer det sidste år. Disse opdagelser omsættes til regler, som derefter kan bruges til at forudsige, hvordan nye elever vil klare sig i skolen. Reglerne kan altså bruges til at forudsige nye elevers slutkarakter allerede efter det første år.
| TABEL 1 | Køn | Forældres indkomst | Skolefremmøde | Eksamensresultat år 1 | Slutkarakter |
|---|---|---|---|---|---|
| Martin | Mand | 670000 | 75 % | C | C |
| Johanna | Kvinde | 950000 | 69 % | B | B |
| Mohammed | Mand | 531000 | 83 % | A | A |
| Luciano | Mand | 370000 | 100 % | C | B |
For at forstå maskinlæring bruger vi endnu et eksempel. Forestil dig, at vi driver en webshop, hvor vi sælger tøj. Vores mål er, at så mange besøgende som muligt skal købe tøj. Desværre er det almindeligt, at de besøgende ikke gennemfører deres køb (de forlader webshoppen, inden købet er afsluttet). Vi kan bruge maskinlæring til at beregne sandsynligheden for, at en besøgende vil forlade butikken, inden købet er gennemført. Vi vil nemlig vise en rabatkode til besøgende, som vi beregner har høj sandsynlighed for at afbryde købet. Formålet med at give dem en rabatkode er at øge deres tilbøjelighed til at gennemføre købet. Udfordringen består i at give rabatkuponen til de rette besøgende (vi vil ikke uddele rabatkuponer til besøgende, som alligevel vil gennemføre et køb). For at løse opgaven har vi eksempeldata fra vores tidligere besøgende. For hver besøgende har vi oplysninger om vedkommendes alder, køn, adresse, tidligere indkøb, tidspunkt på døgnet, dato, produkter lagt i indkøbskurven, sider vedkommende har besøgt, hvor lang tid vedkommende har brugt på hver side og så videre. Vi ved også, om den besøgende gennemførte købet eller forlod butikken. Vi kan bruge maskinlæring til at finde mønstre, der adskiller personer, som gennemfører køb, fra dem, der ikke gennemfører køb. Den generelle læringsprocedure vil finde disse mønstre, og ud fra dem skabes regler. Disse regler udgør således en algoritme, som derefter kan anvendes på nye besøgende for at beregne, hvor stor sandsynligheden er for, at de vil forlade siden, inden et køb er gennemført. Vi kan bruge disse sandsynligheder til at afgøre, hvilke besøgende der skal have en rabatkode og forhåbentlig gennemføre deres køb.
I begge ovenstående eksempler bruger computeren en generel læringsprocedure til at finde mønstre i data. Disse mønstre bruges til at skabe regler. Da reglerne skabes ud fra mønstre i data, siger man, at metoden er datadrevet (eng. datadriven methods).
At prædiktere (forudsige) for at overleve
En prædiktion er en forudsigelse. At kunne forudsige fremtiden er yderst eftertragtet. Forestil dig, at du kunne forudsige, hvilke aktier der vil stige i værdi, eller hvilke sygdomme du vil blive ramt af i løbet af livet. I de senere år er alle virksomheder og organisationer (firmaer, forskere, organisationer, regeringer osv.) blevet stadig mere interesserede i at kunne prædiktere. Faktisk kan hele virksomhedens overlevelse afhænge af, at man kan prædiktere og gøre det med høj præcision.
Da næsten alt kan prædikteres, har prædiktionsanalyse indtaget en central plads i alle virksomheder. For en bilproducent er det eksempelvis rimeligt at prædiktere, hvor mange biler den forventes at sælge næste år (dette påvirker produktionsplanlægningen), prisudviklingen på benzin/diesel/el (dette påvirker, hvordan motorerne skal konstrueres), risikoen for at prisen på råvarer og komponenter vil stige (dette påvirker prisfastsættelsen af bilerne) og så videre. Alle virksomheder må i dag lære at prædiktere.
Det er følgende tre faktorer, der har givet anledning til den store interesse for prædiktionsanalyse:
- De fleste virksomheder indsamler store mængder data, hvilket udgør grundlaget for al prædiktion. Det er grunden til, at man i dag siger, at data er værdifulde.
- Software og hardware til prædiktionsanalyse er tilgængelige for alle.
- Evnen til at analysere data har spredt sig i samfundet. For 10 år siden var det næsten udelukkende matematikere og statistikere, der analyserede data. I dag kan hvem som helst lære at analysere data.
At kunne forudsige fremtiden er maskinlæringens hovedopgave. Maskinlæring bruges altså til at prædiktere. I det tidligere eksempel brugte vi maskinlæring til at prædiktere skoleelevers slutkarakterer. Der findes andre metoder end machine learning til at prædiktere, men i de senere år har det vist sig, at præcisionen i prædiktionerne som regel er højest med machine learning, uanset hvilken type data man analyserer.