Learning i Machine Learning (Maskinlæring)
Mennesket har en fantastisk evne til at skabe enkle repræsentationer af kompliceret information. Vi lærer gennem vores sanser (syn, hørelse, smag osv.), som har en evne til at skabe brugbare repræsentationer af alle sanseindtrykkene. Hvis vi betragter et foto af en skov, kan vi øjeblikkeligt afgøre, at det er en skov; vi behøver ikke at analysere præcis hvilken farve træerne har, eller hvordan bladene ser ud. Vores hjerne udtrækker af billedet den information, der er nødvendig for at afgøre, om det er en skov eller ej. På samme måde kan vi afgøre, om der er en cykel på fotoet. Hjernen vil lede efter to runde ting (hjulene), som sidder på en trekantformet struktur (cykelstellet). Du vil lede efter de strukturer, der er typiske for en cykel: hjul, stel, sadel, styr. Disse komponenter er repræsentationer af den større sammenhæng: cyklen.
Princippet i machine learning, og især i deep learning, er præcis det samme, nemlig at forsøge at finde repræsentationer i data. I langt de fleste tilfælde bruger man træningsdata (se tidligere), hvor der findes en ønsket klassifikation. Et eksempel følger:
Du vil udvikle software, der kan skelne hunde fra katte på fotos. Til denne opgave har du indsamlet 5000 fotos, hvoraf omtrent halvdelen er fotos af hunde. Alle fotos er vurderet/klassificeret (af et menneske) som “hund” eller “kat”. Computeren skal analysere alle fotos for at forsøge at finde repræsentationer, der er unikke for henholdsvis hund og kat.
Fundamentet for kunstig intelligens, og dermed deep learning, er at finde gode repræsentationer af data. For at en computer kan skabe repræsentationer, må den transformere (omforme) data. Formålet med transformationen er at destillere informationen, hvilket indebærer, at støj fjernes, og værdifuld information fokuseres og forstærkes. Med deep learning transformeres data som regel i flere trin, og ved hver transformation forsøger computeren at skabe informative repræsentationer af indholdet. Når tilstrækkeligt mange transformationer er foretaget, har computeren lært, hvilke repræsentationer der er typiske for henholdsvis kat og hund.
En god repræsentation er kendetegnet ved to ting: (1) den indeholder værdifuld information, og (2) den kan genskabes. På fotoet med cyklen er de runde strukturer (hjulene) meget informative, og det er vigtigt at finde dem. Desuden er det vigtigt at finde hjulene hver gang, de er på fotoet, uanset cyklens omgivelser, farver og hvor på fotoet cyklen er placeret.
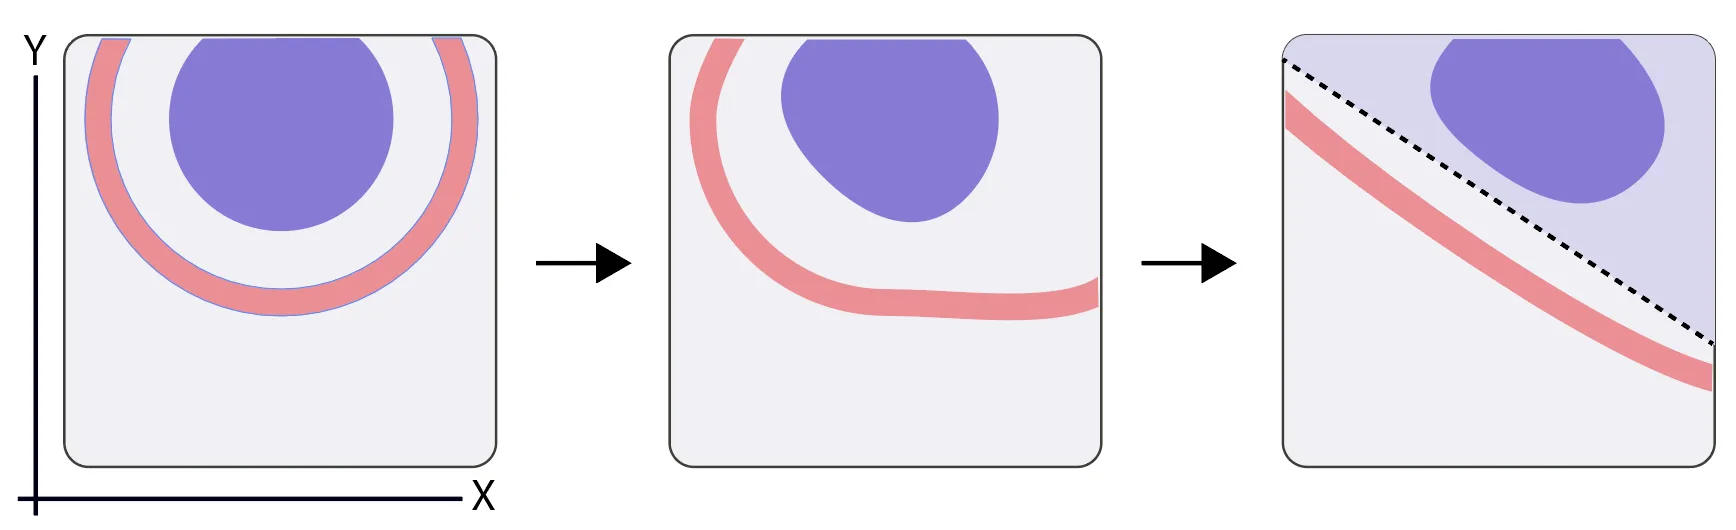
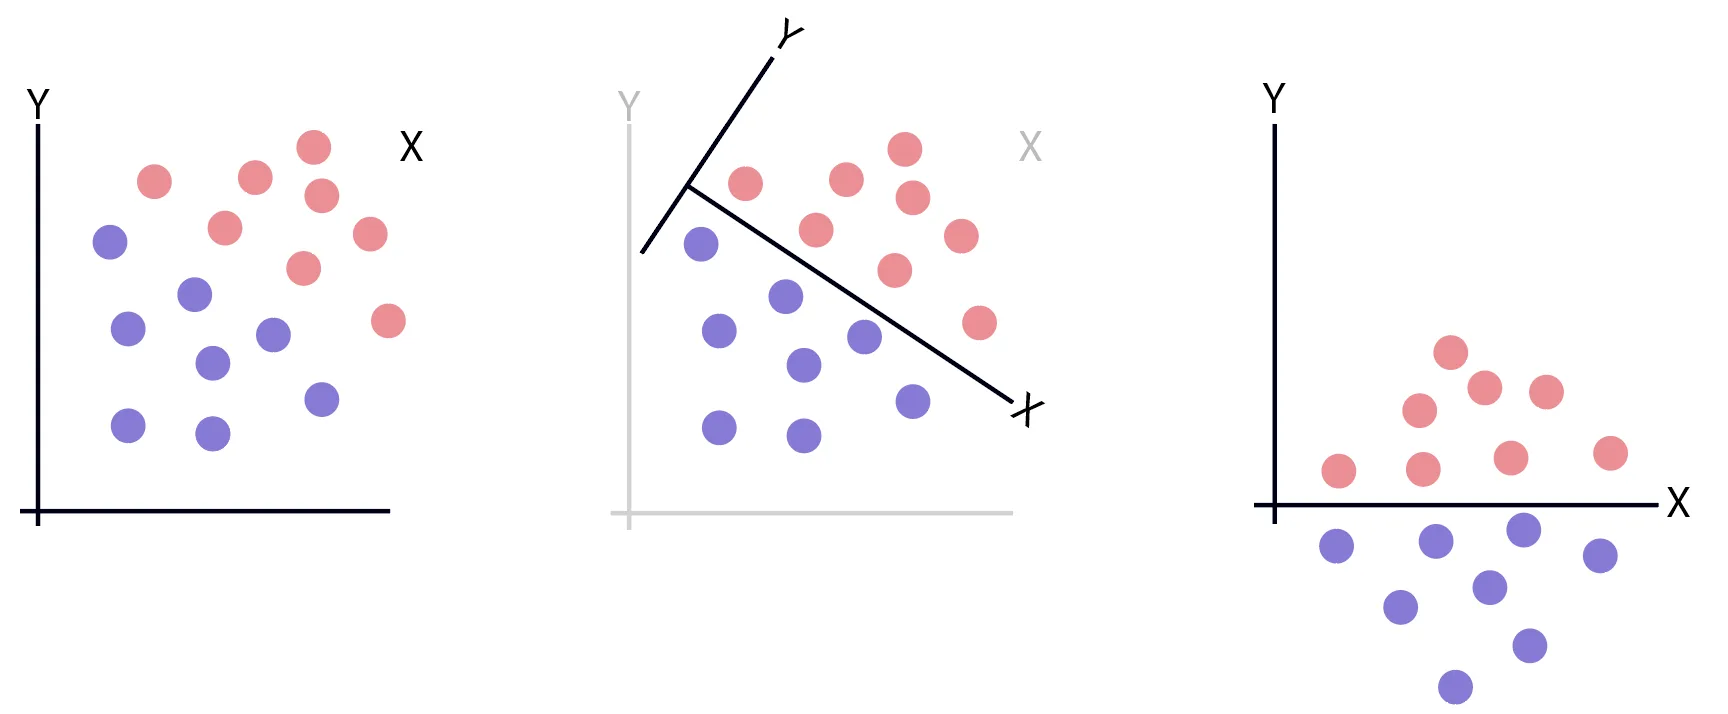
Med machine learning kan man finde repræsentationer automatisk. Ved hjælp af forskellige algoritmer leder man efter brugbare transformationer. Repræsentationerne findes ved hjælp af temmelig primitive matematiske operationer. Disse operationer kan eksempelvis indebære, at maskinen filtrerer alle værdier fra, der er større end X, eller ændrer alle koordinater på en bestemt måde (eksempler følger i Figur 1 & 2). Selv om transformationerne er enkle, viser det sig, at de kan blive ekstremt effektive, hvis maskinen får den rette tilbagekobling (feedback). Faktisk kan transformationerne, hvis maskinen får den rette tilbagekobling på dem, bruges til at løse meget komplekse opgaver, såsom at oversætte tekst, køre biler, tolke billeder osv.
Tilbagekobling (feedback)
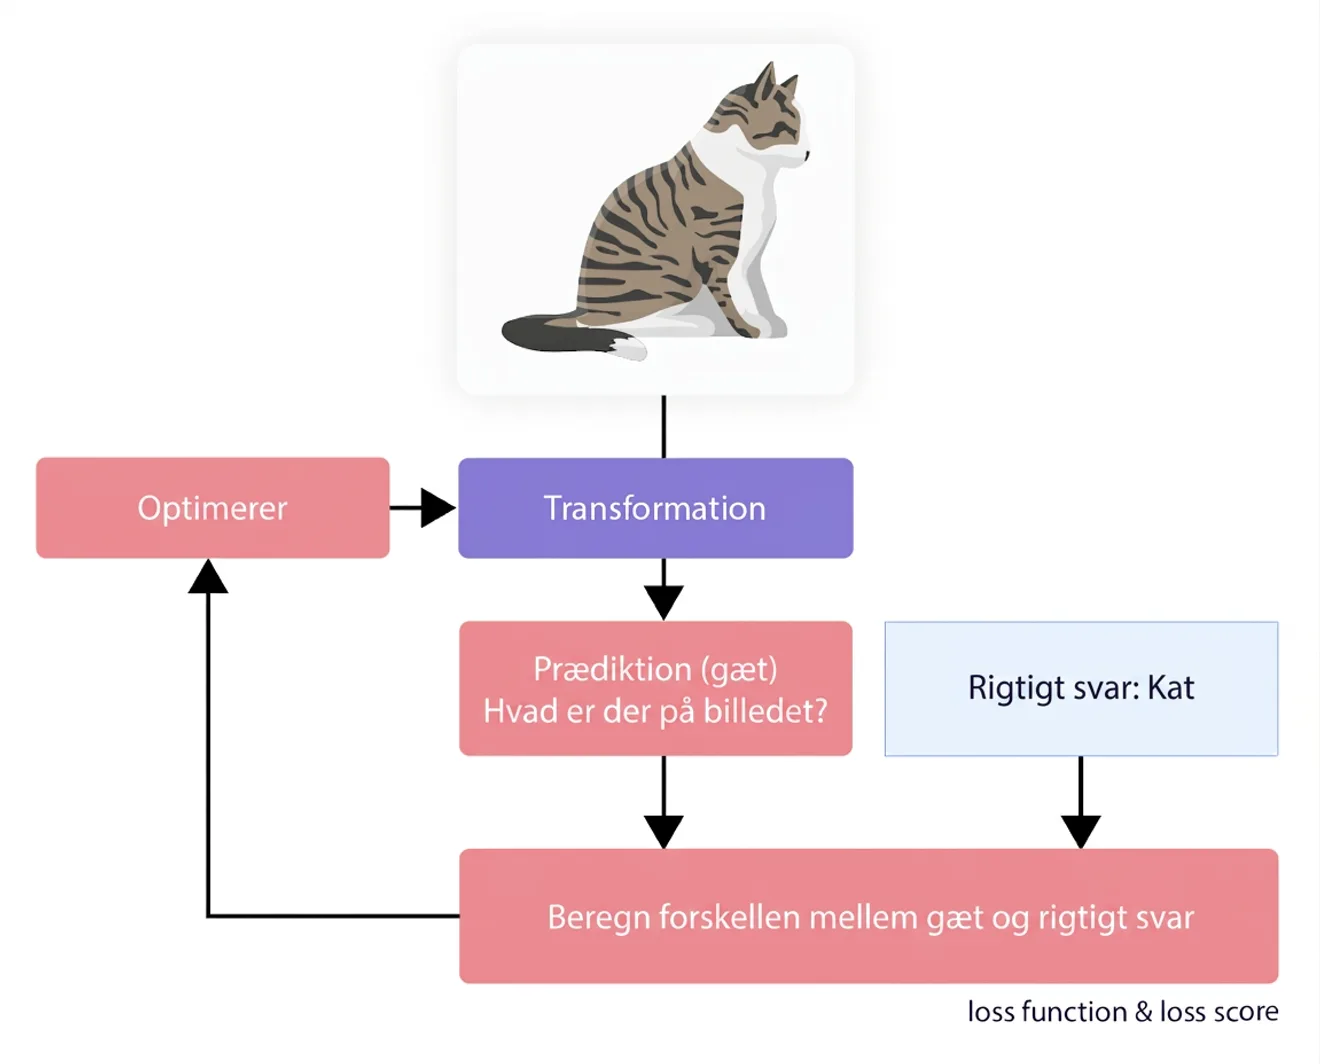
Lad os sige, at vi har 5000 fotos af hunde og katte. Vores mål er at skabe et program, der kan afgøre, om det er en hund eller en kat på fotoet. Til vores hjælp har vi en machine learning-algoritme, der kan finde nye repræsentationer i data. Maskinen transformerer data og forsøger at finde repræsentationer, der er typiske for henholdsvis katte og hunde. Maskinen afprøver disse repræsentationer ved at forsøge at gætte, hvilket dyr fotoet viser. Da maskinen har facit (det rigtige svar), kan den vurdere, om gættet var godt eller dårligt. Dette er et afgørende trin i al machine learning. Maskinen lærer nemlig ved at evaluere, hvor gode dens gæt er, og forskellen mellem maskinens gæt og det rigtige svar beregnes med en såkaldt lossfunktion (eng. Loss function). Forskellen mellem gættet og det rigtige svar beregnes som loss score. Maskinen tilbagefører loss score til en såkaldt optimizer, som kan justere transformationen, og formålet med justeringen er at opnå en transformation, der mindsker loss score. Jo mindre loss score er, desto tættere er gættet på det rigtige svar. På den måde kan machine learning ledes til at finde repræsentationer, der kan fastslå, hvad der er på fotoet.