
Dyb læring (Deep Learning)
Deep learning er en type machine learning. Når man taler om kunstig intelligens, mener man oftest forskellige anvendelser af deep learning. Princippet bag deep learning er meget enkelt. Med deep learning skabes repræsentationer i flere trin. Disse trin kaldes lag (eng. layer), og formålet er at skabe bedre repræsentationer for hvert lag. Det er ikke usædvanligt at bruge flere hundrede lag.
I deep learning er disse lag organiseret i neurale netværk (eng. neural networks). Betegnelsen er hentet fra menneskets hjerneceller (neuroner). Neurale netværk i deep learning er inspireret af hjernens neuroner. Det betyder dog ikke, at neurale netværk fungerer som hjernecellerne. Der er faktisk meget få ligheder mellem deep learning og hjernecellernes måde at lære på. Den populærvidenskabelige beskrivelse af deep learning som en digital udgave af hjernen er altså forkert. Neurale netværk med mange lag kaldes deep neural networks (DNN), eller mere generelt deep learning.
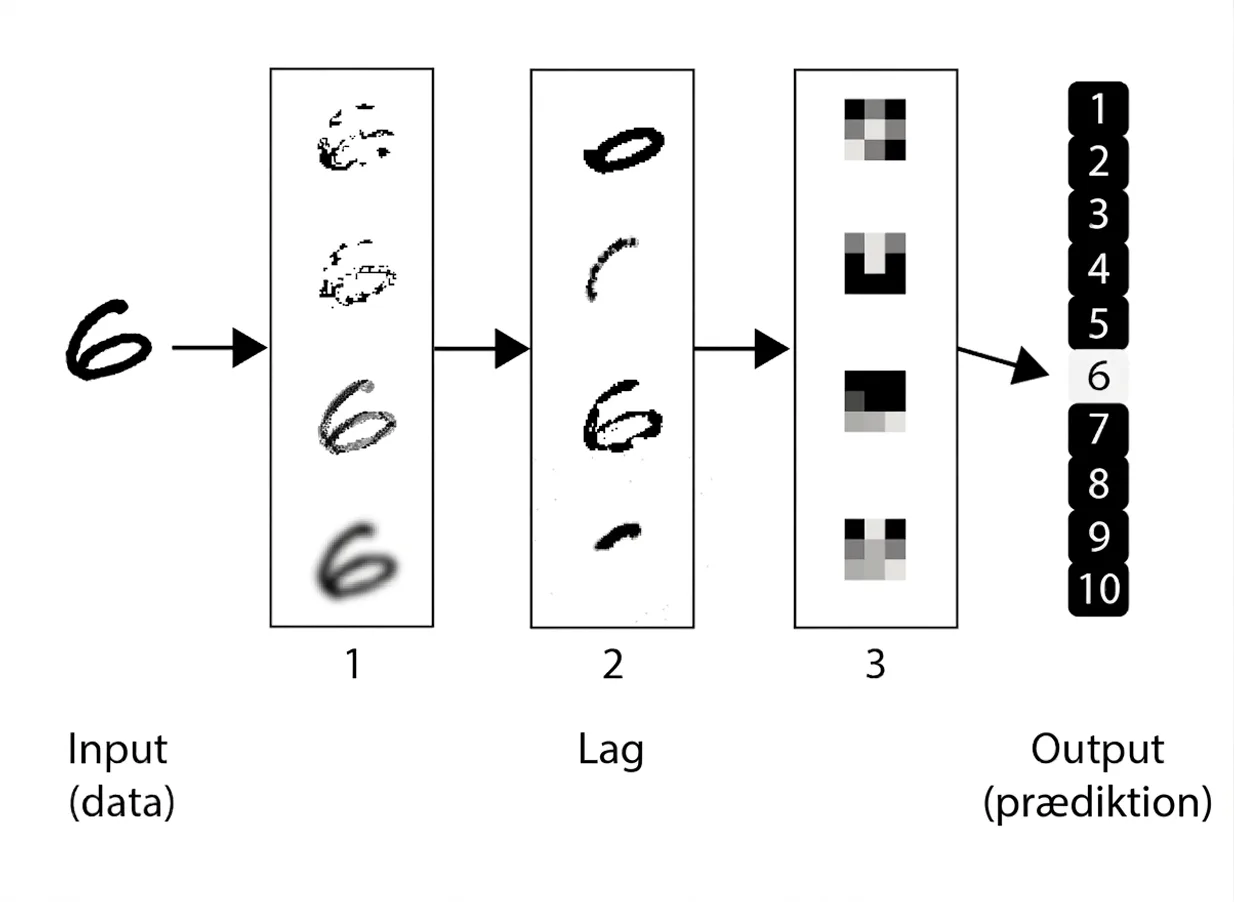
Det neurale netværks opgave er at transformere input (data, der føres ind) til repræsentationer, der bliver stadig mere forskellige (sammenlignet med input), men samtidig mere informative. Det neurale netværk destillerer og filtrerer informationen, så kun de brugbare og karakteristiske træk er tilbage i det sidste lag. I det sidste lag er informationen kondenseret i en sådan grad, at det neurale netværk ud fra aktiveringen i laget kan afgøre, hvilket ciffer det er.
Hvad sker der i et lag?
Hvert lag skal modtage information (tal) fra det foregående lag og behandle disse tal, før de sendes videre til det næste lag. Efterhånden som informationen strømmer gennem lagene, ekstraheres brugbare repræsentationer.
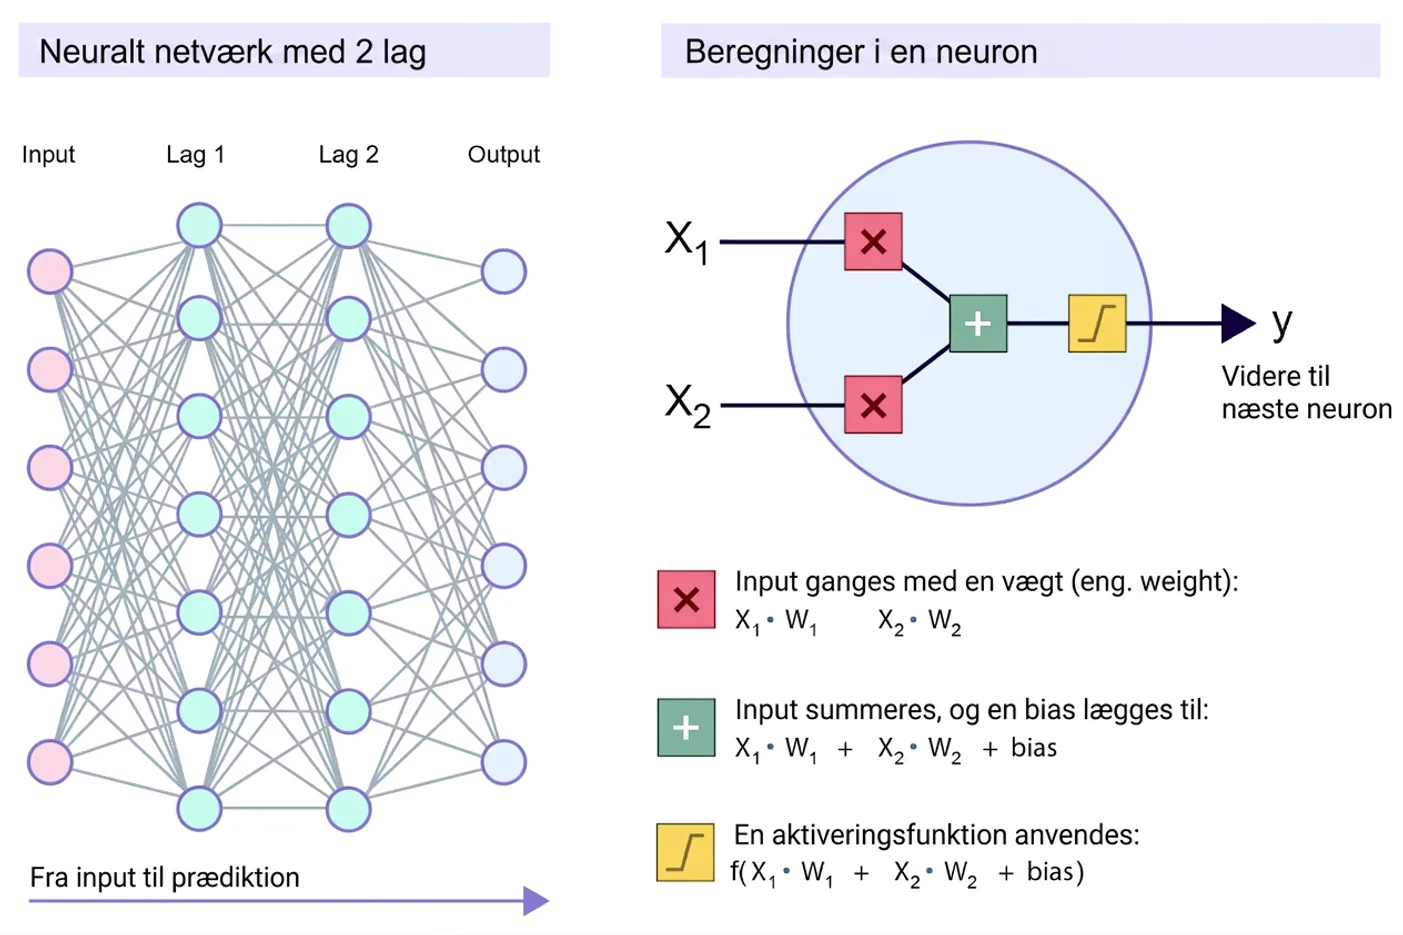
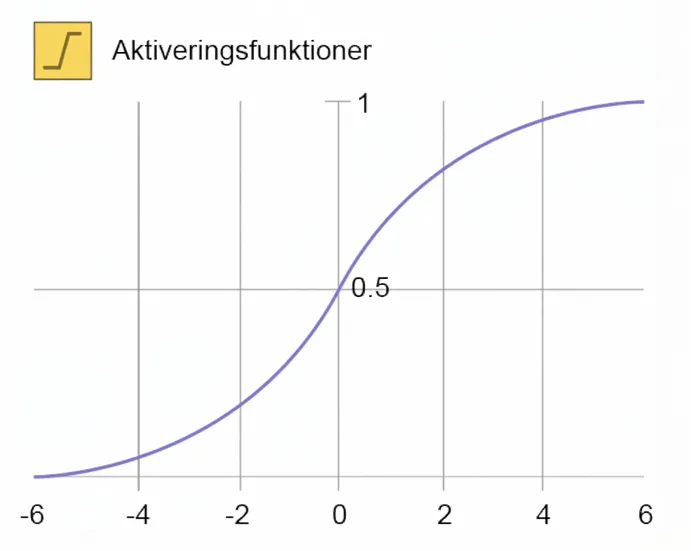
I hvert lag er det neuroner (synonym: noder), der modtager, behandler og sender information videre. I figuren ovenfor modtager neuronet x1 og x2, udfører beregninger og sender derefter værdien y videre. I neuronet multipliceres hvert input (indkommende tal) med en vægt. Derefter summeres alle input, og en bias lægges til. Resultatet passerer derefter en aktiveringsfunktion. Formålet med aktiveringsfunktionen er at omdanne slutresultatet til et lethåndterligt tal. I eksemplet ovenfor er aktiveringsfunktionen en sigmoid funktion. Denne funktion omdanner alle indkommende værdier til et tal mellem 0 og 1. Store positive tal nærmer sig 1, og store negative tal nærmer sig 0.
Vægtene er afgørende for det neurale netværk. Med de rette vægte vil det neurale netværk fungere godt og dermed klare den opgave, det er udviklet til. Udfordringen består i at finde de rette vægte. Da det neurale netværk kan indeholde millioner af vægte, bliver dette en meget svær udfordring. Det bliver endnu sværere, når vi konstaterer, at en justering af en enkelt vægt kan påvirke hele det neurale netværk. Den store udfordring er altså at justere alle disse vægte, så de bliver optimale til formålet.
Vægtene justeres ved hjælp af en loss-funktion (diskuteret ovenfor). Loss-funktionen beregner ganske enkelt, hvor stor forskellen er mellem det neurale netværks aktuelle gæt og sandheden. Denne forskel kaldes loss score. Hvis loss score er stor, er forskellen mellem gættet og sandheden stor, hvilket er dårligt. Hvis loss score er lille, har det neurale netværk lavet et godt gæt. Loss score fungerer som et tilbagekoblingssignal (feedback signal), der bruges til at justere vægtenes værdi. Det betyder, at det neurale netværk evaluerer sin egen evne, tilbagefører resultatet til sig selv og derefter justerer vægtene for at forbedre sin evne. Vægtene justeres så i den retning, der gør loss score mindre.
Hvert neuralt netværk har en optimerer (eng. optimizer). Det er optimererens opgave at håndtere tilbagekoblingen og justere vægtene i det neurale netværk. Optimereren bruger en algoritme, der kaldes backpropagation algorithm.
Når det neurale netværk aktiveres første gang, er værdierne af alle vægtene helt tilfældige. Det fører til, at det neurale netværks gæt bliver dårligt (loss score bliver stor) i første omgang. Men for hvert eksempel, som det neurale netværk træner på, justerer det vægtene i den rigtige retning, og så forbedres evnen gradvist. Hvis det neurale netværk får lov til at træne på tusindvis, eller endda hundredtusindvis, af eksempler, minimeres loss-funktionen til sidst, hvilket betyder, at det neurale netværk har maksimeret sin evne.
Denne simple mekanisme (hvor hvert neuron modtager input, udfører en enkel transformation og sender et output videre) viser sig at være ekstremt kraftfuld.
Et neuralt netværk kan have et vilkårligt antal lag, og i disse lag kan der være et vilkårligt antal neuroner. Princippet for neurale netværk er det samme uanset netværkets størrelse: før inputværdier ind, lad dem strømme gennem lagene, og få til sidst et output i det sidste lag. I et neuralt netværk kaldes det allerførste lag input layer, og det allersidste lag (laget før label) kaldes output layer. Alle lag derimellem kaldes hidden layers. Efterhånden som data passerer disse lag, lærer algoritmen, hvilke mønstre der findes, og hvordan disse mønstre korrelerer med det udfald, der studeres.
Hvad er bias?
Bias er endnu en parameter, der justeres, når det neurale netværk kalibreres. Ved at justere bias kan man øge eller mindske et neurons aktivitet. Det betyder, at der er to ting, der justeres, når det neurale netværk kalibrerer sig selv: vægte og bias.
Princippet bag deep learning
Det neurale netværk skaber repræsentationer, efterhånden som informationen strømmer gennem lagene. Når vægtene justeres, bliver nogle neuroner stærkere, mens andre neuroner bliver svagere eller endda slukkes. Det neurale netværk guider sig selv ved hjælp af loss-funktionen. Deep learning kan således betragtes som en proces, hvor data filtreres i flere trin, og efterhånden som data strømmer gennem lagene, dechifreres de.
Denne mekanisme fører til, at lagene ekstraherer nøglekomponenter i data, og ved hjælp af disse lærer computeren, hvilke komponenter der adskiller hunde og katte.
Når en computer skal tolke indholdet af et billede, kan den ikke umiddelbart se de større træk i billedet. I computeren omdannes billedet nemlig til et gitter af tal, og disse tal føres derefter ind i det neurale netværk, hvor informationen transformeres. Under transformationen ekstraheres den vigtige information. Computeren kan så opdage linjer, hjørner, cirkler osv. Kombinationen af forskellige geometrier bruges derefter til at skelne mellem forskellige objekter.
Hvorfor er deep learning så effektivt?
Der findes mange metoder til at prædiktere. Nogle metoder er generelle og kan prædiktere på mange forskellige typer data, mens andre metoder er mere specifikke. Langt de fleste metoder kræver en vis grad af feature engineering, hvilket betyder, at rådata skal bearbejdes, før de kan analyseres. Det kan for eksempel betyde, at man manuelt skal omdanne indholdet af et foto til et format, der kan analyseres. Dette manuelle arbejde er som regel meget besværligt og kompliceret. Med deep learning er feature engineering fuldstændig automatiseret. Det neurale netværk klarer dette helt automatisk, uanset hvordan data ser ud. I modsætning til andre analysemetoder kan deep learning håndtere tabeldata, billeder, video.