
Et ensemble skaber bedre musik. Tusind prædiktionsmodeller er bedre end én.
Mennesket har en tendens til at strukturere sin tænkning og sine beslutninger. En struktur, som vi ofte bruger (både bevidst og ubevidst), er hierarkier. Du skaber og bruger hierarkier hver dag. Forestil dig, at du befinder dig i en butik, hvor du forsøger at træffe en beslutning om at købe en computer. For at træffe en klog beslutning begynder du med at spørge dig selv: “Har jeg råd til at købe en ny computer?”. Hvis svaret på dette spørgsmål er “nej”, afstår du sandsynligvis fra at købe computeren. Hvis svaret på spørgsmålet er “ja”, går du formentlig videre til det næste spørgsmål: “Har jeg brug for en ny computer?”. Hvis svaret er “nej”, afstår du sandsynligvis fra at købe computeren. Hvis svaret er “ja”, spørger du måske dig selv: “Er dette den rigtige computer for mig?”. Du har med andre ord forsøgt at træffe en beslutning ved at stille dig selv en række spørgsmål med en hierarkisk struktur. Som det fremgår af billede X, ligner denne type beslutningsforløb et træ, der står på hovedet, og man kalder det et beslutningstræ (eng. decision tree).
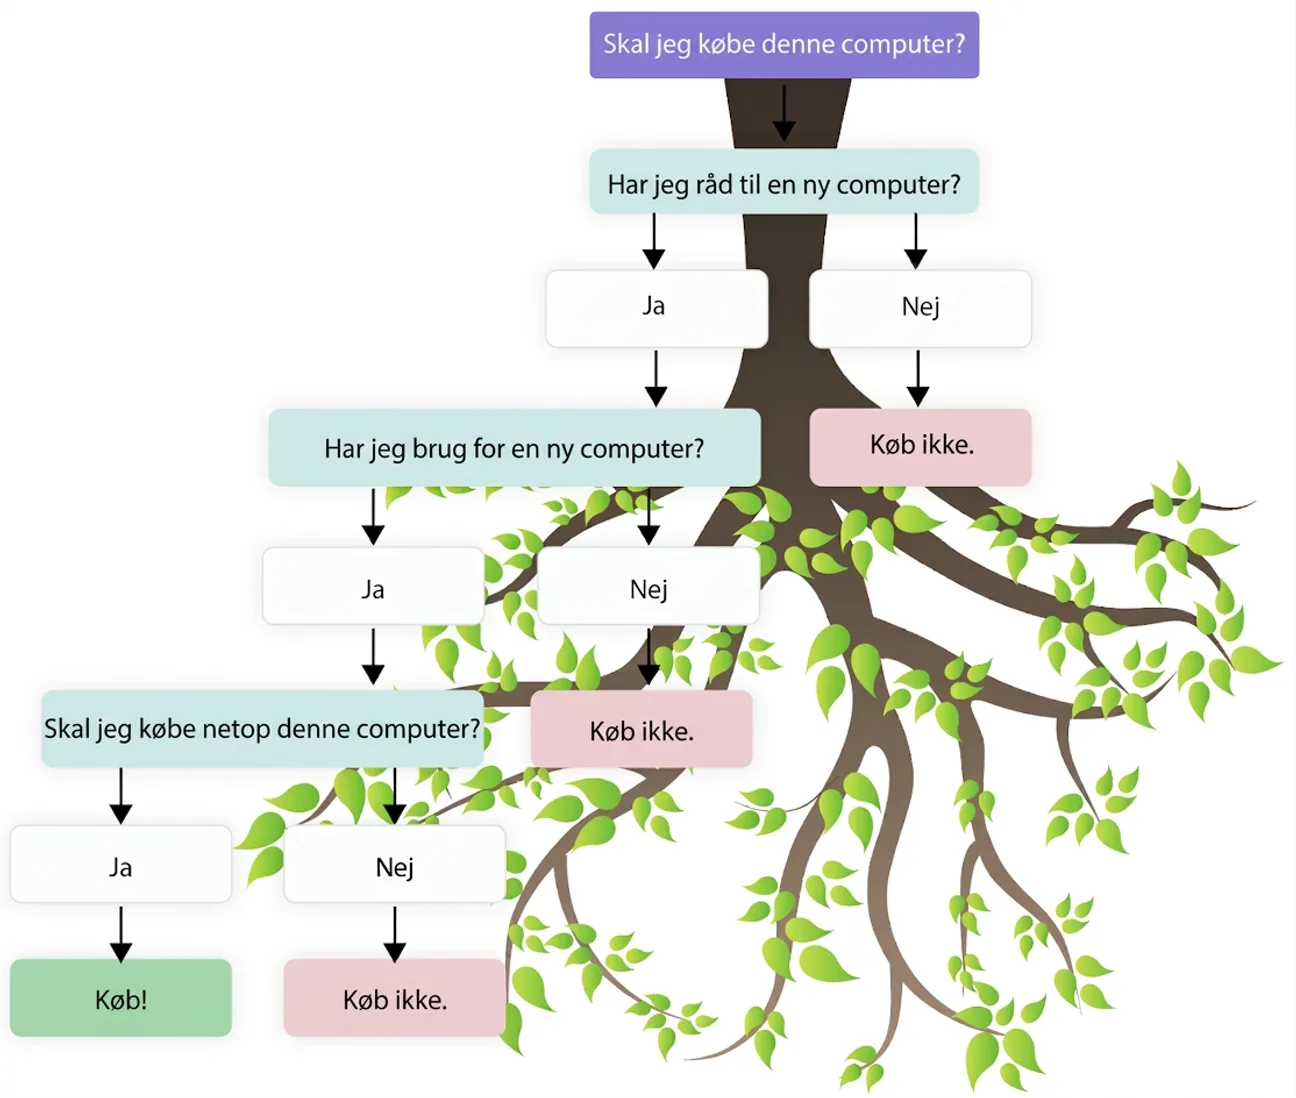
Beslutningstræer: en genial idé
I dag dominerer beslutningstræerne næsten al machine learning, der vedrører strukturerede data (dvs. data, der præsenteres i rækker og kolonner). På Kaggle (www.kaggle.com) konkurrerer tusindvis af eksperter om at skabe de bedste prædiktionsmodeller, og konkurrenceresultaterne viser, at beslutningstræer oftest klarer sig bedre end nogen anden model for strukturerede data. Faktisk bruger du allerede beslutningstræer hver dag, f.eks. når du bruger Googles søgemaskine eller din e-mailtjeneste. Forklaringen på, at beslutningstræer kan bruges til prædiktion, er enkel: i ovenstående eksempel kan du anvende beslutningsalgoritmen på en anden computer og vurdere, om du hellere burde købe den.
Med moderne machine learning skaber man beslutningstræer på en meget sofistikeret måde. Man bruger en generel læringsprocedure, som ud fra mønstrene i data skaber regler og dermed bygger træet. Træets struktur (og dermed prædiktionsmodellen) bliver således datadrevet (se tidligere diskussion). Vi skal nu gennemgå præcis, hvordan disse træer skabes, og hvordan de bruges.
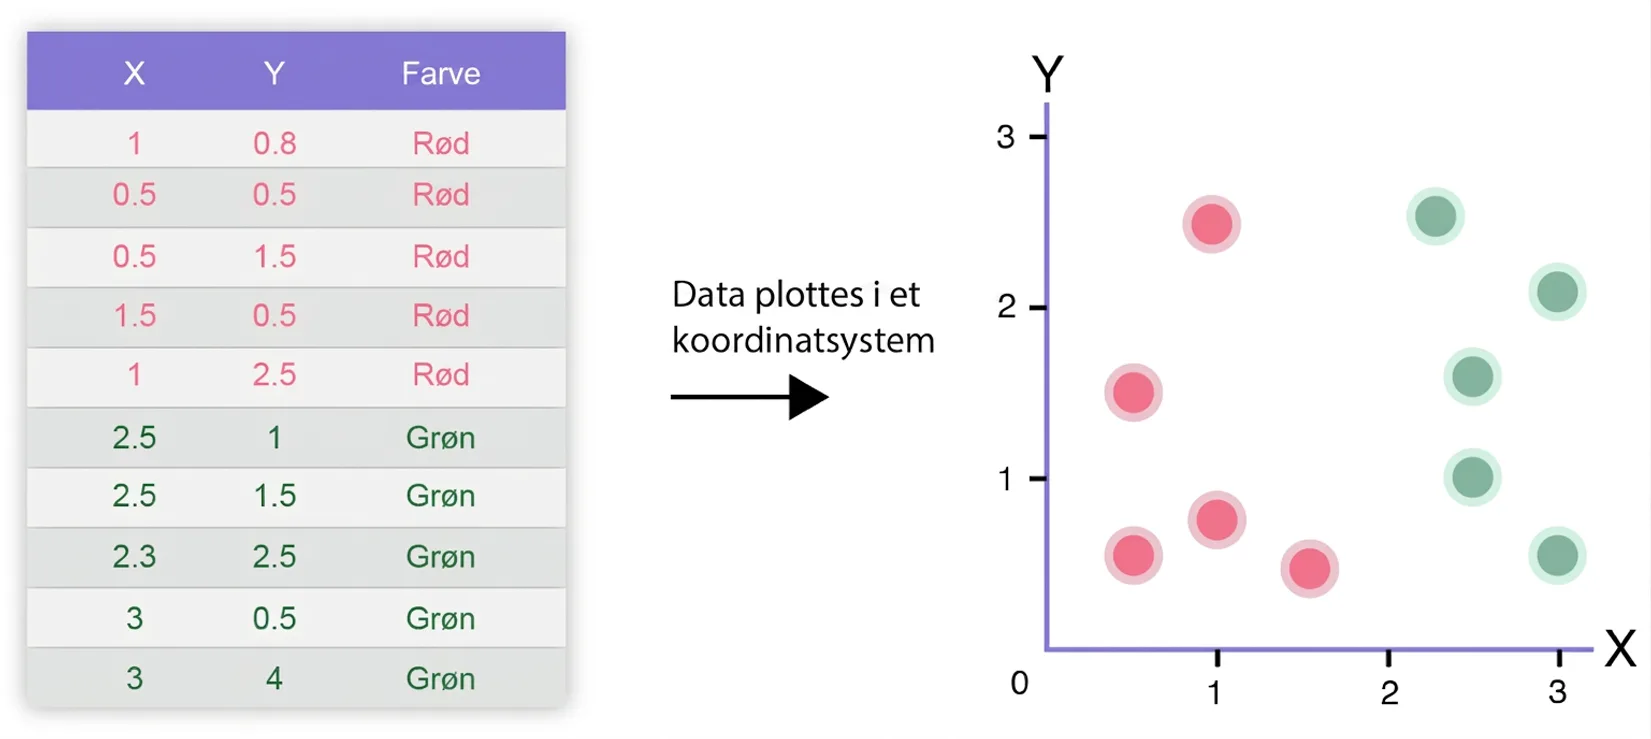
I nedenstående figur præsenteres de samme data i tabellen og koordinatsystemet. Forestil dig, at vi skal tilføje et punkt i koordinatsystemet, og at punktets x-værdi er 2,0. Hvilken farve tror du, punktet vil have? Sandsynligvis grøn, og dermed har du skabt og evalueret et beslutningstræ i hovedet! Beslutningstræets struktur ses i den næste figur.
I dette beslutningstræ bruges en enkelt regel baseret på x-værdien. Hvis x er mindre end 2, vælger vi den venstre gren, og der ser værdierne ud til at være røde. Hvis x er 2 eller større, vælger vi den højre gren, og der ser observationerne ud til at være grønne. Hver observation vil således blive testet for at se, om x er mindre end 2, hvorefter der træffes en beslutning om, hvilken gren der skal vælges. Dette punkt, hvor data skal skilles ad, kaldes en knude. Selve opdelingen kaldes split.
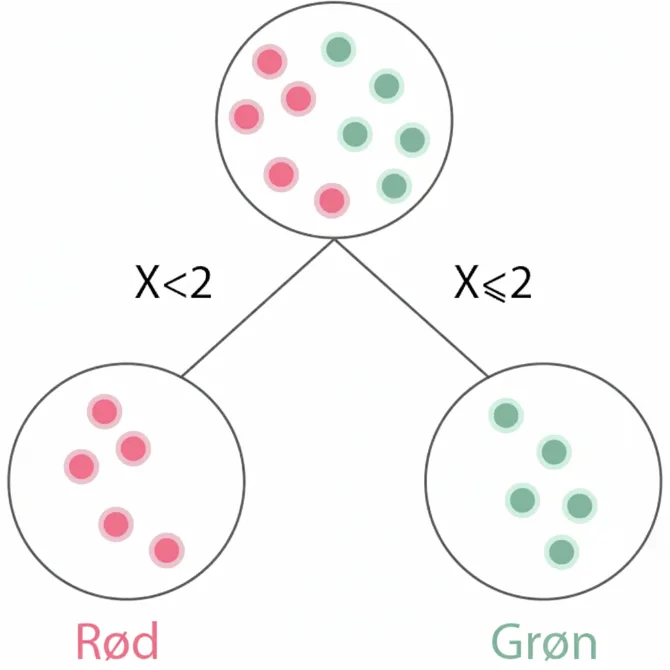
Dette beslutningstræ kan altså bruges til at gætte, hvilken farve en observation vil have, baseret på x-værdien. Vi kan altså prædiktere farve baseret på en af variablerne. Man siger, at beslutningstræet kan bruges til at klassificere observationerne (som grønne eller røde).
I det næste koordinatsystem ser vi nu tre forskellige farver på observationerne. Vi prøver at bruge vores første beslutningstræ. X-værdier, der er 2 eller større, vil stadig blive klassificeret som grønne, men værdier mindre end 2 kan ikke klassificeres korrekt hver gang, fordi nogle af observationerne er blå. Vi har således brug for endnu en knude!
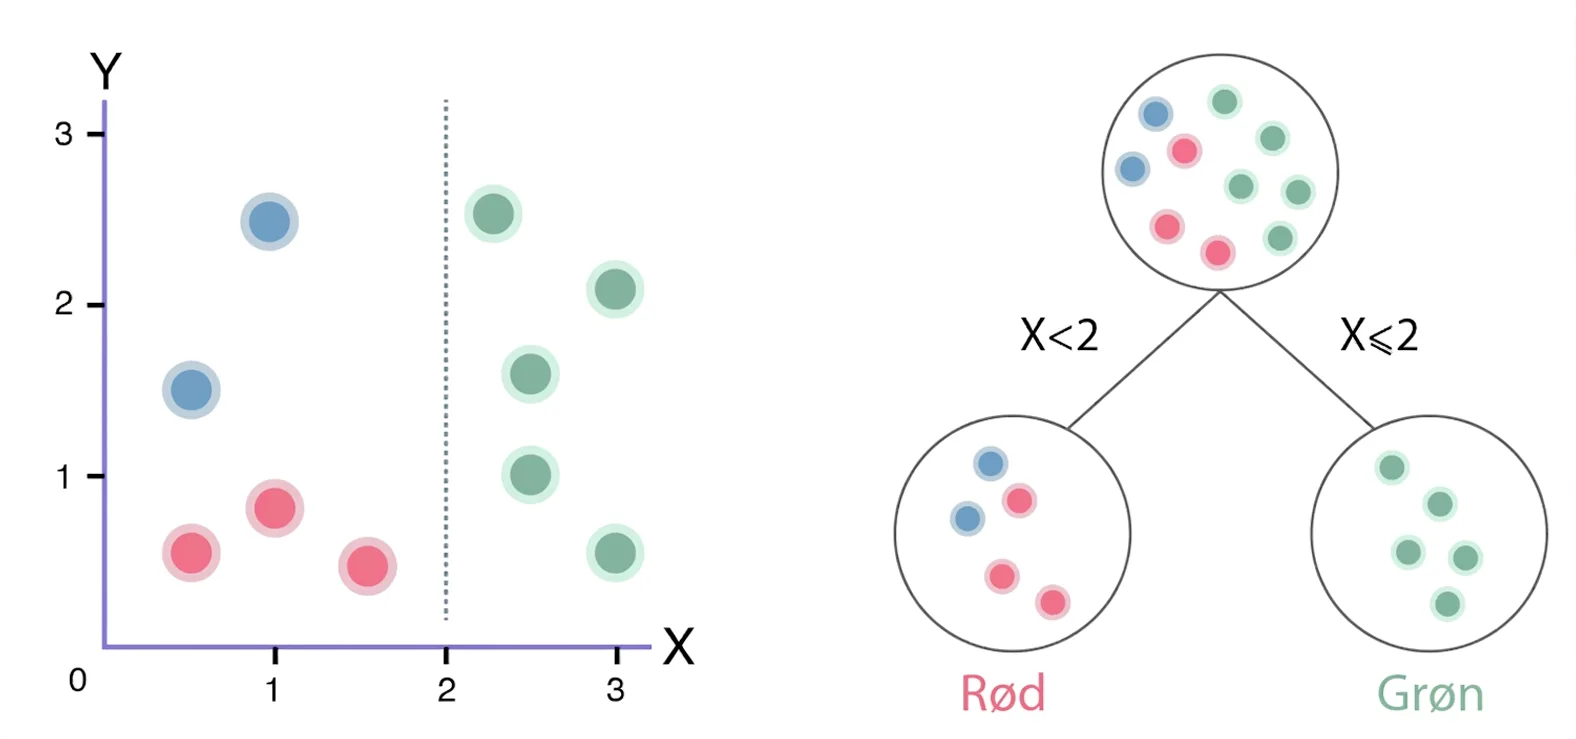
Vi skaber nu endnu en knude og en ny regel baseret på y-værdien. Hvis y-værdien er mindre end 1, klassificerer vi observationen som rød, og ellers som blå, som følger:
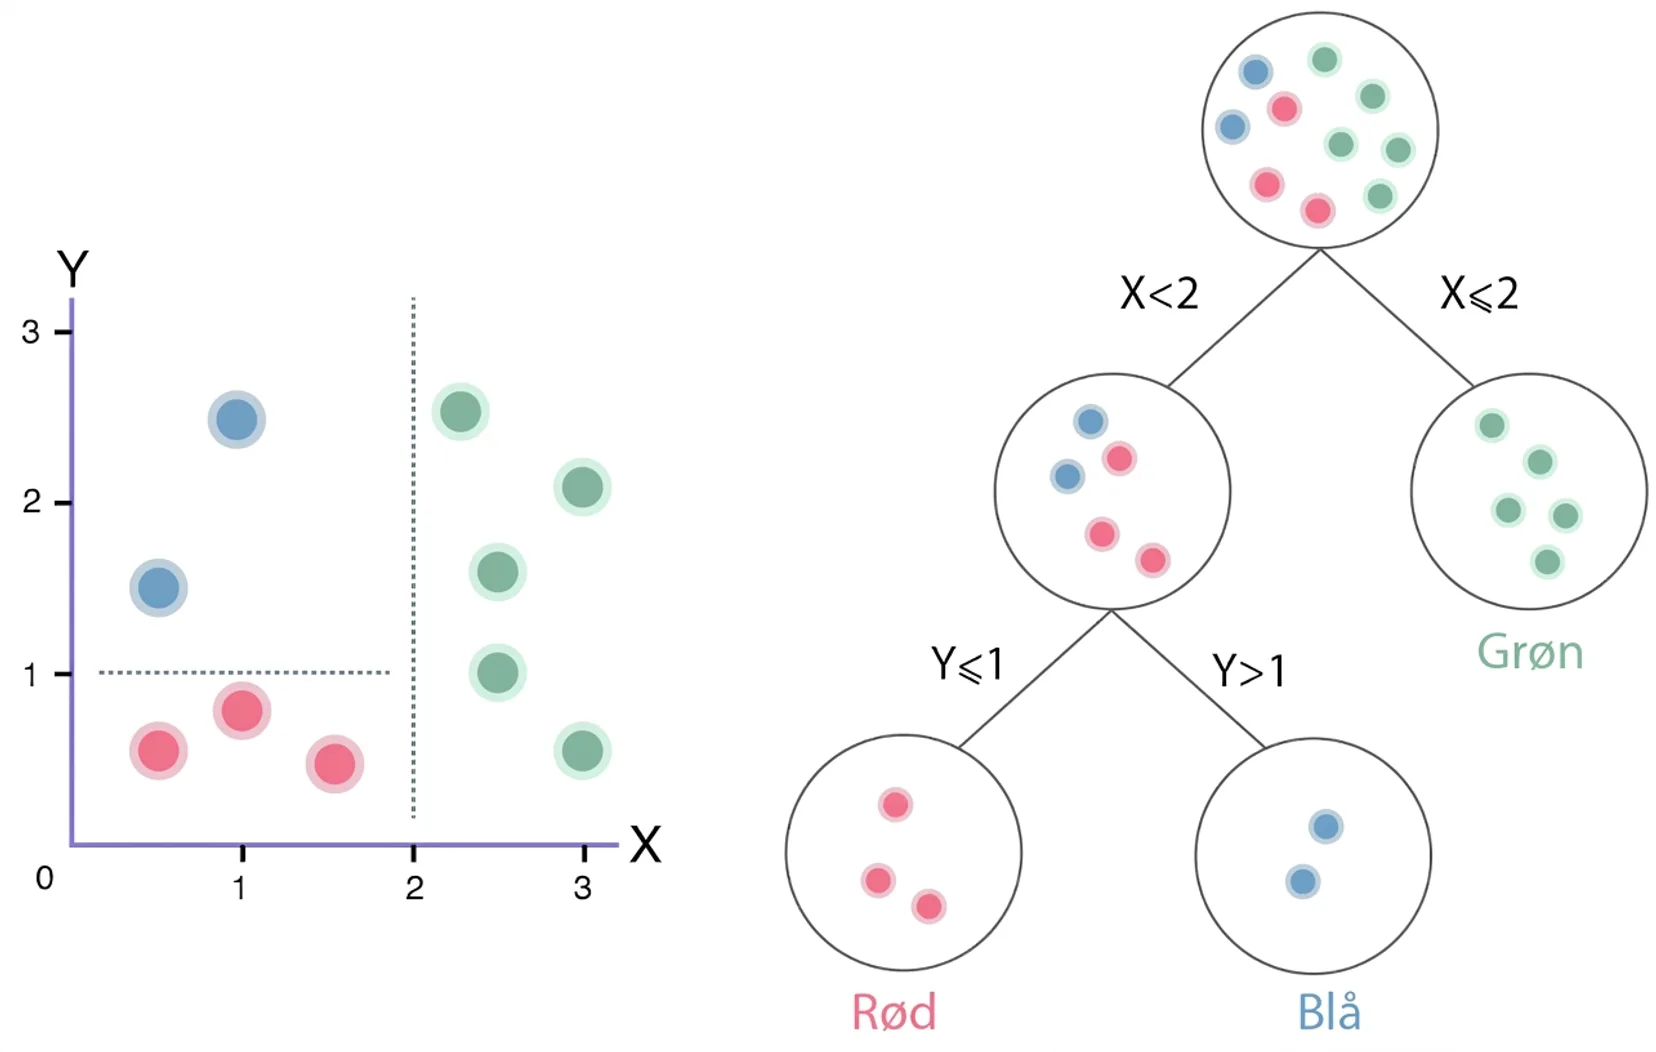
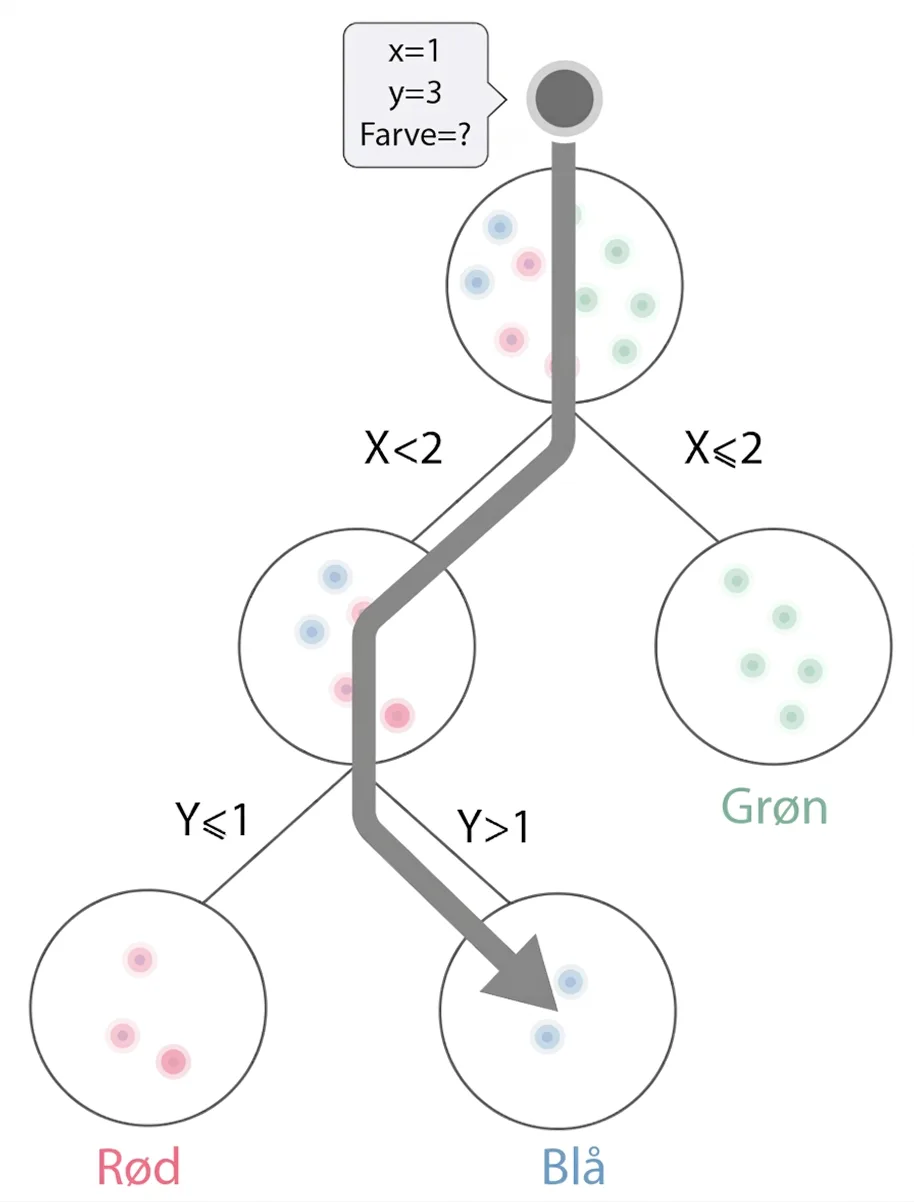
Dette er faktisk hele princippet for at skabe beslutningstræer. Som det fremgår af denne diskussion, kan vi nu bruge vores beslutningstræ til at prædiktere, hvilken farve en ny observation vil have, baseret på x- og y-værdien. Træet kan således bruges som en prædiktionsmodel. Du ser et eksempel på dette i den næste figur, hvor vi lader en helt ny observation løbe gennem beslutningstræet for til sidst at gætte, hvilken farve observationen sandsynligvis har.
Machine learning med beslutningstræer
Hvert enkelt træ er en prædiktionsmodel. Princippet for at lave machine learning med beslutningstræer er at skabe hundredvis eller tusindvis af træer og bruge dem samlet til at prædiktere. Man bruger altså et datasæt til at skabe hundredvis eller tusindvis af træer, som derefter bruges til at prædiktere. Ligesom med neurale netværk skal træerne trænes og evalueres, hvilket gøres efter de samme principper. Da disse prædiktionsmodeller består af mange enkeltstående modeller (dvs. enkeltstående træer), kaldes de også ensemblemetoder (eng. ensemble methods), hvilket henviser til, at man bruger et ensemble af prædiktionsmodeller. Undertiden bruges også betegnelsen træbaseret metode (eng. tree-based method).
At konstruere mange træer
Som regel konstruerer man altså flere hundrede eller tusindvis af beslutningstræer, når man laver machine learning med beslutningstræer. Man skaber disse træer ud fra det samme datasæt. Hvis du for eksempel studerer besøgende på et website og har data om 1000 besøgende, er det dette datasæt, der bruges til at bygge alle træerne. Det gøres ved, at hvert træ kun må bruge en lille andel (oftest en tredjedel) af det samlede datasæt. Denne andel skal desuden udvælges helt tilfældigt. Det første træ får altså lov at analysere en tilfældigt udvalgt tredjedel af alle de besøgende. Det næste træ får en ny, tilfældigt udvalgt tredjedel af alle de besøgende og bygger træet baseret på deres information. Det samme gælder det tredje, fjerde, femte og alle efterfølgende træer. Hvert træ bygges altså med en tilfældigt udvalgt delmængde af data. På den måde bliver hvert træ unikt.
At finde optimale knuder og splits
Følgende koordinatsystem viser det samme datasæt med forskellige regler for at adskille datapunkterne. Til venstre ser vi splits, der formår at adskille alle farverne fra hinanden. Til højre ser vi, at kriterierne (reglerne) ikke resulterer i, at punkterne kan adskilles fuldstændigt. For at træets prædiktion skal blive god, må det finde regler, der kan adskille observationerne fra hinanden. For at lykkes med dette må computeren evaluere hvert split. Et godt split er defineret ved, at de grupper, der skabes, adskiller sig så meget som muligt fra hinanden med hensyn til det, der studeres, hvilket i dette tilfælde er farve.
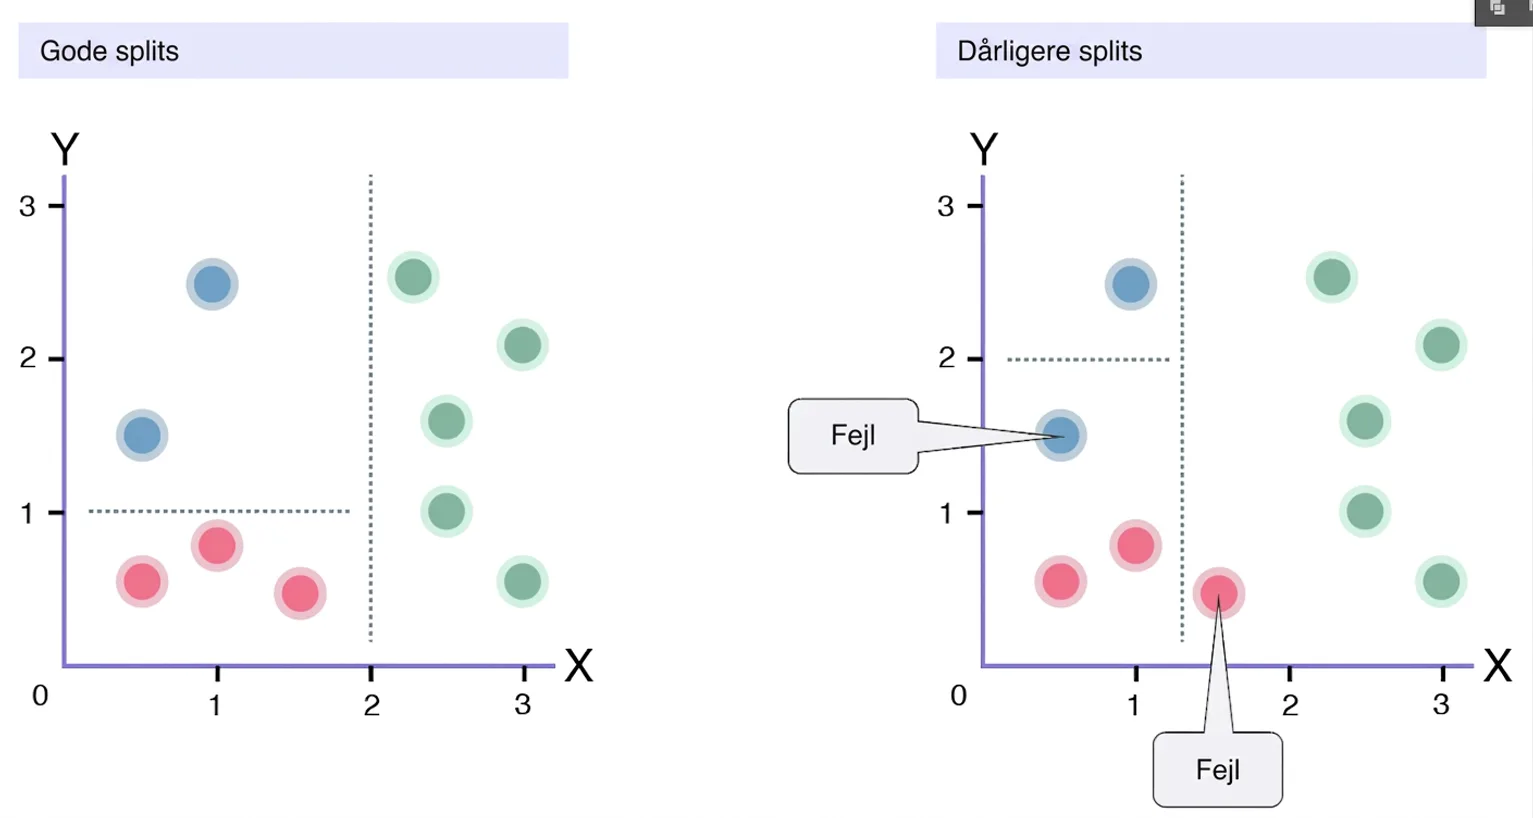
Der findes en række forskellige varianter til at foretage denne evaluering. Alle varianterne fungerer ved at beregne, hvor godt forskellige splits kan adskille farverne fra hinanden. Computeren kan altså prøve sig frem for at se, hvilket split der giver maksimal adskillelse af observationerne med hensyn til deres farve.
Denne metode til at finde optimale splits er generel og kan bruges på alle typer strukturerede data, dvs. data i tabelformat (kolonner og rækker). Det har ingen betydning, om man studerer patienter med kræft, besøgende i en webshop, solstråler eller bilbatterier. Beslutningstræer er ekstremt kraftfulde og kan prædiktere på alle typer strukturerede data. Forklaringen på dette er den generelle læringsprocedure, dvs. den beregning, der foretages for at skabe hvert split. Denne måde at “lære” på ligner faktisk menneskets måde at tænke på og gives her en eksakt matematisk funktion.