
At sammenligne og vælge mellem flere modeller
Hvis målet er at udvikle en prædiktionsmodel med høj prædiktiv evne, skal forskellige modeller testes og sammenlignes. At nøjes med at skabe og evaluere én model er en kardinalfejl, hvis formålet er at bruge modellen til at lave prædiktioner. For at evaluere og sammenligne forskellige modeller kræves et standardiseret arbejdsforløb, som er opsummeret i det følgende flowdiagram.
graph TD;
    D(1. Data) --> |"75%"| TD(2. Træningsdata);
    D --> |"25%"| Test(7. Testdata);
    TD --> Kand(3. Kandidatmodeller) --> CV(4. Cross-Validation<br>Krydsvalidering)
CV --> BP(5. Find de bedste parametre)
TD --> OM(6. Træn modellen igen)
BP-->OM
OM-->Test
Test-->SE(8. Endelig evaluering)
Kandidatmodeller (Candidate models)
Begrundelsen for at teste forskellige typer af modeller er, at vi ikke på forhånd ved, hvilken model der er bedst. Eksempler på modeller for kontinuerlige udfaldsmål er lineær regression, random forest, gradient boosting, etc. For binære udfald kan vi teste logistisk regression, random forest, gradient boosting, etc. Faktisk kan vi for hver type af model teste forskellige specifikationer af modellen. Man indser ret hurtigt, at man for enhver given opgave kan teste et meget stort antal modeller, og det er et tidskrævende arbejde. Heldigvis findes der en række pakker og funktioner i R, som gør dette arbejde lettere. Det diskuteres senere.
Training
Når et antal forskellige modeller er udvalgt, skal de trænes (oplæres) på en delmængde af alle data. En tommelfingerregel er, at 70-80% af data bruges til træning ("training set"). Derefter testes modellerne på testdata ("test set"), som udgør de resterende 20-30% af data.
Overfitting
At evaluere modellerne på testdata er et simpelt, men genialt træk. Stort set altid udviser modeller høj prædiktiv evne på træningsdata, hvilket forklares af, at modellerne har set alle observationerne i træningsdata. Det betyder, at modellerne kender mønstre og sammenhænge i træningsdata. Dette resulterer i en falsk høj præcision i træningsdata. Den store udfordring er at skabe en model med høj præcision på fremtidige data (som modellen aldrig har observeret), og det er formålet med testdata. Modellerne må aldrig trænes på testdata. Observationerne i testdata er således "nye" for modellerne. Præcisionen på testdata viser modellens forventede præcision på nye og fremtidige data.
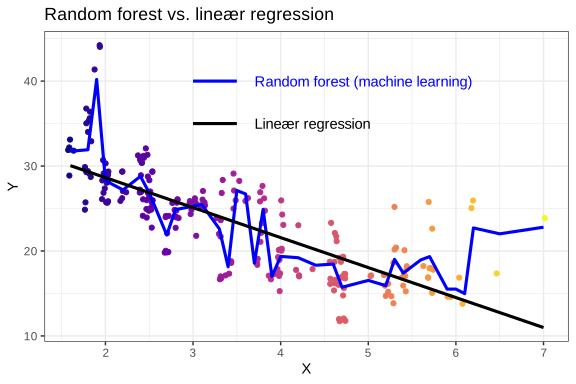
Vigtigheden af ovenstående bliver endnu tydeligere med machine learning. De fleste modeller inden for machine learning skaber ikke lineære sammenhænge mellem og . Modellerne er i stand til meget fleksible funktioner, som følger data yderst nøje. Det betyder, at selv små, ubetydelige afvigelser i sammenhænge kan opfanges og modelleres. Dette illustreres i nedenstående figur, hvor resultatet af to prædiktionsmodeller sammenlignes. Den ene er klassisk lineær regression, og den anden er machine learning med random forest. Begge modeller er trænet og testet i samme datamængde (testdata er ikke blevet brugt). Billedet viser, at random forest er en meget fleksibel model, som følger data meget præcist. Det kan virke imponerende, men det er en stor ulempe. Fænomenet hedder overfitting og betyder, at modellens prædiktion er fremragende i træningsdata (på grund af modellens fleksibilitet), og dette vildleder modellen, hvis den testes på nye data, som den endnu ikke har observeret. En god model kan generaliseres til testdata og udvise høj præcision på observationer, den endnu ikke har oplevet.
Krydsvalidering (Cross Validation)
k-Fold Cross Validation
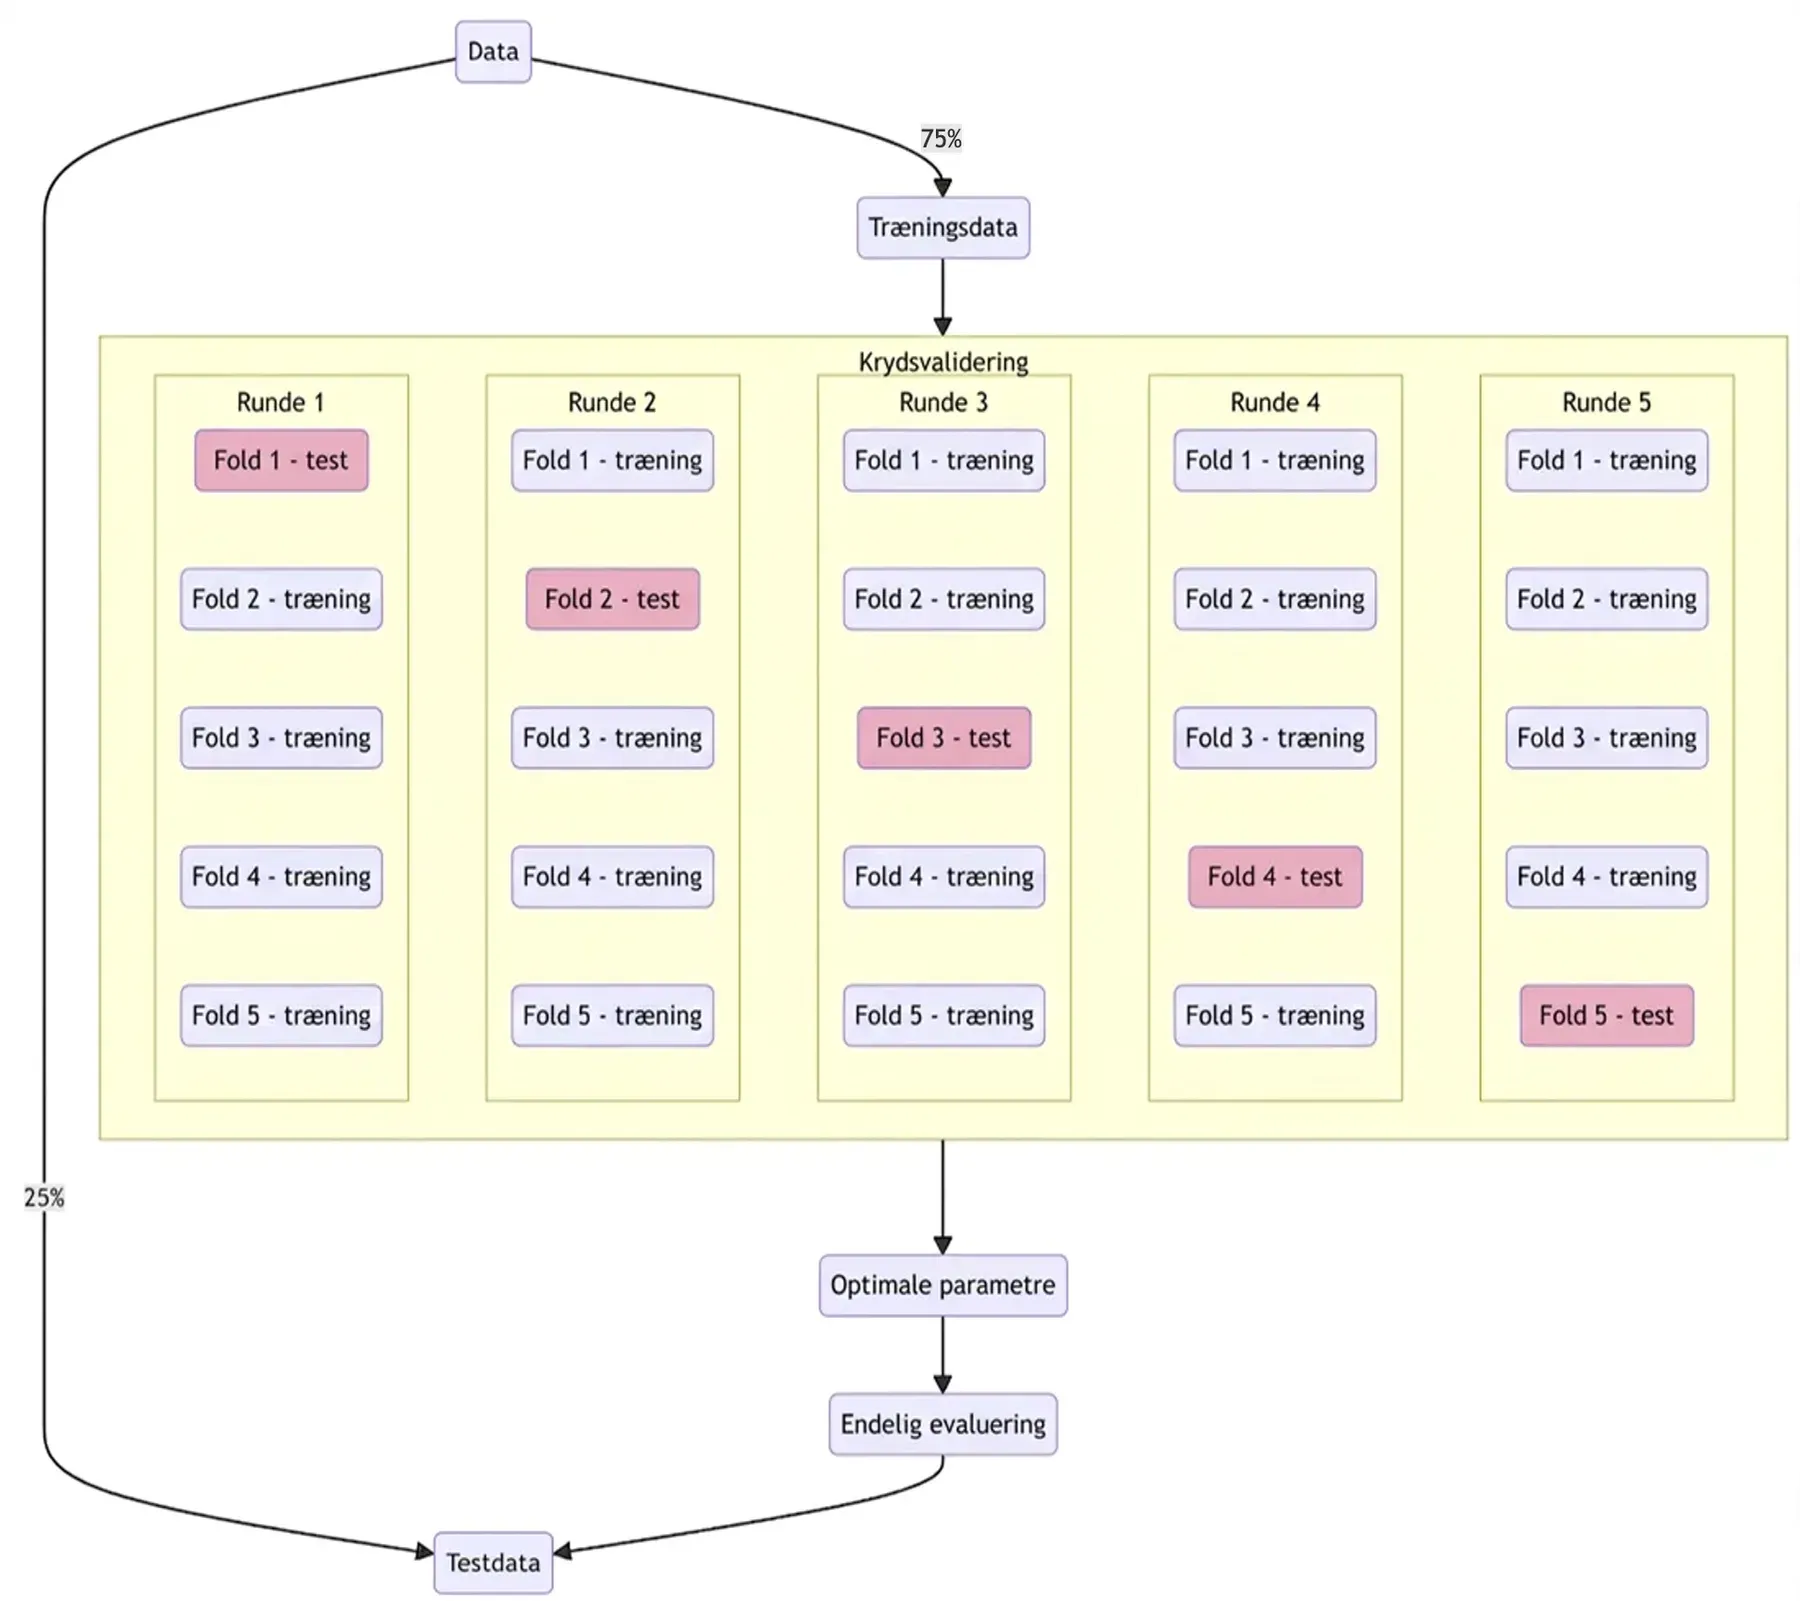
Den mest anvendte metode til at evaluere modeller i træningsdata er krydsvalidering (cross validation). Nedenstående flowdiagram viser, hvordan krydsvalidering fungerer.
- Det oprindelige datasæt opdeles tilfældigt i træningsdata og testdata. Fordelingen kan for eksempel være henholdsvis 75% og 25%.
- Folds (folder): Træningsdata opdeles derefter tilfældigt i lige store folder (dele). I nedenstående eksempel skabes 5 folder. Modellen trænes på 4 af disse og testes på den sidste fold (som modellen ikke er trænet på).
- Repeats (runder): Fremgangsmåden i trin 2 gentages, men nu udtrækkes 5 nye folder tilfældigt. Ligesom i trin 2 sker træningen i 4 af disse, og testen udføres på den sidste fold.
Nedenstående figur viser krydsvalidering med 5 folder gentaget 5 gange. I praksis kan det betale sig at lave 10 gentagelser (runder). Formålet med krydsvalideringen er allerede i træningsdata at identificere den bedste model ved (i hver runde) ikke at bruge alle træningsdata til træning. Dermed kan vi evaluere forskellige typer af modeller og for hver model desuden evaluere forskellige specifikationer. Hvis modellen er logistisk regression, kan vi evaluere regressioner med og uden interaktioner, splinefunktioner eller andre transformationer af prædiktorer. Det samme gælder for machine learning. Det betyder, at vi i dette trin kan identificere de optimale parametre.
Den bedste model kan derefter bruges på alle træningsdata for at estimere parametrene igen samt på testdata for at evaluere modellens præcision på nye og fremtidige data.
Mål for modellens prædiktive evne (Evaluation metrics)
For at sammenligne modeller med krydsvalidering (eller andre metoder) skal der bruges et mål for præcision. Der findes en række forskellige mål, og hvilket der er optimalt for en given problemstilling, varierer. Der findes dog tommelfingerregler, som er passende i de fleste sammenhænge. Disse diskuteres i næste kapitel.