
Automated machine learning (Auto ML) indebærer, at computeren opbygger et stort antal forskellige modeller og evaluerer dem for dig. Auto ML kan udføres i Tidymodels med tilføjelsespakkerne agua og h2o. Auto ML er sandsynligvis fremtiden inden for prædiktionsmodellering. Efterhånden som processorer (computerkraft) bliver stærkere, vil auto ML blive mere anvendeligt, eftersom metoden kræver, at et stort antal modeller afprøves, hvilket er tids- og beregningskrævende. Hvis der er omfattende computerkraft til rådighed, og de rette performance metrics er valgt, er auto ML en meget potent metode.
Vi begynder dette eksempel med at installere mlbench for at få adgang til data om 768 individer, som tilhører Pima-indianerne. Vi kopierer data til objektet pima og omkoder derefter kolonnen diabetes til Yes og No i stedet for henholdsvis pos og neg.
## Installer og aktivér mlbench for at
install.packages("mlbench")
library(mlbench)

## Aktivér data
data(PimaIndiansDiabetes)

## Kopiér data til objektet pima
pima <- PimaIndiansDiabetes

## Omkod variablen diabetes til Yes og No i stedet for pos og neg
pima$diabetes = recode_factor(pima$diabetes,
                              'pos'='Yes',
                              'neg'='No')

head(pima)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
1 6 148 72 35 0 33.6 0.627 50 Yes
2 1 85 66 29 0 26.6 0.351 31 No
3 8 183 64 0 0 23.3 0.672 32 Yes
4 1 89 66 23 94 28.1 0.167 21 No
5 0 137 40 35 168 43.1 2.288 33 Yes
6 5 116 74 0 0 25.6 0.201 30 NoVi bruger derefter funktionen initial_split() til at oprette træningsdata og testdata. Vi angiver prop=0.7, for at 70 % af data skal bruges til træning. Med funktionerne training() og testing() udtrækker vi derefter træningsdata og testdata til separate filer. Bemærk argumentet strata=diabetes, som indebærer, at vores split stratificeres på kolonnen diabetes, hvilket fører til, at andelen med Yes og No bliver lige stor i træningsdata og testdata. Dette er ønskværdigt, for at andelen, der rammes af diabetes, skal være lige stor i træningsdata og testdata.
pima_split <- initial_split(pima, strata=diabetes, prop=0.7)
pima_train <- training(pima_split)
pima_test <- testing(pima_split)
I næste trin installerer vi pakkerne agua og h2o. Pakken agua kommunikerer mellem Tidymodels og h2o. Beregningerne udføres i h2o, som skal startes ved hjælp af funktionen h2o_start():
## Installer pakkerne
install.packages("agua")
install.packages("h2o")

## Aktivér pakkerne
library(agua)
library(h2o)

## Start en h2o-server
h2o_start()
Herefter specificerer vi en model med funktionen auto_ml() med metoden h2o. Vi angiver også max_runtime_secs=300, hvilket betyder, at vi er villige til at vente 200 sekunder på at bygge og sammenligne modeller (denne parameter kan øges til et eller flere døgn i virkelige situationer).
For at bruge h2o skal en h2o-instans startes, hvilket gøres med funktionen h2o_start(). Dette starter en h2o-instans på computeren og skal gøres, hver gang R startes. h2o vil bruge alle kerner på din computer (h2o paralleliserer alle beregninger automatisk). Hvis du vil begrænse antallet af kerner, gøres det med argumentet nthreads. h2o-serveren lukkes, når R afsluttes. Hvis du vil lukke h2o manuelt, gøres det med funktionen h2o_end().
## Specificér model og hvor længe du er villig til at vente
h2o_mod <-
  auto_ml() |>
  set_engine("h2o",
             max_runtime_secs=200,
             exclude_algos = c("StackedEnsemble")) |>
  set_mode("classification") |>
  fit(diabetes ~ ., data = pima_train)
H2o kræver, at kategoriske variabler (character, factor) konverteres til numeriske variabler. Dette gøres automatisk af parsnip, hvis vi bruger fit() til at oprette modellen (se ovenfor). Bemærk også, at vi har angivet, at modeller af typen StackedEnsemble ikke skal oprettes.
Andre vigtige argumenter i set_engine() er følgende:
max_modelsangiver det maksimale antal modeller, der afprøves.exclude_algosoginclude_algosangiver, hvilke typer modeller der skal inkluderes eller ekskluderes. Følgende modeller er tilgængelige:DRF(including both the Random Forest and Extremely Randomized Trees (XRT) models)GLMXGBoost(XGBoost GBM)GBM(H2O GBM)DeepLearning(Fully-connected multi-layer artificial neural network)StackedEnsembleSom er en fusion af ovenstående ensemble-algoritmer.
validation: et heltal mellem 0 og 1, som angiver, hvor stor en andel af træningsdata der skal bruges som valideringsdata. Dette bruges af h2o til at evaluere modellernes præcision og afbryde konstruktionen af dårlige modeller.
Resultatet gemmes i objektet h2o_mod. På dette objekt kan en række funktioner anvendes. Disse funktioner eksemplificeres nu.
Funktionen rank_results() rangerer hver models performance (via krydsvalidering) for hver metric. Jo lavere tal i rangeringen, desto bedre model. Rangering 1 angiver den bedste model. Herunder udtrækkes alle modellers rangering baseret på AUC.
rank_results(h2o_mod) |>
  filter(.metric=="auc") |>
  arrange(rank)
## A tibble: 48 × 5
id algorithm .metric mean rank
<chr> <chr> <chr> <dbl> <int>
1 GBM_4_AutoML_1_20221226_215511 gradient boosting auc 0.831 1
2 GBM_grid_1_AutoML_1_20221226_215511_model_4 gradient boosting auc 0.827 2
3 GLM_1_AutoML_1_20221226_215511 glm auc 0.827 3
4 XGBoost_grid_1_AutoML_1_20221226_215511_model_9 xgboost auc 0.826 4
5 GBM_grid_1_AutoML_1_20221226_215511_model_3 gradient boosting auc 0.825 5
6 XGBoost_grid_1_AutoML_1_20221226_215511_model_5 xgboost auc 0.825 6
7 XGBoost_grid_1_AutoML_1_20221226_215511_model_2 xgboost auc 0.824 7
8 XGBoost_grid_1_AutoML_1_20221226_215511_model_4 xgboost auc 0.823 8
9 DeepLearning_grid_1_AutoML_1_20221226_215511_model_1 neural nets auc 0.823 9
10 GBM_5_AutoML_1_20221226_215511 gradient boosting auc 0.822 10
11 XGBoost_grid_1_AutoML_1_20221226_215511_model_3 xgboost auc 0.821 11
12 XGBoost_grid_1_AutoML_1_20221226_215511_model_1 xgboost auc 0.820 12
13 GBM_grid_1_AutoML_1_20221226_215511_model_13 gradient boosting auc 0.820 13
14 GBM_grid_1_AutoML_1_20221226_215511_model_6 gradient boosting auc 0.819 14
15 DeepLearning_grid_1_AutoML_1_20221226_215511_model_7 neural nets auc 0.819 15
16 DeepLearning_grid_1_AutoML_1_20221226_215511_model_10 neural nets auc 0.818 16
17 GBM_1_AutoML_1_20221226_215511 gradient boosting auc 0.818 17
18 XGBoost_grid_1_AutoML_1_20221226_215511_model_10 xgboost auc 0.817 18
19 DRF_1_AutoML_1_20221226_215511 random forests auc 0.817 19
20 XGBoost_grid_1_AutoML_1_20221226_215511_model_7 xgboost auc 0.815 20
21 GBM_grid_1_AutoML_1_20221226_215511_model_2 gradient boosting auc 0.815 21
22 XRT_1_AutoML_1_20221226_215511 random forests auc 0.815 22
23 GBM_grid_1_AutoML_1_20221226_215511_model_11 gradient boosting auc 0.815 23
24 GBM_grid_1_AutoML_1_20221226_215511_model_9 gradient boosting auc 0.813 24
25 XGBoost_grid_1_AutoML_1_20221226_215511_model_12 xgboost auc 0.813 25
26 XGBoost_grid_1_AutoML_1_20221226_215511_model_13 xgboost auc 0.812 26
27 XGBoost_2_AutoML_1_20221226_215511 xgboost auc 0.812 27
28 XGBoost_1_AutoML_1_20221226_215511 xgboost auc 0.811 28
29 DeepLearning_grid_1_AutoML_1_20221226_215511_model_2 neural nets auc 0.811 29
30 GBM_3_AutoML_1_20221226_215511 gradient boosting auc 0.811 30
31 GBM_grid_1_AutoML_1_20221226_215511_model_10 gradient boosting auc 0.810 31
32 XGBoost_grid_1_AutoML_1_20221226_215511_model_6 xgboost auc 0.809 32
33 GBM_grid_1_AutoML_1_20221226_215511_model_12 gradient boosting auc 0.809 33
34 DeepLearning_grid_1_AutoML_1_20221226_215511_model_5 neural nets auc 0.808 34
35 GBM_grid_1_AutoML_1_20221226_215511_model_5 gradient boosting auc 0.806 35
36 XGBoost_grid_1_AutoML_1_20221226_215511_model_11 xgboost auc 0.806 36
37 GBM_2_AutoML_1_20221226_215511 gradient boosting auc 0.806 37
38 XGBoost_grid_1_AutoML_1_20221226_215511_model_8 xgboost auc 0.805 38
39 GBM_grid_1_AutoML_1_20221226_215511_model_1 gradient boosting auc 0.804 39
40 DeepLearning_grid_1_AutoML_1_20221226_215511_model_9 neural nets auc 0.802 40
41 GBM_grid_1_AutoML_1_20221226_215511_model_8 gradient boosting auc 0.797 41
42 XGBoost_3_AutoML_1_20221226_215511 xgboost auc 0.797 42
43 GBM_grid_1_AutoML_1_20221226_215511_model_7 gradient boosting auc 0.796 43
44 DeepLearning_grid_1_AutoML_1_20221226_215511_model_6 neural nets auc 0.792 44
45 DeepLearning_grid_1_AutoML_1_20221226_215511_model_4 neural nets auc 0.785 45
46 DeepLearning_1_AutoML_1_20221226_215511 neural nets auc 0.779 46
47 DeepLearning_grid_1_AutoML_1_20221226_215511_model_8 neural nets auc 0.777 47
48 DeepLearning_grid_1_AutoML_1_20221226_215511_model_3 neural nets auc 0.714 48Ifølge ovenstående er der oprettet 48 modeller på 300 sekunder. Den bedste model har en ROC AUC på 0,831 og hedder GBM_4_AutoML_1_20221226_215511.
Funktionen collect_metrics() beregner gennemsnitsværdien af hver performance metric for hver model.
collect_metrics(h2o_mod, summarize = T) id algorithm .metric mean std_err n
1 GBM_4_AutoML_1_20221226_215511 gradient boosting accuracy 0.775 0.0186 5
2 GBM_4_AutoML_1_20221226_215511 gradient boosting auc 0.831 0.0132 5
3 GBM_4_AutoML_1_20221226_215511 gradient boosting err 0.225 0.0186 5
4 GBM_4_AutoML_1_20221226_215511 gradient boosting err_count 24.2 1.96 5
5 GBM_4_AutoML_1_20221226_215511 gradient boosting f0point5 0.677 0.0266 5
6 GBM_4_AutoML_1_20221226_215511 gradient boosting f1 0.698 0.0151 5
7 GBM_4_AutoML_1_20221226_215511 gradient boosting f2 0.724 0.00764 5
8 GBM_4_AutoML_1_20221226_215511 gradient boosting lift_top_group 2.29 0.346 5
9 GBM_4_AutoML_1_20221226_215511 gradient boosting logloss 0.480 0.0178 5
10 GBM_4_AutoML_1_20221226_215511 gradient boosting max_per_class_error 0.279 0.0127 5
## … with 952 more rowsFunktionen tidy() beregner hver models gennemsnitlige performance. Dette objekt er nyttigt, hvis formålet er at prædiktere ved hjælp af hver model.
tidy(h2o_mod) id algorithm .metric .model
1 GBM_4_AutoML_1_20221226_215511 gradient boosting <tibble [6 × 2]> <fit[+]>
2 GBM_grid_1_AutoML_1_20221226_215511_model_3 gradient boosting <tibble [6 × 2]> <fit[+]>
3 GLM_1_AutoML_1_20221226_215511 glm <tibble [6 × 2]> <fit[+]>
4 GBM_grid_1_AutoML_1_20221226_215511_model_4 gradient boosting <tibble [6 × 2]> <fit[+]>
5 XGBoost_grid_1_AutoML_1_20221226_215511_model_9 xgboost <tibble [6 × 2]> <fit[+]>
6 GBM_grid_1_AutoML_1_20221226_215511_model_13 gradient boosting <tibble [6 × 2]> <fit[+]>
7 GBM_5_AutoML_1_20221226_215511 gradient boosting <tibble [6 × 2]> <fit[+]>
8 XGBoost_grid_1_AutoML_1_20221226_215511_model_2 xgboost <tibble [6 × 2]> <fit[+]>
9 DeepLearning_grid_1_AutoML_1_20221226_215511_model_1 neural nets <tibble [6 × 2]> <fit[+]>
10 XGBoost_grid_1_AutoML_1_20221226_215511_model_5 xgboost <tibble [6 × 2]> <fit[+]>
## … with 38 more rowsFor at prædiktere med hver eneste model på de første 10 personer i pima_test bruges nedenstående kode. Bemærk, at funktionen slice(pima_test, 1:10) udtager de første 10 individer.
tidy(h2o_mod) %>%
  mutate(.predictions = map(.model, predict, new_data = slice(pima_test, 1:10)))
Funktionen extract_fit_engine() udtrækker en enkelt model fra objektet. Hvis argumentet id ikke angives, udtrækkes den bedste model ("leader model"). Modellernes id er angivet i resultaterne i kolonnen id (se for eksempel udskriften fra rank_results()).
extract_fit_engine(h2o_mod)Model Details:
==============
H2OBinomialModel: gbm
Model ID: GBM_4_AutoML_1_20221226_215511
Model Summary:
number_of_trees number_of_internal_trees model_size_in_bytes min_depth max_depth mean_depth min_leaves max_leaves
1 29 29 13560 8 10 9.31034 27 35
mean_leaves
1 32.37931
H2OBinomialMetrics: gbm
** Reported on training data. **
MSE: 0.05725762
RMSE: 0.2392857
LogLoss: 0.2300623
Mean Per-Class Error: 0.0376547
AUC: 0.9922995
AUCPR: 0.9856815
Gini: 0.9845989
R^2: 0.7477261
Confusion Matrix (vertical: actual; across: predicted) for F1-optimal threshold:
No Yes Error Rate
No 333 17 0.048571 =17/350
Yes 5 182 0.026738 =5/187
Totals 338 199 0.040968 =22/537
Maximum Metrics: Maximum metrics at their respective thresholds
metric threshold value idx
1 max f1 0.392466 0.943005 180
2 max f2 0.377527 0.962145 183
3 max f0point5 0.555395 0.947368 151
4 max accuracy 0.439211 0.959032 175
5 max precision 0.948979 1.000000 0
6 max recall 0.259765 1.000000 220
7 max specificity 0.948979 1.000000 0
8 max absolute_mcc 0.392466 0.912150 180
9 max min_per_class_accuracy 0.439211 0.957219 175
10 max mean_per_class_accuracy 0.392466 0.962345 180
11 max tns 0.948979 350.000000 0
12 max fns 0.948979 186.000000 0
13 max fps 0.019980 350.000000 399
14 max tps 0.259765 187.000000 220
15 max tnr 0.948979 1.000000 0
16 max fnr 0.948979 0.994652 0
17 max fpr 0.019980 1.000000 399
18 max tpr 0.259765 1.000000 220
Gains/Lift Table: Extract with `h2o.gainsLift(<model>, <data>)` or `h2o.gainsLift(<model>, valid=<T/F>, xval=<T/F>)`
H2OBinomialMetrics: gbm
** Reported on cross-validation data. **
** 5-fold cross-validation on training data (Metrics computed for combined holdout predictions) **
MSE: 0.1568414
RMSE: 0.396032
LogLoss: 0.474387
Mean Per-Class Error: 0.2495187
AUC: 0.8318411
AUCPR: 0.7182069
Gini: 0.6636822
R^2: 0.3089657
Confusion Matrix (vertical: actual; across: predicted) for F1-optimal threshold:
No Yes Error Rate
No 224 126 0.360000 =126/350
Yes 26 161 0.139037 =26/187
Totals 250 287 0.283054 =152/537
Maximum Metrics: Maximum metrics at their respective thresholds
metric threshold value idx
1 max f1 0.243135 0.679325 240
2 max f2 0.096600 0.802792 323
3 max f0point5 0.568206 0.705968 105
4 max accuracy 0.568206 0.780261 105
5 max precision 0.956189 1.000000 0
6 max recall 0.028299 1.000000 389
7 max specificity 0.956189 1.000000 0
8 max absolute_mcc 0.491770 0.501248 130
9 max min_per_class_accuracy 0.352644 0.727273 189
10 max mean_per_class_accuracy 0.243135 0.750481 240
11 max tns 0.956189 350.000000 0
12 max fns 0.956189 186.000000 0
13 max fps 0.016039 350.000000 399
14 max tps 0.028299 187.000000 389
15 max tnr 0.956189 1.000000 0
16 max fnr 0.956189 0.994652 0
17 max fpr 0.016039 1.000000 399
18 max tpr 0.028299 1.000000 389
Gains/Lift Table: Extract with `h2o.gainsLift(<model>, <data>)` or `h2o.gainsLift(<model>, valid=<T/F>, xval=<T/F>)`
Cross-Validation Metrics Summary:
mean sd cv_1_valid cv_2_valid cv_3_valid cv_4_valid cv_5_valid
accuracy 0.774559 0.041612 0.796296 0.814815 0.794392 0.757009 0.710280
auc 0.831481 0.029510 0.852256 0.852256 0.847876 0.820849 0.784170
err 0.225441 0.041612 0.203704 0.185185 0.205607 0.242991 0.289720
err_count 24.200000 4.381781 22.000000 20.000000 22.000000 26.000000 31.000000
f0point5 0.676793 0.059588 0.710526 0.741758 0.696517 0.644444 0.590717
f1 0.698472 0.033793 0.710526 0.729730 0.717949 0.690476 0.643678
f2 0.724003 0.017082 0.710526 0.718085 0.740741 0.743590 0.707071
lift_top_group 2.293599 0.774065 2.842105 2.842105 1.445946 2.891892 1.445946
logloss 0.479799 0.039779 0.439568 0.452327 0.474039 0.491787 0.541276
max_per_class_error 0.278724 0.028374 0.289474 0.289474 0.243243 0.257143 0.314286
mcc 0.525621 0.065505 0.553383 0.589539 0.558669 0.504708 0.421806
mean_per_class_accuracy 0.767549 0.027921 0.776692 0.790977 0.785521 0.763320 0.721236
mean_per_class_error 0.232451 0.027921 0.223308 0.209023 0.214479 0.236680 0.278765
mse 0.157833 0.015036 0.144910 0.144622 0.153228 0.167321 0.179083
pr_auc 0.713002 0.081285 0.787191 0.812500 0.665643 0.669870 0.629805
precision 0.664095 0.075733 0.710526 0.750000 0.682927 0.617021 0.560000
r2 0.304361 0.068720 0.364576 0.365836 0.322660 0.260363 0.208372
recall 0.743670 0.032205 0.710526 0.710526 0.756757 0.783784 0.756757
rmse 0.396927 0.018757 0.380670 0.380292 0.391444 0.409049 0.423182
specificity 0.791429 0.075997 0.842857 0.871429 0.814286 0.742857 0.685714I ovenstående eksempel blev der ikke oprettet modeller af typen StackedEnsemble. Hvis det gøres, kan funktionen member_weights() bruges til at klarlægge, hvilken model der er vigtigst i ensemblet. Dette illustreres ikke her.
Vi fortsætter med at prædiktere med vores bedste model. Dette gøres som sædvanligt med funktionen predict(). Parsnip vil automatisk bruge den bedste model til at foretage prædiktionen. Resultatet af prædiktionen sender vi til pima_test, hvor vi opretter kolonnen predicted. Som sædvanligt vil denne bestå af to nestede (sammenføjede) kolonner, hvilket vi afhjælper ved hjælp af funktionen unnest().
pima_test$predicted <- predict(h2o_mod, new_data = pima_test, type="prob")

## Vi unnester kolonnen predicted til to separate kolonner
pima_test <- unnest(pima_test, predicted)

head(pima_test)
pregnant glucose pressure triceps insulin mass pedigree age diabetes .pred_No .pred_Yes
1 3 78 50 32 88 31 0.248 26 Yes 0.937 0.0632
2 10 115 0 0 0 35.3 0.134 29 No 0.306 0.694
3 10 168 74 0 0 38 0.537 34 Yes 0.0737 0.926
4 10 139 80 0 0 27.1 1.44 57 No 0.839 0.161
5 5 166 72 19 175 25.8 0.587 51 Yes 0.401 0.599
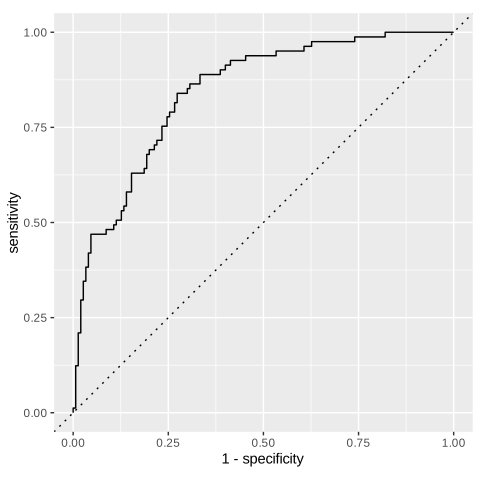
6 0 118 84 47 230 45.8 0.551 31 Yes 0.517 0.483## ROC AUC
resultat %>%
roc_auc(diabetes, .pred_Yes)
## ROC-kurven
resultat |>
roc_curve(diabetes, .pred_Yes) |>
ggplot(aes(x = 1 - specificity, y = sensitivity)) +
geom_path() +
geom_abline(lty = 3) +
coord_equal()AUC: 0,834
Auto ML med en opskrift
Vi gentager nu modelleringen med en opskrift. En opskrift gør det muligt at indføre pre-processing ved hjælp af step-funktioner. Der findes en lang række step-funktioner (se dokumentation her), som letter pre-processing. Eksempler på step-funktioner er følgende:
[step_impute_bag()](https://recipes.tidymodels.org/reference/step_impute_bag.html)imputerer manglende data med bagged trees.- step_BoxCox() transformerer data med Box-Cox-transformation.
- step_mutate() opretter nye variabler med dplyr-syntaks.
- step_dummy() omdanner kategoriske variabler til dummy-variabler.
[step_center()](https://recipes.tidymodels.org/reference/step_center.html)centrerer numeriske variabler.[step_normalize()](https://recipes.tidymodels.org/reference/step_normalize.html)centrerer og skalerer numeriske variabler.[step_nzv()](https://recipes.tidymodels.org/reference/step_nzv.html)fjerner variabler med near zero variance.[step_rm()](https://recipes.tidymodels.org/reference/step_rm.html)fjerner udvalgte variabler.[step_select()](https://recipes.tidymodels.org/reference/step_select.html)udvælger variabler med dplyr-syntaks.[step_zv()](https://recipes.tidymodels.org/reference/step_zv.html)fjerner variabler med zero variance.
Der findes mange flere step-funktioner.
Først starter vi h2o, og derefter opretter vi træningsdata og testdata:
## Aktiverer h2o
h2o_start()

## Opdeler data i træningsdata og testdata
## Vi angiver et seed for at få de samme test- og træningsdata hver gang vi gør dette
set.seed(1)
pima_split <- initial_split(pima, strata=diabetes, prop=0.7)
pima_train <- training(pima_split)
pima_test <- testing(pima_split)
I næste trin specificerer vi, at en klassifikationsmodel skal oprettes med h2o. Den samlede tid til at bygge modeller må højst være 600 sekunder. Argumentet seed = 1 gør, at vi kan opnå det samme resultat, hver gang modellerne oprettes (dette er ønskværdigt, hvis resultaterne skal kunne reproduceres nøjagtigt).
## run for a maximum of 120 seconds
my_auto_ml_model <-
  auto_ml() %>%
  set_engine("h2o", max_runtime_secs = 60*10, seed = 1) %>%
  set_mode("classification")
Derefter opretter vi en opskrift, hvor vi angiver formlen og mindst én step-funktion.
## Vi opretter nu en opskrift, hvor kontinuerte variabler normaliseres
my_recipe <-
  recipe(diabetes ~ ., data = pima_train) %>%
  step_normalize(all_predictors())
I næste trin opretter vi et workflow (arbejdsgang). Dette er nødvendigt, fordi vi har en opskrift. For at kombinere en opskrift med en model kræves et workflow, som følger:
## Da vi har oprettet en opskrift, kræves et workflow (arbejdsgang)
my_workflow <-
  workflow() %>%
  add_model(my_auto_ml_model) %>%
  add_recipe(my_recipe)
I sidste trin oprettes modellerne med følgende kommando:
## Når vi bruger fit(), køres modellerne
my_fit <- fit(my_workflow,
              data = pima_train)
Resultatet fås med følgende kommando:
extract_fit_parsnip(my_fit)parsnip model object
═════════════════════════════════ H2O AutoML Summary: 77 models ═════════════════════════════════
Leader Algorithm: stackedensemble
Leader ID: StackedEnsemble_BestOfFamily_6_AutoML_2_20221226_230058
═════════════════════════════════ Leaderboard ═════════════════════════════════
model_id auc logloss aucpr mean_per_class_error
1 StackedEnsemble_BestOfFamily_6_AutoML_2_20221226_230058 0.8504125 0.4579039 0.7076490 0.2135829
2 StackedEnsemble_BestOfFamily_7_AutoML_2_20221226_230058 0.8499847 0.4598350 0.7029424 0.2158900
3 StackedEnsemble_BestOfFamily_1_AutoML_2_20221226_230058 0.8496791 0.4587145 0.6915028 0.2157830
4 GBM_grid_1_AutoML_2_20221226_230058_model_4 0.8495875 0.4573177 0.7095222 0.2173950
5 StackedEnsemble_BestOfFamily_4_AutoML_2_20221226_230058 0.8492284 0.4587871 0.7102592 0.2176471
6 StackedEnsemble_AllModels_1_AutoML_2_20221226_230058 0.8488694 0.4601824 0.6896033 0.2151948I alt blev der oprettet 77 modeller, hvoraf den bedste har id StackedEnsemble_BestOfFamily_6_AutoML_2_20221226_230058, med en AUC på 0,850 (ikke testet på testdata).
Auto ML bruges i dag til at få et fingerpeg om, hvilke modeller der er gode til en given opgave. Auto ML er ingen garanti for, at den bedste model opnås. Med omhyggelig manuel hyperparameter tuning (optimering af hyperparametre) kan man oftest skabe modeller, der er bedre end dem, der er skabt med auto ML.