I dette kapitel bruges tidymodels til at oprette og sammenligne forskellige modeller i et arbejdsforløb (workflow). Ligesom i det foregående kapitel vil vi optimere modellerne med krydsvalidering. Følgende vil blive gjort:
- Alle modeller evalueres ved resampling (krydsvalidering).
- To forskellige opskrifter (recipes) evalueres.
- Tre forskellige modeller evalueres.
- To af modellerne gennemgår optimering af hyperparametre. For den ene model sker det ved manuel definition af et grid (kombination af hyperparametre). For den anden model sker det ved at lade R oprette et grid.
Vi begynder med at indlæse de nødvendige pakker og indlæse data fra et studie af patienter med tyktarmskræft (coloncancer).
library(tidyverse) # til håndtering af data
library(tidymodels) # grundpakken til prædiktionsmodellering
library(dials) # til at optimere hyperparametre
library(finetune) # yderligere funktioner til at optimere hyperparametre
Data til denne øvelse kommer fra pakken survival, hvor der er data om personer med coloncancer til rådighed. Vi indlæser survival og indlæser alle datasæt med kræftstudier. Derefter inspicerer vi colon, som er de data, vi skal arbejde med.
library(survival)
data(cancer) # indlæs alle datasæt med kræftstudier
head(colon, 10) # inspicer de første 10 rækker i studiet om coloncancer
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1
7 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 293 2
8 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 245 1
9 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 659 2
10 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 523 1I colon findes kolonnen status, som er studiets udfaldsmål. Værdien 1 angiver, at patienten er død, og værdien 0 angiver, at patienten har overlevet. Ligesom i det foregående kapitel vil vi modificere colon-data med følgende trin:
- Vi omkoder
status1tilYesog0tilNoog gør variablen til en faktor med funktionenrecode_factor(). - Vi omkoder
sex, så der står Kvinna og Man i stedet for henholdsvis 0 og 1. - Vi fjerner kolonnerne
time,idogstudy, da vi ikke skal bruge dem i vores model. - Variabler med
0/1omkodes tilNo/Yespå en snedig måde medmutate(across()). Bemærk, at vi medacross()kan vælge flere kolonner, som vi vil anvende funktionenrecode_factor()på, og derefter repræsenteres kolonnen af.xi funktionen. Se linje 5 nedenfor.
colon2 <- colon |>
  mutate(status = recode_factor(status, "1"="Yes", "0"="No"),
         sex = recode_factor(sex, "0"="Kvinna", "1"="Man")) |>
  select(-time, -id, -study) |>
  mutate(across(c(obstruct, adhere, perfor, surg, node4), ~recode_factor(.x, "0"="No", "1"="Yes")))

## Inspicer data
head(colon2, 10)
rx sex age obstruct perfor adhere nodes status differ extent surg node4 etype
1 Lev+5FU Man 43 No No No 5 Yes 2 3 No Yes 2
2 Lev+5FU Man 43 No No No 5 Yes 2 3 No Yes 1
3 Lev+5FU Man 63 No No No 1 No 2 3 No No 2
4 Lev+5FU Man 63 No No No 1 No 2 3 No No 1
5 Obs Kvinna 71 No No Yes 7 Yes 2 2 No Yes 2
6 Obs Kvinna 71 No No Yes 7 Yes 2 2 No Yes 1
7 Lev+5FU Kvinna 66 Yes No No 6 Yes 2 3 Yes Yes 2
8 Lev+5FU Kvinna 66 Yes No No 6 Yes 2 3 Yes Yes 1
9 Obs Man 69 No No No 22 Yes 2 3 Yes Yes 2
10 Obs Man 69 No No No 22 Yes 2 3 Yes Yes 1Kortlæg og imputer manglende data
Vi fortsætter med at undersøge forekomsten af manglende data (missing data) i colon2. Det gør vi med funktionen vis_miss() fra pakken visdat på følgende måde:
library(visdat)
vis_miss(colon2)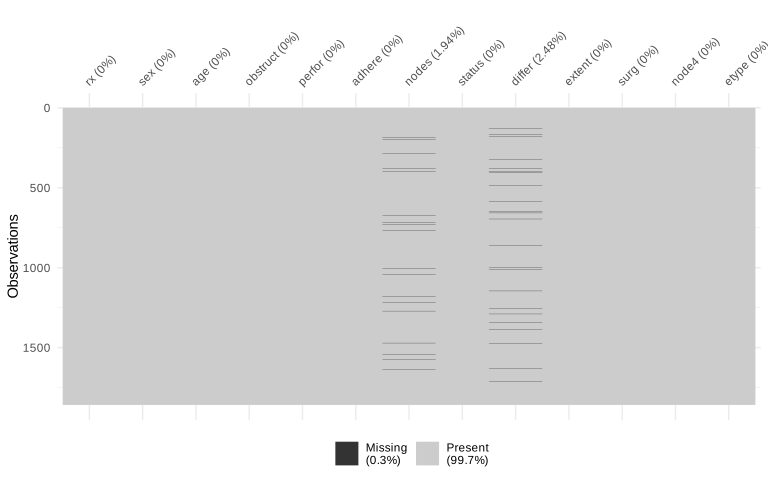
Som det fremgår af resultatet ovenfor, får vi en figur, hvor kolonnerne og rækkerne i colon2 visualiseres i et rektangel. Det fremgår, at der i alt mangler 0,3 % af alle værdier i colon2. Selvom dette er et usædvanligt lavt tal, vælger vi alligevel at imputere disse værdier med funktionen missRanger(), som findes i pakken af samme navn. Resultatet sender vi til colon3, som nu er en dataframe uden manglende data (alle manglende værdier er blevet imputeret).
library(missRanger)
colon3 <- missRanger(data=colon2, maxiter=10, pmm.k = 5)

vis_miss(colon3)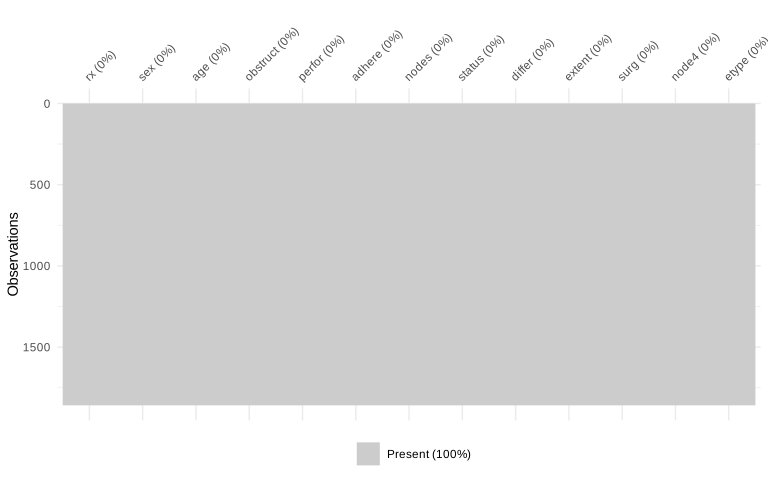
Opret træningsdata, testdata og resampling (krydsvalidering)
Vi deler nu colon3 i træningsdata (70 % af data) og testdata (30 %). Da studiet sigter mod at undersøge hændelsen død, vælger vi at stratificere opdelingen efter udfaldet (strata=status), så andelen, der dør, er lige stor i træningsdata og testdata.
## Opretter træningsdata og testdata med set.seed() først
set.seed(1)

colon_split <- initial_split(colon3, strata=status, prop=0.7)
colon_train <- training(colon_split)
colon_test  <- testing(colon_split)

## Opretter krydsvalidering af træningsdata
my_cross_validation <- vfold_cv(colon_train,
                                v = 5,
                                repeats=10,
                                strata = status)
Bemærk, at vi har angivet set.seed(1), hvilket eliminerer tilfældighedens effekt, når vi genererer test- og træningsdata. Det betyder, at vi kan generere præcis de samme observationer i træningsdata og testdata, hver gang vi bruger initial_split(). Dette kan være ønskværdigt for at få resultater, der kan reproduceres nøjagtigt.
Opret opskrifter
Vi opretter to opskrifter. Den første opskrift kalder vi base_recept. Se kommentarerne i koden nedenfor for at se, hvilke pre-processing-trin der udføres. Den anden opskrift hedder extended_recipe og bygger på base_recept, men har tilføjelsen step_pca(). Hvis du ikke er bekendt med metoden PCA, kan du indtil videre blot konstatere, at PCA er en metode, der reducerer antallet af numeriske prædiktorer, hvilket undertiden fører til bedre modeller.
## Grundlæggende opskrift
base_recipe <- recipe(status ~ ., data=colon_train) |>
  # Normalisering af numeriske prædiktorer
  step_normalize(all_numeric()) |>
  # Opretter dummy-variabler af kategoriske variabler
  step_dummy(all_nominal_predictors()) |>
  # Skaber tolerance for nye variabelniveauer i testdata
  step_novel(all_nominal_predictors())

## Udvidet opskrift baseret på base_recipe
extended_recipe <-
  base_recipe |>
  step_pca(all_numeric_predictors())
Opret modeller
Vi opretter tre modeller med følgende indstillinger:
Logistisk regression.
- Hyperparametre: ingen.
- Metode: GLM (almindelig logistisk regression)
Random forest.
Hyperparametre: 2 stk. Vi opretter vores grid manuelt med funktionen
crossing().Metode: Ranger-pakken.
Xtreme gradient boosting.
- Hyperparametre: 8 stk. Vi opretter vores grid med funktionen
grid_latin_hypercube()., som ud fra antallet af tilladte kombinationer (size=n) maksimerer, hvilke kombinationer der undersøges. - Metode: Ranger-pakken.
- Hyperparametre: 8 stk. Vi opretter vores grid med funktionen
## 1. LOGISTISK REGRESSION =====================================
glm_spec <-
  logistic_reg() %>%
  set_engine('glm') %>%
  set_mode('classification')

## 2. RANDOM FOREST ============================================
rf_spec <- rand_forest(mtry = tune(),
                       trees = tune()) |>
  set_engine("ranger") |>
  set_mode("classification")

## Med funktionen crossing() oprettes et grid manuelt.
## Angiv manuelt, hvilke værdier der skal testes for hver parameter
rf_grid <- crossing(mtry = c(3, 6, 9),
                    trees=c(100, 200))

## 3. XTREME GRADIENT BOOSTING ================================
## Definer modellen
xgb_spec <-
  boost_tree(tree_depth = tune(),
             mtry = tune(),
             trees = tune(),
             learn_rate = tune(),
             min_n = tune(),
             loss_reduction = tune(),
             sample_size = tune(),
             stop_iter = tune()) %>%
  set_engine('xgboost') %>%
  set_mode('classification')

## Opret et grid med grid_latin_hypercube()
xgb_grid <- grid_latin_hypercube(
  trees(),
  min_n(),
  learn_rate(),
  loss_reduction(),
  tree_depth(),
  sample_prop(),
  stop_iter(),
  finalize(mtry(), colon_train),
  size = 10)
Opretter workflow
Vi opretter nu et sæt af workflows med funktionen workflow_set(). Her oprettes to lister. Den første liste er preproc, og her angives opskrifterne. Det næste argument er models, og her angives modellerne. Argumentet cross sættes til TRUE, da alle modeller skal testes med alle opskrifter.
Vi skal tilføje vores grids til vores workflow med funktionen option_add(). Her angives, hvilket grid der skal tilføjes til et specifikt workflow. Som det fremgår nedenfor, er navnet på hvert workflow dets pre-processor og model adskilt af en understregning (eksempelvis base_xgb).
my_wf <-
   workflow_set(
      preproc = list(base = base_recipe,
                     extended = extended_recipe),
      models = list(glm = glm_spec,
                    rf = rf_spec,
                    xgb = xgb_spec),
      cross = TRUE
   ) %>%
   # Tilføjer specifik grid search til specifikt arbejdsforløb
   option_add(id = "base_xgb",     grid = xgb_grid) %>%
   option_add(id = "extended_xgb", grid = xgb_grid) %>%
   option_add(id = "base_rf",      grid = rf_grid) %>%
   option_add(id = "extended_rf",  grid = rf_grid)
Kør modellerne
For at køre modellerne bruger vi parallelisering, hvilket betyder, at vi udnytter flere af computerens kerner, hvis det er muligt. Paralleliseringen kræver pakkerne doParallel og parallel. Pakken tictoc bruges til at måle den tid, det tager at køre alle modellerne.
Husk ikke at bruge alle kernerne i din computer. Lad altid 2 kerner være ledige til andre processer på computeren. I nedenstående tilfælde har computeren 8 kerner, og derfor bruges 6 kerner til beregningerne nedenfor. Antallet af kerner angives med funktionen makePSOCKcluster().
library(doParallel)
library(parallel)
library(tictoc)

## Start parallelisering
mitt_kluster <- makePSOCKcluster(6)
registerDoParallel(mitt_kluster)
tic()

## Kør modellerne
my_wf_results <-
   workflow_map(object=my_wf,
                "tune_grid",
                seed = 1,
                resamples = my_cross_validation,
                metrics = yardstick::metric_set(roc_auc),
                verbose = TRUE,
                control   = control_grid(save_pred = TRUE,
                           parallel_over = "everything",
                           save_workflow = TRUE)
                )

## Stop parallelisering
stopCluster(mitt_kluster)
toc()
i No tuning parameters. `fit_resamples()` will be attempted
i 1 of 6 resampling: base_glm
✔ 1 of 6 resampling: base_glm (24.4s)
i 2 of 6 tuning: base_rf
✔ 2 of 6 tuning: base_rf (2m 52.9s)
i 3 of 6 tuning: base_xgb
✔ 3 of 6 tuning: base_xgb (6m 40.6s)
i No tuning parameters. `fit_resamples()` will be attempted
i 4 of 6 resampling: extended_glm
✔ 4 of 6 resampling: extended_glm (11.6s)
i 5 of 6 tuning: extended_rf
✔ 5 of 6 tuning: extended_rf (3m 51.6s)
i 6 of 6 tuning: extended_xgb
✔ 6 of 6 tuning: extended_xgb (17m 25.1s)
1893.746 sec elapsedKørslen tog 1893 sekunder.
Sammenlign modellerne
Med funktionen autoplot() får vi et hurtigt overblik over modellernes evne til at prædiktere udfaldet, baseret på det præcisionsmål, vi har valgt (AUC ROC).
autoplot(my_wf_results)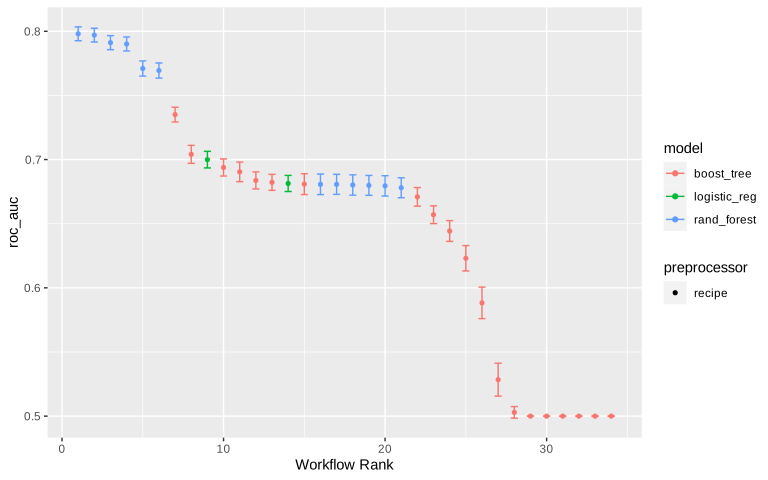
Vi kan udtrække de bedste modeller med følgende kode
rank_results(my_wf_results,
             rank_metric = "roc_auc",
             select_best = TRUE) %>%
   select(rank, mean, model, wflow_id, .config)
rank mean model wflow_id .config
<int> <dbl> <chr> <chr> <chr>
1 1 0.798 rand_forest base_rf Preprocessor1_Model6
2 2 0.735 boost_tree base_xgb Preprocessor1_Model01
3 3 0.700 logistic_reg base_glm Preprocessor1_Model1
4 4 0.694 boost_tree extended_xgb Preprocessor1_Model02
5 5 0.681 logistic_reg extended_glm Preprocessor1_Model1
6 6 0.681 rand_forest extended_rf Preprocessor1_Model1Den bedste model er random forest med grundopskriften (base_rf). Den bedste konfiguration hedder Preprocessor1_Model6.
For at se, hvilken konfiguration dette er, skriver vi:
best_model <- my_wf_results %>%
  extract_workflow_set_result("base_rf") %>%
  select_best(metric = "roc_auc")

best_model
mtry trees .config
9 200 Preprocessor1_Model6modellen har mtry = 9 og trees = 200.
Husk, at træningen blev udført med krydsvalidering, hvilket betyder, at modellen aldrig er blevet trænet på alle træningsdata (en fold er blevet brugt til at teste modellen, se Krydsvalidering). Den bedste model trænes derfor en sidste gang på alle træningsdata:
my_finalized_wf <-
  my_wf_results |>
  extract_workflow("base_rf") |>
  finalize_workflow(best_model) |>
  last_fit(split = colon_split,
           metrics = yardstick::metric_set(roc_auc))
Objektet my_finalized_wf indeholder den endelige model. Med funktionen collect_metrics() kan vi udtrække information om, hvor god modellen er på testdata. Bemærk, at vi ikke behøver at specificere testdata, da tidymodels bruger testdata automatisk (objektet my_finalized_wf har adgang til testdata, fordi vi specificerede split=colon_split ovenfor).
collect_metrics(my_finalized_wf) .metric .estimator .estimate .config
roc_auc binary 0.792 Preprocessor1_Model1ROC-kurven har et areal på 0,793.
Vi kan nu studere selve prædiktionerne ved at bruge funktionen collect_predictions():
pred_data <- collect_predictions(my_finalized_wf## A tibble: 558 × 6
id .pred_Yes .pred_No .row status .config
<chr> <dbl> <dbl> <int> <fct> <chr>
1 train/test split 0.873 0.127 2 Yes Preprocessor1_Model1
2 train/test split 0.0959 0.904 4 No Preprocessor1_Model1
3 train/test split 0.559 0.441 8 Yes Preprocessor1_Model1
4 train/test split 0.578 0.422 13 Yes Preprocessor1_Model1
5 train/test split 0.560 0.440 14 Yes Preprocessor1_Model1
6 train/test split 0.327 0.673 20 No Preprocessor1_Model1
7 train/test split 0.292 0.708 21 No Preprocessor1_Model1
8 train/test split 0.333 0.667 22 No Preprocessor1_Model1
9 train/test split 0.454 0.546 30 No Preprocessor1_Model1
10 train/test split 0.605 0.395 32 Yes Preprocessor1_Model1ROC-kurven oprettes med følgende kode:
pred_data %>%
  roc_curve(status, .pred_Yes) %>%
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal() +
  theme_bw()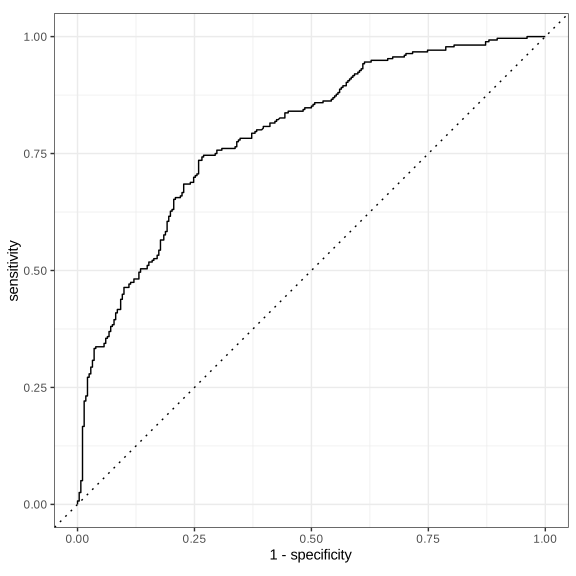
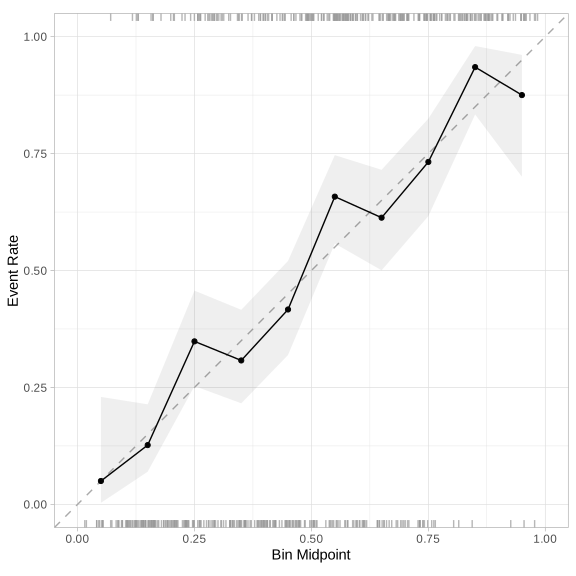
For at afklare, om modellen er velkalibreret, bruger vi funktionen cal_plot_breaks() fra pakken probably. Bemærk, at denne funktion kræver, at testversionen af probably er installeret. Den installeres med følgende kommando:
install.packages("remotes")
remotes::install_github("tidymodels/probably")
library(probably)

pred_data %>%
  cal_plot_breaks(status, .pred_Yes)