
I dette kapitel skal vi bruge tidymodels til at skabe et komplet arbejdsflow, der omfatter valg af prædiktionsmodel, optimering af hyperparametre med krydsvalidering samt udvælgelse og evaluering af den bedste model. Vi begynder med at aktivere tre pakker med følgende kommandoer:
## Aktivér tidymodels til prædiktionsmodellering
library(tidymodels)

## Aktivér tidyverse til håndtering af data
library(tidyverse)

## Aktivér vip for at udtrække variable importance
library(vip)
Data til denne øvelse kommer fra pakken survival, hvor der findes data om personer med coloncancer. Vi aktiverer survival og indlæser alle datasæt med cancerstudier. Derefter inspicerer vi colon, som er de data, vi skal arbejde med.
## Aktivér survival-pakken
library(survival)

## Aktivér alle datasæt med cancerstudier
data(cancer)

## Inspicér de første 10 rækker i studiet om coloncancer
head(colon, 10)
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1
7 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 293 2
8 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 245 1
9 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 659 2
10 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 523 1I colon findes kolonnen status, som er studiets udfaldsmål. Værdien 1 angiver, at patienten er død, og værdien 0 angiver, at patienten har overlevet. Vi vil modificere colon-data med følgende trin:
- Vi omkoder
status1tilYesog0tilNoog gør variablen til en faktor med funktionenrecode_factor(). - Vi omkoder
sex, så der står Kvinna og Man i stedet for henholdsvis 0 og 1. - Vi fjerner kolonnerne
time,idogstudy, da vi ikke skal bruge dem i vores model. - Variabler med
0/1omkodes tilNo/Yespå en snedig måde medmutate(across()). Bemærk, at vi medacross()kan vælge flere kolonner, som vi vil anvende funktionenrecode_factor()på, og derefter repræsenteres kolonnen af.xi funktionen. Se linje 5 nedenfor.
colon2 <- colon |>
  mutate(status = recode_factor(status, "1"="Yes", "0"="No"),
         sex = recode_factor(sex, "0"="Kvinna", "1"="Man")) |>
  select(-time, -id, -study) |>
  mutate(across(c(obstruct, adhere, perfor, surg, node4), ~recode_factor(.x, "0"="No", "1"="Yes")))

## Inspicér data
head(colon2, 10)
rx sex age obstruct perfor adhere nodes status differ extent surg node4 etype
1 Lev+5FU Man 43 No No No 5 Yes 2 3 No Yes 2
2 Lev+5FU Man 43 No No No 5 Yes 2 3 No Yes 1
3 Lev+5FU Man 63 No No No 1 No 2 3 No No 2
4 Lev+5FU Man 63 No No No 1 No 2 3 No No 1
5 Obs Kvinna 71 No No Yes 7 Yes 2 2 No Yes 2
6 Obs Kvinna 71 No No Yes 7 Yes 2 2 No Yes 1
7 Lev+5FU Kvinna 66 Yes No No 6 Yes 2 3 Yes Yes 2
8 Lev+5FU Kvinna 66 Yes No No 6 Yes 2 3 Yes Yes 1
9 Obs Man 69 No No No 22 Yes 2 3 Yes Yes 2
10 Obs Man 69 No No No 22 Yes 2 3 Yes Yes 1Bemærk, at vi herefter bruger colon2.
Opret træningsdata, testdata og resampling (krydsvalidering)
Vi deler nu colon2 i træningsdata (70% af data) og testdata (30%). Da studiet har til formål at undersøge hændelsen død, vælger vi at stratificere opdelingen, så andelen, der dør, er lige stor i træningsdata og testdata. Det er ønskværdigt, for at modellen kan testes og trænes under realistiske forhold. Hvis der er mange observationer, bliver andelen, der dør, med stor sandsynlighed lige stor i træningsdata og testdata (fordi træningsdata og testdata dannes helt tilfældigt). Denne funktion er derfor særligt nyttig, hvis antallet af observationer er lille, idet funktionen sikrer, at den tilfældige udvælgelse har lige store andele dødsfald i træningsdata og testdata.
## Opretter træningsdata og testdata med set.seed() først
set.seed(1)
colon_split <- initial_split(colon2, strata=status, prop=0.7)
colon_train <- training(colon_split)
colon_test  <- testing(colon_split)

## Opretter krydsvalidering af træningsdata
my_cross_validation <- vfold_cv(colon_train,
                                v = 5,
                                repeats=10,
                                strata = status)
Bemærk også, at vi har angivet set.seed(1), hvilket på dansk kaldes at så et frø. Når man sår et frø i denne sammenhæng, fjerner man tilfældigheden i den funktion, der køres efter set.seed(). I dette tilfælde betyder det blot, at vi kan få præcis de samme observationer i træningsdata og testdata, hver gang vi gentager opdelingen. Det er ønskværdigt for at opnå reproducerbare resultater. Du kan bruge et hvilket som helst tal i set.seed().
Resampling betyder, at den samme datamængde genbruges til at træne og evaluere en model. I dette tilfælde bruges en type resampling, der kaldes krydsvalidering (se Krydsvalidering). Krydsvalideringen foretages i træningsdata ved hjælp af funktionen vfold_cv(), som tilfældigt inddeler træningsdata i 5 lige store dele (folds), og hver model vil blive trænet i alle folds undtagen én, som bruges til at teste modellen. Dette gentages 10 gange (repeats=10) for hver model, hvilket medfører, at alle modeller trænes og evalueres i tilfældigt valgte dele af træningsdata. Den model, der klarer sig bedst under krydsvalideringen, er med største sandsynlighed også bedst på testdata (og dermed den bedste model).
Specificér en model og metode
I næste trin specificerer vi en model, nemlig extreme gradient boosting (XGBoost). Det gør vi ved at bruge funktionen boost_tree(), hvor samtlige hyperparametre sættes til tune(), hvilket betyder, at de skal optimeres via resampling. Vi specificerer metoden med set_engine() og typen af prædiktion med set_mode(). Derefter udskriver vi modelobjektet (xgb_spec).
xgb_spec <-
  boost_tree(mtry = tune(),
             tree_depth = tune(),
             trees = tune(),
             learn_rate = tune(),
             min_n = tune(),
             loss_reduction = tune(),
             sample_size = tune(),
             stop_iter = tune()) |>
  set_engine('xgboost') |>
  set_mode('classification')

xgb_spec
Boosted Tree Model Specification (classification)
Main Arguments:
trees = tune()
min_n = tune()
tree_depth = tune()
learn_rate = tune()
loss_reduction = tune()
sample_size = tune()
stop_iter = tune()
Computational engine: xgboostHyperparametrene i xgboost er som følger
- mtry: The number of predictors that will be randomly sampled at each split when creating the tree models.
- trees: The number of trees contained in the ensemble. Default: 15.
- min_n: The minimum number of data points in a node that are required for the node to be split further. Default: 1.
- tree_depth: The maximum depth of the tree (i.e. number of splits). Default: 6.
- learn_rate: The rate at which the boosting algorithm adapts from iteration-to-iteration. Default: 0.3.
- loss_reduction: The reduction in the loss function required to split further. Type: double, default: 0.0.
- sample_size: The amount of data exposed to the fitting routine. Type: double, default: 1.0.
- stop_iter: The number of iterations without improvement before stopping. Type: integer, default: Inf.
Grid search
I næste trin skal vi definere en matrix med kombinationer af hyperparametre. Disse matricer kaldes grid. Krydsvalideringens formål er at gennemsøge matricen efter den bedste model, hvilket kaldes grid search. Vi kan oprette et grid med flere forskellige funktioner, hvoraf én er grid_latin_hyperube(). Med denne funktion dannes kombinationer, der, baseret på det antal kombinationer vi tillader, dækker et så "stort område som muligt".
xgb_grid <- grid_latin_hypercube(
  trees(),
  min_n(),
  learn_rate(),
  loss_reduction(),
  tree_depth(),
  sample_prop(),
  stop_iter(),
  finalize(mtry(), colon_train),
  size = 20)
Vores grid har i alt 50 forskellige kombinationer af hyperparametre (size=50), hvilket betyder, at vi tester 50 forskellige modeller. Bemærk, at parameteren mtry (antal variabler) specificeres i funktionen finalize(), hvilket skyldes, at mtry ikke kan antage en hvilken som helst værdi (antallet af kolonner kan være for lille).
xgb_grid trees min_n learn_rate loss_reduction tree_depth sample_size stop_iter mtry
<int> <int> <dbl> <dbl> <int> <dbl> <int> <int>
1 55 24 4.15e- 2 2.28e- 2 6 0.358 14 10
2 413 32 1.35e- 5 5.05e- 6 14 0.887 17 7
3 1843 33 7.88e- 3 2.08e- 8 2 0.491 15 7
4 1214 27 9.13e- 8 1.57e- 3 4 0.227 10 5
5 1495 26 3.26e-10 5.35e- 7 4 0.596 15 6
6 476 20 5.08e-10 1.33e- 8 13 0.828 11 2
7 1117 8 5.41e- 3 2.92e- 7 8 0.731 17 12
8 351 4 3.27e- 4 2.31e- 9 10 0.864 12 12
9 310 35 9.31e- 9 1.98e+ 1 13 0.809 12 4
10 1450 40 1.34e- 6 2.03e-10 9 0.245 4 13
11 1269 35 1.13e- 8 4.29e- 1 4 0.615 4 7
12 990 22 8.24e- 2 2.13e- 5 11 0.532 8 2
13 128 23 5.87e-10 3.18e- 9 10 0.786 18 9
14 1347 13 5.02e- 9 8.81e- 2 12 0.722 7 9
15 94 38 6.35e- 7 9.03e- 5 7 0.168 5 4
16 1745 21 9.00e- 3 3.48e- 4 3 0.385 14 5
17 1791 6 1.93e- 4 1.23e- 6 10 0.413 3 12
18 1399 15 2.79e- 7 3.69e- 5 5 0.675 9 10
19 672 12 6.34e- 5 9.73e- 1 6 0.777 14 1
20 1531 12 2.25e-10 4.90e+ 0 3 0.266 15 11
21 893 19 1.54e- 6 1.15e+ 1 9 0.539 6 10
22 264 36 5.98e- 8 3.36e+ 0 14 0.208 10 8
23 233 38 1.25e- 9 2.41e- 3 9 0.998 6 3
24 1657 10 1.40e- 3 7.56e- 8 3 0.315 19 5
25 928 6 2.55e- 9 7.20e- 1 6 0.338 13 8
26 1418 33 2.85e- 4 1.40e- 7 1 0.970 11 6
27 1059 7 1.71e- 8 2.38e- 6 7 0.709 8 1
28 835 30 3.09e- 6 5.97e-10 8 0.131 3 8
29 162 9 2.75e- 8 1.66e-10 13 0.759 16 6
30 519 2 9.92e- 5 4.33e- 3 6 0.427 11 11
31 1153 23 3.08e- 5 1.07e- 4 13 0.922 7 2
32 1966 5 7.63e- 6 1.85e+ 0 2 0.398 8 10
33 1171 18 3.14e- 9 3.13e-10 12 0.652 9 1
34 1312 28 9.25e-10 2.25e- 4 12 0.576 13 3
35 590 20 5.51e- 5 1.34e- 9 15 0.189 18 6
36 699 25 3.85e- 8 1.04e- 2 8 0.289 13 11
37 389 14 5.52e- 2 7.44e- 6 7 0.474 16 11
38 1632 3 6.07e- 6 1.62e- 6 2 0.893 10 12
39 614 27 8.39e- 4 3.97e- 2 11 0.115 12 13
40 1011 16 4.35e- 7 1.07e+ 1 11 0.505 19 6
41 530 16 4.86e- 4 6.27e- 9 5 0.211 7 3
42 869 39 2.56e- 3 2.60e- 7 14 0.557 19 8
43 1821 16 2.37e- 7 2.43e- 1 9 0.678 20 4
44 799 29 4.12e- 6 1.63e- 2 5 0.935 6 3
45 1916 31 2.44e- 5 9.56e- 2 4 0.136 20 4
46 32 11 2.04e- 2 4.02e- 8 12 0.964 5 7
47 1713 8 1.74e- 7 6.99e- 9 15 0.838 9 3
48 1945 36 1.66e- 2 1.35e- 5 3 0.640 5 9
49 1567 18 1.50e-10 4.94e- 4 2 0.457 17 8
50 740 29 1.93e- 3 1.16e- 3 8 0.318 18 11Opret en opskrift (recipe)
I næste trin opretter vi en opskrift, hvor vi definerer, hvad der er studiets udfald, samt hvilke prædiktorer vi vil bruge. Vi definerer også, hvilke pre-processing-trin vi vil foretage. Se kommentarerne med forklaringer.
xgb_recipe <- recipe(status ~ ., data=colon_train) |>
  # step_normalize normaliserer alle kontinuerlige prædiktorer
  step_normalize(all_numeric()) |>
  # step_dummy opretter dummy-variabler af alle kategoriske variabler. Dette kræves af xgboost
  step_dummy(all_nominal_predictors()) |>
  # step_novel er en metode, der er nødvendig for at håndtere den situation, som kan opstå, hvis
  # testdata indeholder niveauer af kategoriske variabler, som ikke fandtes i træningsdata
  step_novel(all_nominal_predictors())
Opret et arbejdsflow
Derefter opretter vi et arbejdsflow med opskriften og modellen:
xgb_wf <- workflow() |>
  add_recipe(xgb_recipe) |>
  add_model(xgb_spec)

xgb_wf
══ Workflow ═══════════════════════════════════════════════════════════════════════════════════════════
Preprocessor: Recipe
Model: boost_tree()
── Preprocessor ───────────────────────────────────────────────────────────────────────────────────────
3 Recipe Steps
• step_normalize()
• step_dummy()
• step_novel()
── Model ──────────────────────────────────────────────────────────────────────────────────────────────
Boosted Tree Model Specification (classification)
Main Arguments:
mtry = tune()
trees = tune()
min_n = tune()
tree_depth = tune()
learn_rate = tune()
loss_reduction = tune()
sample_size = tune()
stop_iter = tune()
Computational engine: xgboostTræn modellerne
Derefter gennemføres træningen (dvs. modellerne oprettes). Bemærk argumentet metrics = yardstick::metric_set(roc_auc), som betyder, at vi fra pakken yardstick henter funktionen metric_set og sætter den til roc_auc (arealet under ROC-kurven). Det bliver således arealet under ROC-kurven, der bruges til at sammenligne modellerne.
xgb_res <- tune_grid(
  xgb_wf,
  resamples = my_cross_validation,
  grid      = xgb_grid,
  metrics   = yardstick::metric_set(roc_auc),
  control   = control_grid(save_pred = TRUE,
                           parallel_over = "everything",
                           save_workflow = TRUE))
Parallelisér træningen
Hvis du vil fremskynde ovenstående trin, kan du gøre det ved at parallelisere kørslen på flere af computerens kerner. Det gøres med pakkerne parallell og doParallell. For at måle den tid, det tager at foretage kørslen, bruger vi pakken tictoc. Koden til en paralleliseret beregning på 6 kerner er som følger:
## Aktivér pakkerne (glem ikke at installere pakkerne)
library(tictoc)
library(parallel)
library(doParallel)

## Opret en klynge i R med 6 kerner, så kørslen foretages på 6 kerner
mitt_kluster <- makePSOCKcluster(6)

## Aktivér din klynge
registerDoParallel(mitt_kluster)

## Start uret
tic()

## Foretag kørslen
xgb_res <- tune_grid(
  xgb_wf,
  resamples = my_cross_validation,
  grid      = xgb_grid,
  metrics   = yardstick::metric_set(roc_auc),
  control   = control_grid(save_pred = TRUE,
                           parallel_over = "everything",
                           save_workflow = TRUE))

## Stop klyngen
stopCluster(mitt_kluster)

## Stop uret
toc()
Evaluér modellerne
Resultaterne inspiceres derefter med funktionen collect_metrics(). Den opretter en tabel med information om hver models hyperparametre samt modellens resultat under krydsvalideringen. Kolonnen mean viser gennemsnitlig ROC AUC under krydsvalideringen. Vi sorterer alle modellerne efter faldende ROC AUC (den bedste model havner øverst):
collect_metrics(xgb_res) %>% arrange(desc(mean)) mtry trees min_n tree_depth learn_rate loss_reduct…¹ sampl…² stop_…³ .metric .esti…⁴ mean n std_err
1 12 985 8 6 0.0719 9.45e- 7 0.695 4 roc_auc binary 0.743 50 0.00337
2 6 1713 2 2 0.0432 2.83e-10 0.517 7 roc_auc binary 0.733 50 0.00323
3 2 794 5 3 0.0567 4.73e- 7 0.904 14 roc_auc binary 0.732 50 0.00334
4 6 716 5 9 0.000956 1.62e- 2 0.880 9 roc_auc binary 0.727 50 0.00399
5 9 159 6 5 0.00270 2.68e- 6 0.796 16 roc_auc binary 0.712 50 0.00411
6 4 1394 9 13 0.000000417 1.68e- 9 0.862 13 roc_auc binary 0.707 50 0.00425
7 1 447 4 15 0.0000679 2.17e+ 0 0.986 7 roc_auc binary 0.705 50 0.00383
8 6 857 12 7 0.00000888 1.19e-10 0.745 12 roc_auc binary 0.704 50 0.00430
9 9 1207 12 4 0.000126 3.87e- 2 0.946 6 roc_auc binary 0.698 50 0.00415
10 10 1280 14 12 0.00000152 1.17e- 8 0.666 6 roc_auc binary 0.695 50 0.00452
## … with 40 more rows, and abbreviated variable names ¹loss_reduction, ²sample_size, ³stop_iter, ⁴.estimator
## ℹ Use `print(n = ...)` to see more rowsFor at undersøge, hvordan forskellige hyperparametre påvirkede ROC-AUC, skriver vi følgende, temmelig indviklede, kode:
xgb_res_plot <-
  xgb_res |>
  collect_metrics() |>
  filter(.metric == "roc_auc") |>
  select(mean, mtry:sample_size) |>
  pivot_longer(mtry:sample_size,
               values_to = "value",
               names_to = "parameter") |>
  ggplot(aes(value, mean, color = parameter)) +
  geom_point(alpha = 0.8, show.legend = FALSE) +
  facet_wrap(~parameter, scales = "free_x") +
  labs(x = NULL, y = "AUC")

xgb_res_plot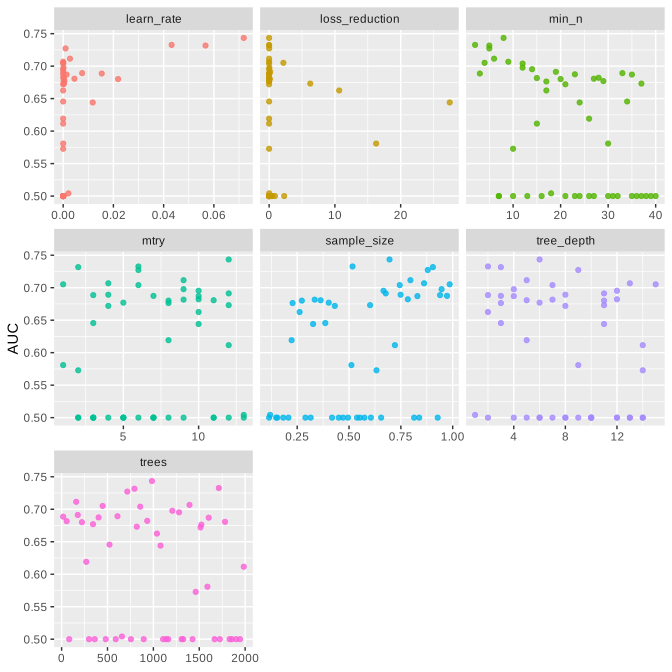
For at se de 5 bedste modeller i faldende rækkefølge skriver vi show_best():
show_best(xgb_res, "roc_auc") mtry trees min_n tree_depth learn_rate loss_reduction sample_size stop_…¹ .metric .esti…² mean n
1 12 985 8 6 0.0719 9.45e- 7 0.695 4 roc_auc binary 0.743 50
2 6 1713 2 2 0.0432 2.83e-10 0.517 7 roc_auc binary 0.733 50
3 2 794 5 3 0.0567 4.73e- 7 0.904 14 roc_auc binary 0.732 50
4 6 716 5 9 0.000956 1.62e- 2 0.880 9 roc_auc binary 0.727 50
5 9 159 6 5 0.00270 2.68e- 6 0.796 16 roc_auc binary 0.712 50
## … with abbreviated variable names ¹stop_iter, ².estimatorFor at udtrække den bedste model skriver vi select_best():
best_model <- select_best(xgb_res, "roc_auc")
best_model
mtry trees min_n tree_depth learn_rate loss_reduction sample_size stop_iter .config
1 12 985 8 6 0.0719 0.000000945 0.695 4 Preprocessor1_Model09Til sidst kører vi den bedste model igen på hele træningsdatasættet (uden krydsvalidering) og evaluerer modellen på testdata. Det kan gøres med funktionen last_fit(), hvor vi angiver colon_split, som indeholder både træningsdata og testdata.
final_model <-
  xgb_res %>%
  extract_workflow("xgb_wf") %>%
  finalize_workflow(best_model) %>%
  last_fit(split = colon_split,
           metrics = yardstick::metric_set(roc_auc))
Denne models evne til at prædiktere på testdata kan nu evalueres:
collect_metrics(final_model) .metric .estimator .estimate .config
roc_auc binary 0.707 Preprocessor1_Model1ROC AUC var 0,707 for den bedste model.
Vi kan udtrække prædiktionerne på testdata med følgende kode:
collect_predictions(final_model) id .pred_Yes .pred_No .row status .config
1 train/test split 0.720 0.280 2 Yes Preprocessor1_Model1
2 train/test split 0.120 0.880 4 No Preprocessor1_Model1
3 train/test split 0.475 0.525 8 Yes Preprocessor1_Model1
4 train/test split 0.940 0.0603 13 Yes Preprocessor1_Model1
5 train/test split 0.905 0.0946 14 Yes Preprocessor1_Model1
6 train/test split 0.503 0.497 20 No Preprocessor1_Model1
7 train/test split 0.436 0.564 21 No Preprocessor1_Model1
8 train/test split 0.612 0.388 22 No Preprocessor1_Model1
9 train/test split 0.562 0.438 30 No Preprocessor1_Model1
10 train/test split 0.831 0.169 32 Yes Preprocessor1_Model1
## … with 548 more rowsEn ROC-kurve kan let oprettes med følgende kode:
collect_predictions(final_model) %>%
  roc_curve(status, .pred_Yes) %>%
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal() +
  theme_bw()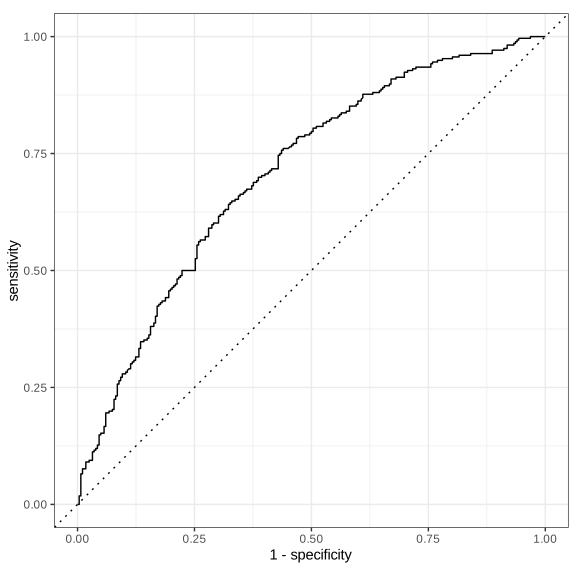
Variable importance
Vi kan udtrække variablernes betydning (relative variable importance) med pakken vip på følgende måde:
library(vip)

final_model %>%
  extract_fit_parsnip() %>%
  vip(geom = "point")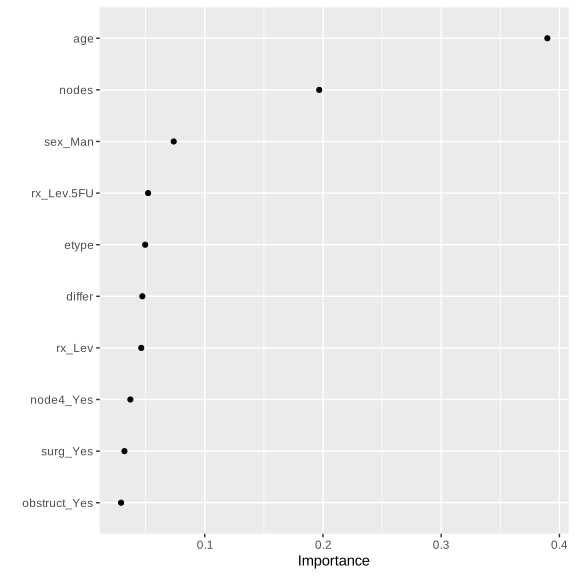
Referencer
Hvitfeldt E, Frick H (2022). censored: 'parsnip' Engines for Survival Models. R package version 0.1.1, https://github.com/tidymodels/censored.
Kuhn M, Vaughan D (2022). parsnip: A Common API to Modeling and Analysis Functions. https://github.com/tidymodels/parsnip, https://parsnip.tidymodels.org/.
Vaughan D, Couch S (2022). workflows: Modeling Workflows. https://github.com/tidymodels/workflows, https://workflows.tidymodels.org.