
I dette kapitel anvendes data om Pima-indianere. Diabetes er hyppigere blandt Pima-indianere, og i disse data er 768 personer undersøgt med hensyn til diabetes, blodsukker osv. Data findes i pakken mlbench. Du skal først installere mlbench og derefter aktivere data. Vi vil desuden lave en kopi af data som objektet pima.
## Installér og aktivér mlbench
install.packages("mlbench")
library(mlbench)

## Aktivér data
data(PimaIndiansDiabetes)

## Kopiér data
pima <- PimaIndiansDiabetes

## Inspicér data
head(pima)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
1 6 148 72 35 0 33.6 0.627 50 pos
2 1 85 66 29 0 26.6 0.351 31 neg
3 8 183 64 0 0 23.3 0.672 32 pos
4 1 89 66 23 94 28.1 0.167 21 neg
5 0 137 40 35 168 43.1 2.288 33 pos
6 5 116 74 0 0 25.6 0.201 30 negDen sidste kolonne (diabetes) angiver, om personen har diabetes (pos) eller ej (neg). I næste trin omkoder vi kolonnen diabetes til Yes eller Nej i stedet for henholdsvis pos og neg.
pima$diabetes = recode_factor(pima$diabetes,
                              'pos'='Yes',
                              'neg'='No')

head(pima)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
1 6 148 72 35 0 33.6 0.627 50 Yes
2 1 85 66 29 0 26.6 0.351 31 No
3 8 183 64 0 0 23.3 0.672 32 Yes
4 1 89 66 23 94 28.1 0.167 21 No
5 0 137 40 35 168 43.1 2.288 33 Yes
6 5 116 74 0 0 25.6 0.201 30 NoOpret træningsdata og testdata
Derefter bruger vi funktionen initial_split() til at oprette træningsdata og testdata. Vi angiver prop=0.7, så 70 % af data bruges til træning. Med funktionerne training() og testing() udtrækker vi derefter træningsdata og testdata til separate filer.
## Opretter træning og test
pima_split <- initial_split(pima, strata=diabetes, prop=0.7)
pima_train <- training(pima_split)
pima_test  <- testing(pima_split)
Bemærk i koden ovenfor, at vi angav strata=diabetes, hvilket betyder, at vores split stratificeres efter kolonnen diabetes. Det medfører, at andelen med Yes og No bliver lige stor i træningsdata og testdata. Det er ønskeligt, for at andelen, der rammes af diabetes, skal være lige stor i træningsdata og testdata.
Specificér model og metode
Vi begynder med at specificere, hvilken type model vi vil bruge. Det gøres ved hjælp af funktioner i pakken parsnip. Vi starter med at specificere, at vi vil bruge logistisk regression, hvilket vi gør med funktionen logistic_reg() i parsnip. Hvis vi blot skriver funktionens navn og kører koden, får vi følgende resultat:
logistic_reg()Logistic Regression Model Specification (classification)
Computational engine: glmAf ovenstående fremgår det, at en logistisk model er specificeret til klassifikation (classification), hvilket betyder, at udfaldet er en kategorisk variabel. Det vil blive gjort med glm (generalized linear model), som er den klassiske form for logistisk regression. Metoden ("engine") GLM er altså standardmetoden for logistisk regression i Tidymodels. Vi kan dog specificere andre metoder til logistisk regression. Det gør vi ved at tilføje funktionen set_engine() og angive en metode. Alle mulighederne for logistic_reg() findes i dokumentationen her.
Vi har endnu ikke gemt vores specifikation. Nedenfor specificerer vi en logistisk regression ved hjælp af GLM, og den skal bruges til klassifikation. Det sidstnævnte angives med funktionen set_mode(). Denne funktion er særlig vigtig, hvis modellen kan bruges både til klassifikation (prædiktion af kategoriske udfald) og regression (prædiktion af kontinuerte udfald). Vi gemmer specifikationen i objektet log_mod.
log_mod <-
  logistic_reg() |>
  set_engine("glm") |>
  set_mode("classification")

log_mod
Logistic Regression Model Specification (classification)
Computational engine: glmSpecificér en formel
Vi går videre med at specificere selve formlen med funktionen fit() og tilføjer dette til objektet log_mod. Bemærk, at formlen diabetes ~ . betyder, at vi opretter en model, hvor diabetes er udfaldet og alle andre variabler er prædiktorer, hvilket angives med punktummet (.):
log_fit <-
  log_mod |>
  fit(diabetes ~ ., data=pima_train)

## Udskriv resultatet
log_fit
parsnip model object
Call: stats::glm(formula = diabetes ~ ., family = stats::binomial,
data = data)
Coefficients:
(Intercept) pregnant glucose pressure triceps insulin mass pedigree age
8.591e+00 -1.499e-01 -3.117e-02 1.470e-02 5.995e-06 1.321e-03 -1.056e-01 -7.798e-01 -2.357e-02
Degrees of Freedom: 536 Total (i.e. Null); 528 Residual
Null Deviance: 694.2
Residual Deviance: 500.4 AIC: 518.4Udtræk resultater
Resultatet bliver pænere med funktionen tidy() fra pakken broom. Vi angiver, at argumenterne exponentiate og conf.int er TRUE for at få eksponentierede koefficienter samt konfidensintervaller:
tidy(log_fit, exponentiate=T, conf.int=T) term estimate std.error statistic p.value conf.low conf.high
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 5382. 0.873 9.84 7.85e-23 1040. 32053.
2 pregnant 0.861 0.0386 -3.88 1.05e- 4 0.797 0.928
3 glucose 0.969 0.00431 -7.24 4.61e-13 0.961 0.977
4 pressure 1.01 0.00648 2.27 2.32e- 2 1.00 1.03
5 triceps 1.00 0.00843 0.000711 9.99e- 1 0.984 1.02
6 insulin 1.00 0.00102 1.29 1.97e- 1 0.999 1.00
7 mass 0.900 0.0192 -5.51 3.52e- 8 0.866 0.933
8 pedigree 0.458 0.365 -2.14 3.27e- 2 0.222 0.930
9 age 0.977 0.0109 -2.16 3.04e- 2 0.956 0.998Kolonnen estimate er odds ratio. Kolonnerne conf.low og conf.high er henholdsvis nedre og øvre grænse for 95 %-konfidensintervallet.
Prædiktér
I næste trin bruges modellen til at prædiktere på testdata (pima_test). Det gøres med funktionen predict(). Resultatet gemmes i en ny kolonne i pima_test. Den nye kolonne hedder predicted:
pima_test$predicted <- predict(log_fit,
                               new_data = pima_test,
                               type="prob")
Hvis vi undersøger pima_test, ser vi, at den nye kolonne faktisk består af to kolonner, nemlig .pred_Yes og .pred_No. Det betyder, at der er tale om en "nestet" kolonne, eftersom den består af flere kolonner.
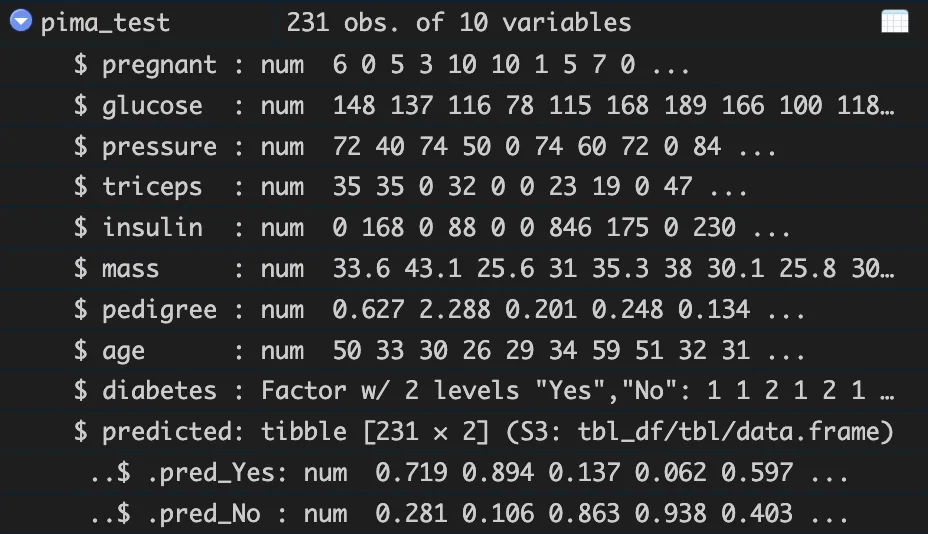
Nestede kolonner er ganske vist en effektiv lagringsform, men i dette tilfælde noget upraktiske. Derfor bryder vi kolonnerne ud i separate kolonner ved hjælp af funktionen unnest() på følgende måde:
pima_test <- unnest(pima_test, predicted)

## Inspicér data
head(pima_test)
pregnant glucose pressure triceps insulin mass pedigree age diabetes .pred_Yes .pred_No
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <fct> <dbl> <dbl>
1 6 148 72 35 0 33.6 0.627 50 Yes 0.719 0.281
2 0 137 40 35 168 43.1 2.29 33 Yes 0.894 0.106
3 5 116 74 0 0 25.6 0.201 30 No 0.137 0.863
4 3 78 50 32 88 31 0.248 26 Yes 0.0620 0.938
5 10 115 0 0 0 35.3 0.134 29 No 0.597 0.403
6 10 168 74 0 0 38 0.537 34 Yes 0.885 0.115
7 1 189 60 23 846 30.1 0.398 59 Yes 0.760 0.240
8 5 166 72 19 175 25.8 0.587 51 Yes 0.658 0.342
9 7 100 0 0 0 30 0.484 32 Yes 0.361 0.639
10 0 118 84 47 230 45.8 0.551 31 Yes 0.384 0.616Kolonnerne .pred_Yes og .pred_No er de prædikterede sandsynligheder for henholdsvis udfaldet Yes og No ifølge den logistiske regressionsmodel. Summen af sandsynlighederne for Yes og No er altid 1,0.
Evaluér modellen
Hvis vi kun betragter sandsynligheden for Yes (.pred_Yes), kan vi for eksempel vælge at prædiktere, at personen har diabetes, hvis sandsynligheden er >0,5 (større end 0,5). Grænsen 0,5 bruges ofte som standard i mange pakker og funktioner, fordi værdier >0,5 betyder, at det er mere sandsynligt, at hændelsen indtræffer (i dette tilfælde diabetes), end at den udebliver. Denne grænse kaldes ofte decision threshold. Man kan naturligvis sænke decision threshold til 0,4; 0,35; 0,2 eller endnu lavere. Jo lavere tærsklen er, desto flere personer med diabetes vil blive opdaget, men desto flere personer får falsk positive diagnoser. Der findes enkle funktioner til at evaluere sensitivitet og specificitet for et stort antal decision thresholds. Med funktionen roc_curve() beregner vi sensitivitet og specificitet for over 200 decision thresholds:
pima_test %>%
  roc_curve(diabetes, .pred_Yes)
.threshold specificity sensitivity
<dbl> <dbl> <dbl>
1 -Inf 0 1
2 0.00171 0 1
3 0.0133 0.00667 1
4 0.0176 0.0133 1
5 0.0190 0.0200 1
6 0.0210 0.0267 1
7 0.0260 0.0333 1
8 0.0279 0.0400 1
9 0.0282 0.0467 1
10 0.0297 0.0533 1
....Vi kan automatisk beregne arealet under ROC-kurven med følgende kode:
pima_test %>%
  roc_auc(diabetes, .pred_Yes)
.metric .estimator .estimate
roc_auc binary 0.840AUC ROC er 0,840.
ROC-kurven fås med følgende kode:
pima_test %>%
  roc_curve(diabetes, .pred_Yes) %>%
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal()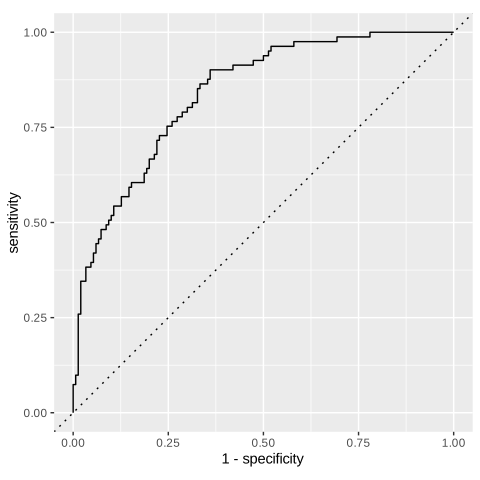
For interessens skyld kan vi lave modellen om, men denne gang med extreme gradient boosting (XGBoost), som er en meget potent model. XGBoost findes i funktionen boost_tree(). Den har hyperparametre (eksempelvis tree_depth), som egentlig bør optimeres, men det gøres ikke i dette eksempel. Hyperparametrene får en enkelt standardværdi for enkelhedens skyld. I linje 13 opretter vi en ny data frame kaldet resultat, som kun indeholder kolonnen diabetes fra pima_test. I linje 16 bruger vi vores XGBoost-model til at prædiktere sandsynligheden for diabetes, og resultatet sendes til kolonnen predicted2 i resultat. I linje 21 unnester vi kolonnen predicted2. Derefter beregnes AUC-ROC og ROC-kurven.
## Specificér model og metode
xgb_mod <-
  boost_tree(tree_depth = 4,
             trees = 600,
             learn_rate = 0.005,
             min_n = 5,
             sample_size = 0.5) |>
  set_engine('xgboost') |>
  set_mode('classification') |>
  fit(diabetes ~ ., data=pima_train)

## Opret en data frame med faktiske diagnoser
resultat <- data.frame(diabetes = pima_test$diabetes)

## Prædiktér diagnose
resultat$predicted2 <- predict(xgb_mod,
                               new_data = pima_test,
                               type="prob")

## Unnest kolonnen predicted2
resultat <- unnest(resultat, predicted2)

## ROC AUC
resultat %>%
    roc_auc(diabetes, .pred_Yes)

## ROC-kurven
resultat |>
  roc_curve(diabetes, .pred_Yes) |>
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal()
.metric .estimator .estimate
roc_auc binary 0.844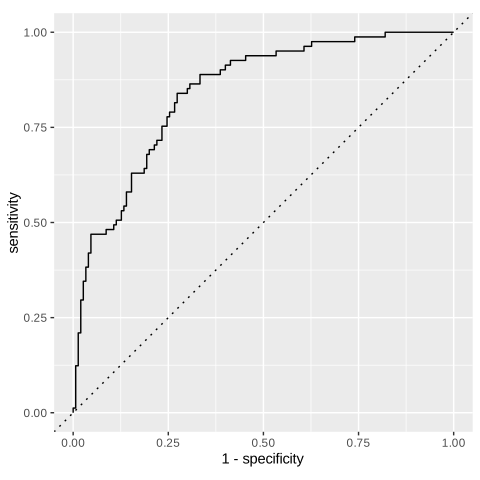
ROC for XGBoost uden hyperparametertuning var 0,844 sammenlignet med 0,840 for logistisk regression.
Variable importance
Machine learning af denne type har indbyggede metoder til at sammenligne prædiktorernes relative betydning. Det kaldes relative variable importance. Pakken vip (variable importance) kan bruges til at udtrække denne information fra Tidymodels-objekter på følgende måde:
library(vip)
xgb_mod %>% vip(geom = "point")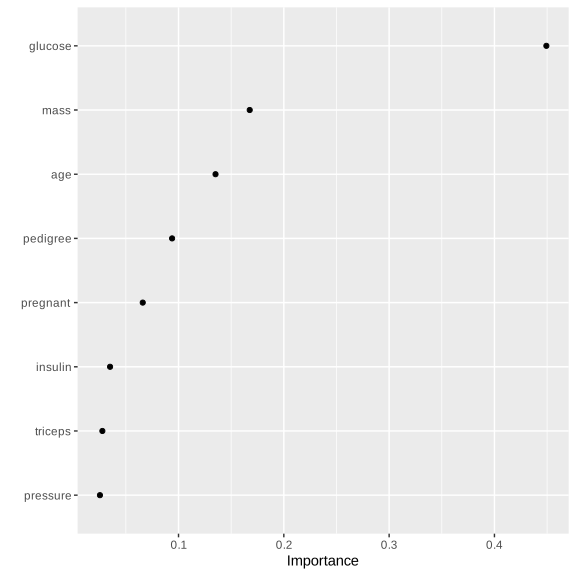
Spørgsmål og svar
Hvor findes listen over tilgængelige modeller og metoder? Klik her for at komme til parsnips dokumentation.