
Regression
Med regression undersøger man sammenhængen (associationen) mellem to eller flere variabler. I en regressionsanalyse prædikteres en variabel () af mindst én prædiktor (). Rent terminologisk siges at være afhængig af ; er derfor den afhængige variabel, og er den uafhængige variabel.
| Rolle i modellen | Synonym | |
|---|---|---|
| Y | Variablen, der skal prædikteres | Afhængig variabel, dependent variable, outcome, udfald, udfaldsmål, label, target |
| X | Bruges til at prædiktere Y | Prædiktor, predictor, feature, kovariat, covariate |
Lad os antage, at vi undersøger sammenhængen mellem BMI (body mass index) og blodsukker. Med regression kan vi bruge den ene variabel til at prædiktere værdien af den anden. I dette tilfælde bruges BMI til at prædiktere blodsukker. BMI er således uafhængig (prædiktor), og glukose er afhængig (outcome).
Vi vil illustrere lineær regression med data fra Pima-indianere, som har meget høj risiko for diabetes. Data fra Pima-indianere findes i pakken mlbench. Installér mlbench, og aktivér pakken samt datasættet med Pima-indianere med følgende kommando:
library(mlbench)
data(PimaIndiansDiabetes)

## Graf med sammenhængen mellem mass og glucose
ggplot(data=PimaIndiansDiabetes,
       aes(x=mass, y=glucose, color=diabetes)) +
  geom_point() +
  geom_smooth()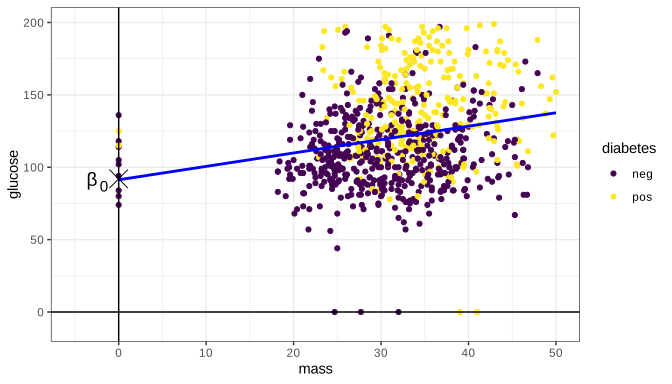
Figuren ovenfor viser, hvordan BMI (mass) er associeret med blodsukker (glucose). I grafen ses en ret blå linje, som udgør regressionslinjen for mass. Sammenhængen mellem mass og glucose kan beskrives med en enkel formel.
- er interceptet, dvs. det punkt, hvor regressionslinjen skærer Y-aksen (se figuren ovenfor).
- er koefficienten for
mass, hvilket betyder, at det er værdien af regressionslinjens hældning. - er forskellen mellem modellens prædikterede værdi af og den observerede værdi af . Dette er altså modellens fejl (error).
Sammenfattende er dette en model, der prædikterer ved hjælp af en regressionslinje, hvis hældning er . Interceptet () interesserer os meget sjældent. Modellens fejl () er et mål for, hvor god modellen er.
Målet er at skabe en regressionslinje, hvis hældning tilpasses, så den repræsenterer sammenhængen mellem og . Linjens hældning afhænger af sammenhængen mellem mass og glucose. Hældningen for mass kaldes også koefficienten for mass. Hvis glucose stiger med stigende mass, vil regressionslinjen have en positiv hældning. I figuren ovenfor ses det, at linjen har en positiv hældning, og derfor er koefficienten for mass positiv.
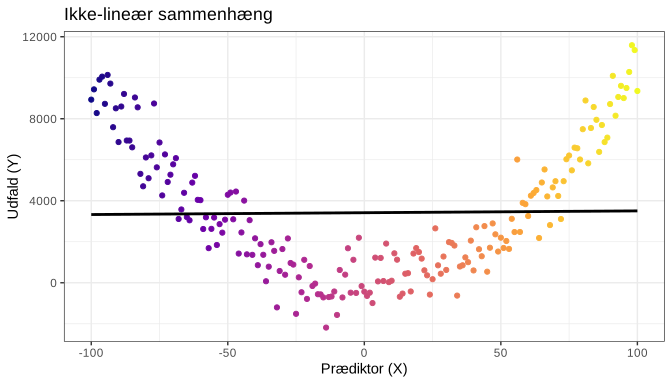
Bemærk, at relationen mellem og skal være lineær, for at den lineære model kan anvendes. Hvis sammenhængen ikke er lineær, kan den lineære model blive misvisende. Her følger et eksempel på en ikke-lineær sammenhæng mellem og . Den beregnede regressionslinje formår ikke at indfange sammenhængen mellem og .
Vi fortsætter med at oprette en lineær regressionsmodel i R. Det gøres med funktionen lm(), som findes i base R (du behøver ikke installere nogen pakke).
modell <- lm(glucose ~ mass, data=PimaIndiansDiabetes)

summary(modell)Call:
lm(formula = glucose ~ mass, data = PimaIndiansDiabetes)
Residuals:
Min 1Q Median 3Q Max
-128.970 -20.756 -3.705 19.509 81.568
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 92.2129 4.7083 19.585 < 0.0000000000000002 ***
mass 0.8965 0.1429 6.274 0.000000000589 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 31.2 on 766 degrees of freedom
Multiple R-squared: 0.04887, Adjusted R-squared: 0.04763
F-statistic: 39.36 on 1 and 766 DF, p-value: 0.0000000005891Af ovenstående resultat fremgår følgende:
- Interceptet er 92,2, hvilket betyder, at regressionslinjen skærer Y-aksen ved Y=92,2, og det synes at stemme med den grafiske undersøgelse.
- , dvs. koefficienten for mass, er 0,8965. Det betyder, at hvis
massøges med 1 enhed, øgesglucosemed 0,8965 enheder.
Beregning af regressionslinjen
Fundamentalt for regressionsanalyse er beregningen af regressionslinjen. Den mest almindelige metode er least-squares method (på dansk mindste kvadraters metode). Least-squares kan også kaldes ordinary least-squares. Metoden skaber en linje, der minimerer summen af error. I nedenstående figur er de samme data som ovenfor (Pima-indianerne) forstørret i intervallet 50 til 150 på x-aksen og y-aksen for at tydeliggøre, hvad kvadratsummer er. I nedenstående figur ses også en regressionslinje.
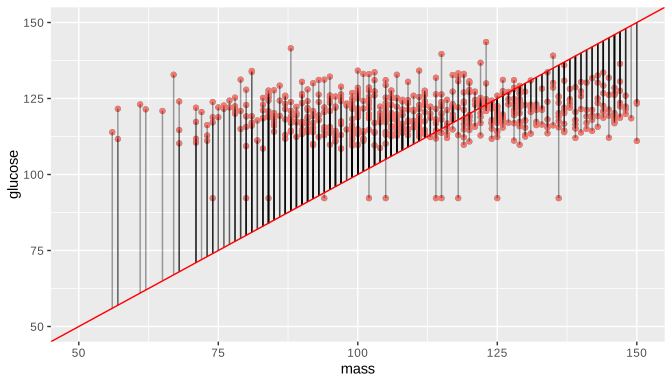
Least-squares sigter mod at skabe en regressionslinje, der minimerer summen af alle observationers error. I figuren ovenfor fremgår det, at regressionslinjens afstand til punkterne varierer meget. I intervallet 100 til 140 på x-aksen ligger linjen tæt på punkterne (error bliver lille), men uden for dette interval ligger linjen længere fra punkterne (error bliver større). Mindste kvadraters metode går ud på at minimere den samlede (totale) error. Linjen vippes frem og tilbage, indtil hældningen minimerer summen af alle error. Før man lægger alle error sammen, kvadreres de; formålet med dette er, at alle negative error (dem, der ligger under linjen) skal blive positive værdier. Summen af alle kvadrerede error kaldes RSS (Residual Sum of Squares). Den lineære models opgave er således at finde de og , der minimerer RSS. Formlen for RSS er som følger:
Coefficient of determination: R2
For at estimere styrken af sammenhængen mellem og kan man bruge coefficient of determination, også kaldet . Denne værdi går fra 0 til 1. Hvis er 0, er der ingen sammenhæng, og hvis er 1, er der en perfekt sammenhæng, hvilket betyder, at kan forklare hele variationen i .
Antagelser for regression med least-squares method
Følgende antagelser kræves, for at least-squares kan anvendes:
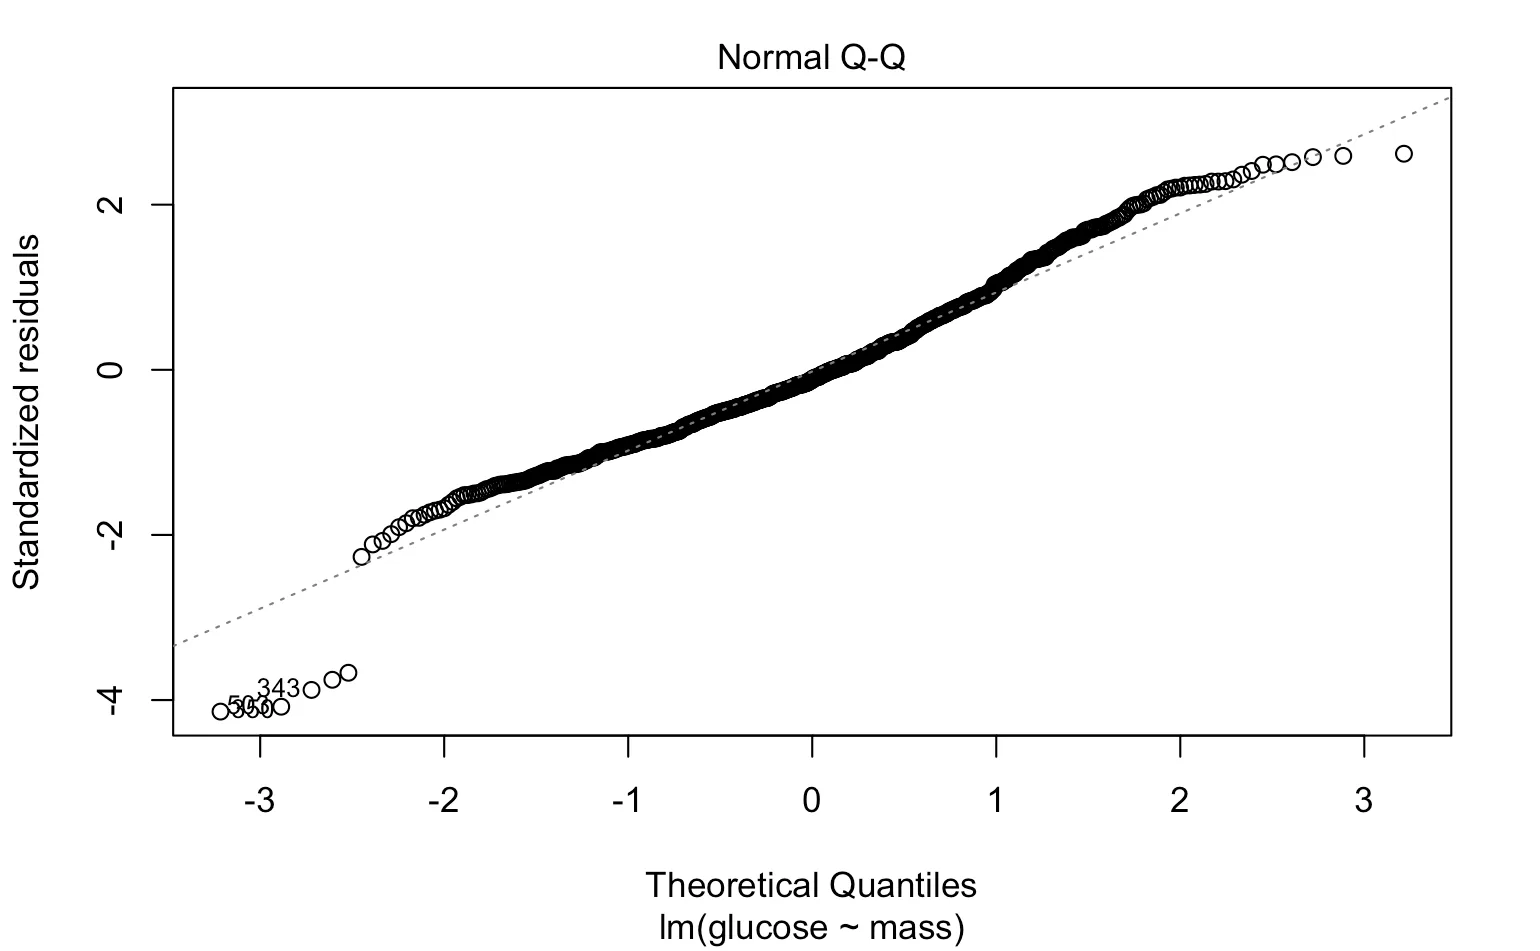
- Residualerne skal være normalfordelte med middelværdien 0. Dette kan kontrolleres med et såkaldt quantile-quantile plot. I et quantile-quantile plot skal der ses en ret linje, hvis antagelsen er opfyldt.
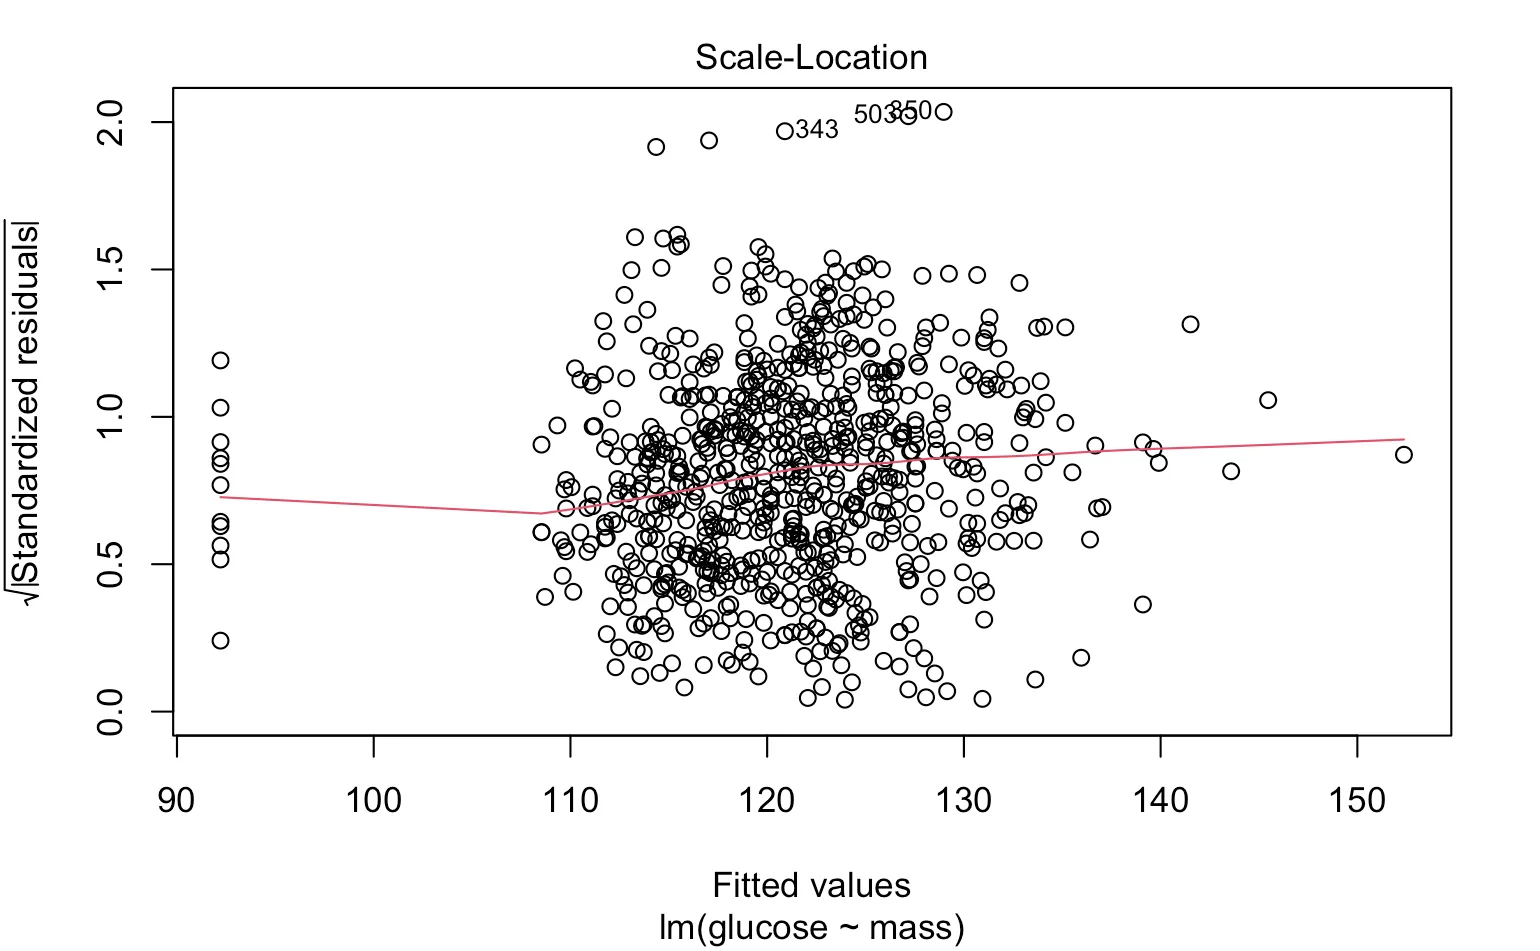
- Residualerne skal have konstant varians. Dette kan kontrolleres med et scatterplot af estimerede residualer mod fitted values. Scatterplottet skal vise en sky uden nogen sammenhæng mellem værdierne.
- Residualerne skal være uafhængige af hinanden. Dette er sjældent et problem, medmindre den samme person/celle/bakterie/enhed/etc. indgår flere gange i studiepopulationen. Hvis den samme person indgår flere gange i studiepopulationen (eksempelvis ved gentagne målinger af BMI og glukose), er disse observationers residualer afhængige af hinanden.
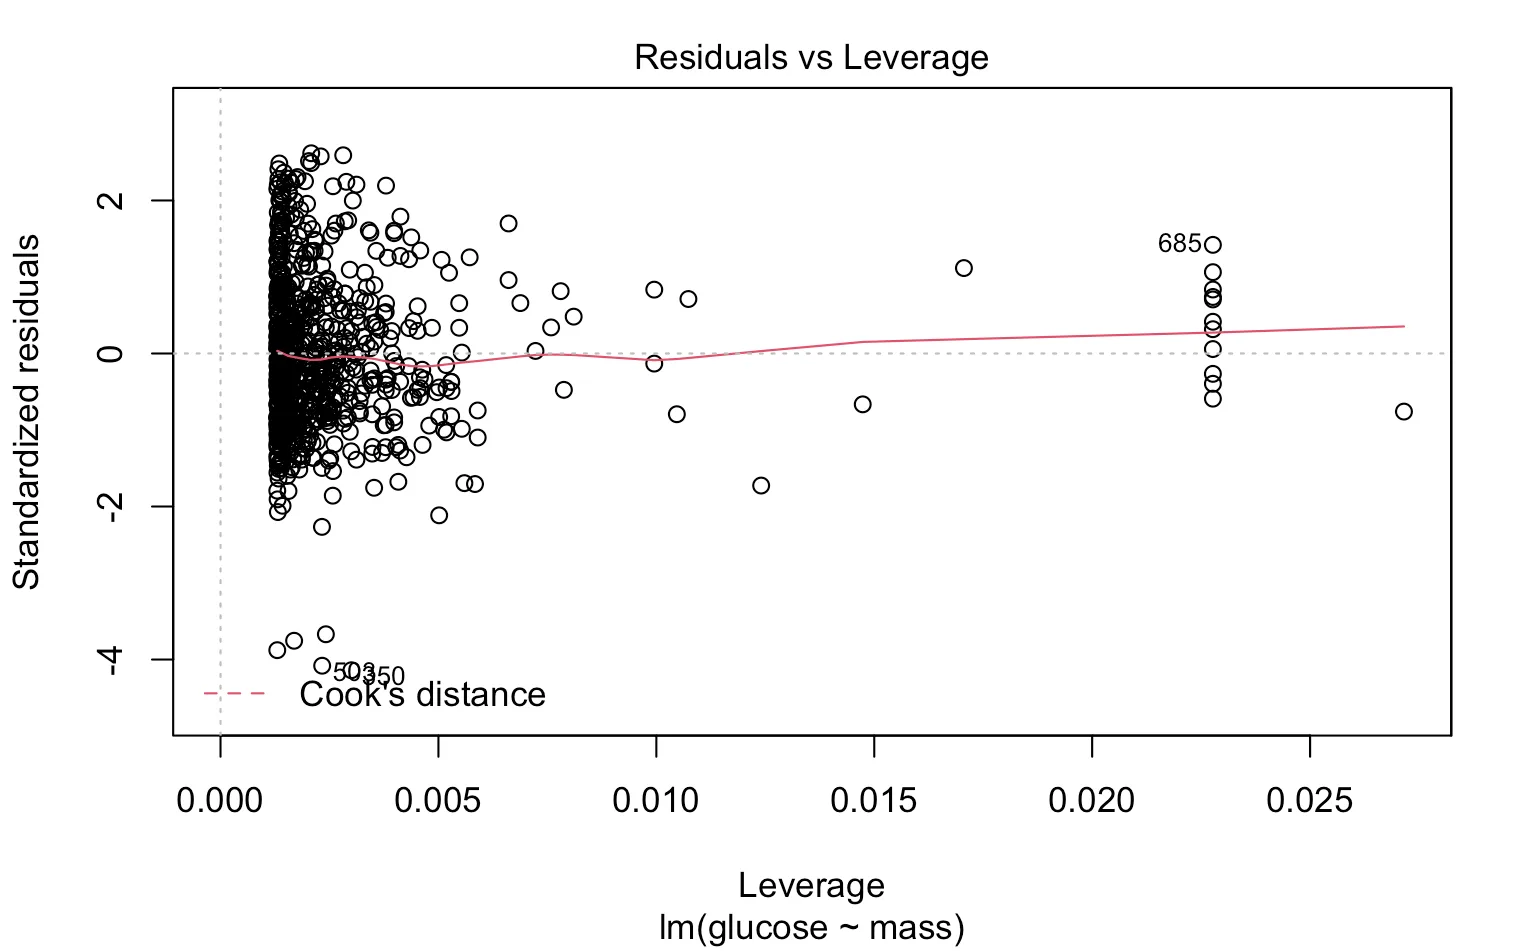
Punkt (1) og (2) kan let undersøges i R med følgende kommando, som returnerer alle nødvendige grafer:
plot(modell)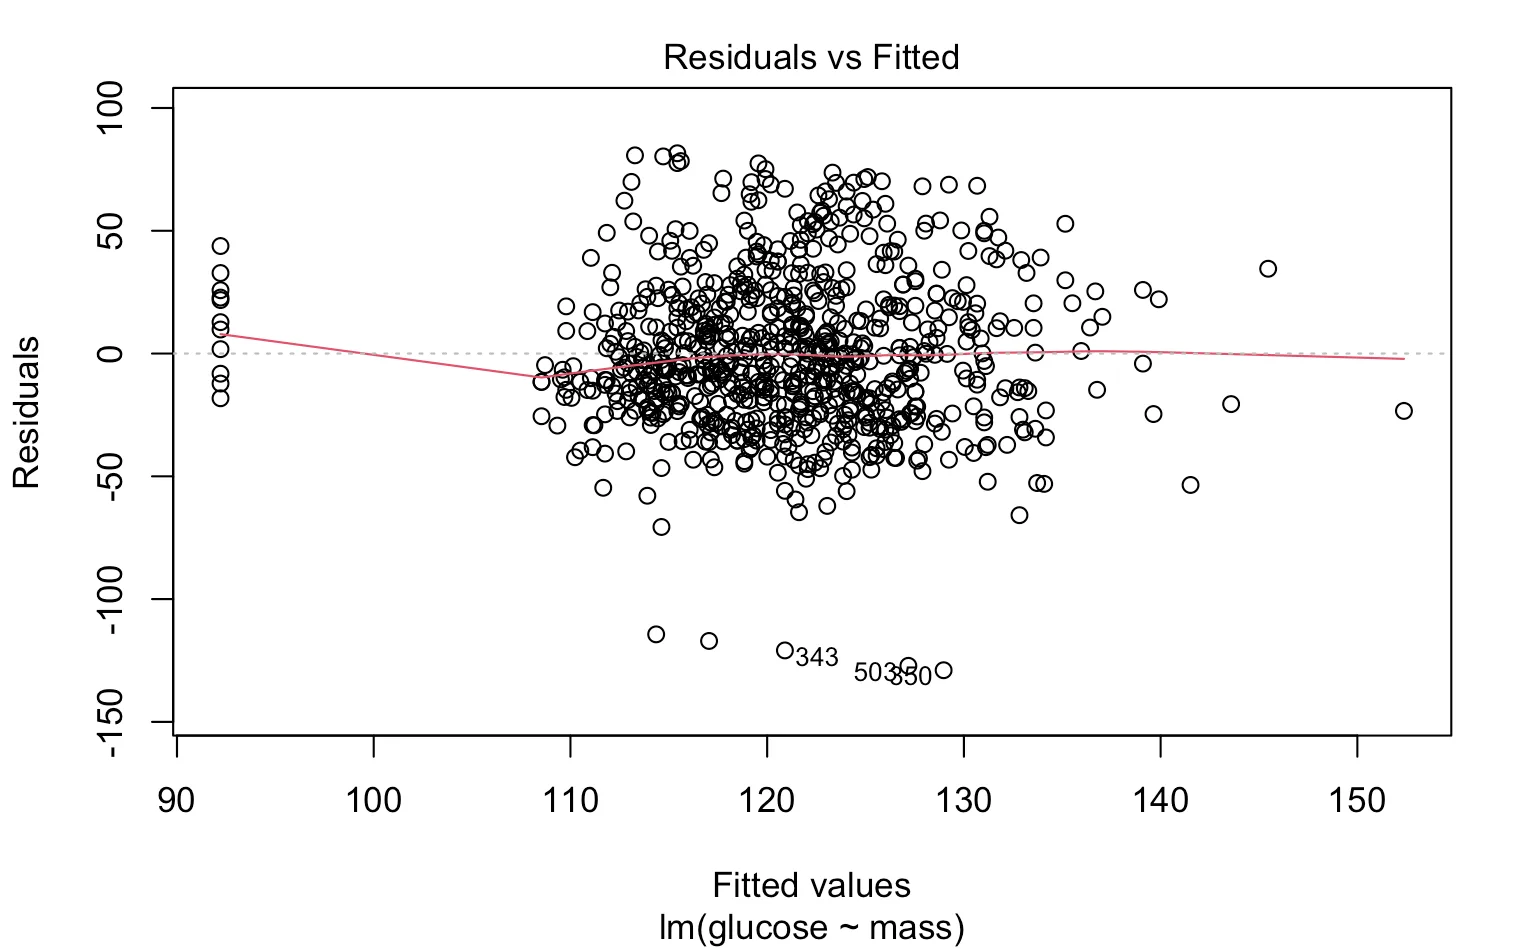
Prædiktion med regression
Regressionsmodellen kan bruges til prædiktion. Det betyder, at vi kan gætte værdien af Y for en given værdi af X. Det kan eksempelvis være af interesse at forudsige, hvad glucose vil være ved en given mass. For at gøre dette opretter vi nu en ny model med specifikationen glucose ~ ., hvilket betyder, at vi modellerer glucose mod alle andre variabler. Derefter bruger vi predict() med modelobjektet (modell_2) og angiver, hvilke data vi vil teste modellen på. I dette tilfælde tester vi på de samme data, som vi trænede på, hvilket ikke anbefales. Vi gemmer den prædikterede værdi som en ny kolonne (Predicted_Glucose) i samme dataframe. Allersidst udskriver vi de første 10 rækker med observerede værdier og prædikterede værdier.
modell_2 <- lm(glucose ~ ., data=PimaIndiansDiabetes)

PimaIndiansDiabetes$Predicted_Glucose <- predict(modell_2, newdata=PimaIndiansDiabetes)

select(PimaIndiansDiabetes, glucose, Predicted_Glucose) %>%
  slice(1:10)
glucose Predicted_Glucose
1 148 134.03797
2 85 100.53489
3 183 130.46052
4 89 106.04599
5 137 145.69693
6 116 106.94069
7 78 128.57557
8 115 98.26398
9 197 181.40914
10 125 136.97599Multipel regression
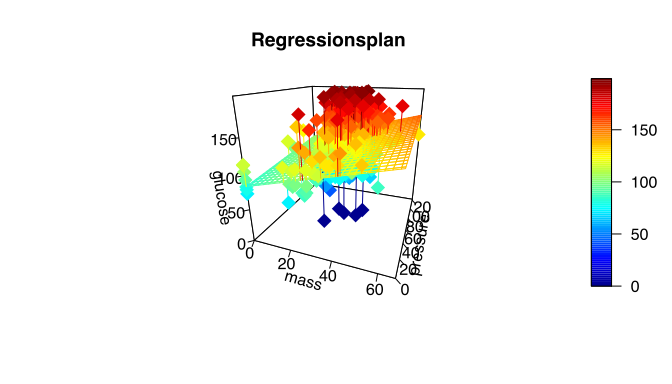
Hvis vi vil undersøge, hvordan BMI (mass) samvarierer med glukose (glucose) og samtidig tage højde for alder, bruger vi multipel regression. Definitionen af multipel regression er ganske enkelt regression med mindst 2 prædiktorer. Multipel regression følger de samme principper som den lineære regression, der hidtil er gennemgået. Least-squares-metoden anvendes som sædvanligt, men i dette tilfælde tilpasses ikke en regressionslinje, men i stedet et regressionsplan gennem datapunkterne. Dette plan har et tredimensionelt udseende, som illustreres nedenfor med de samme data. Den anden prædiktor er pressure (blodtryk).
Koden for regressionsmodellen bliver:
modell_2 <- lm(glucose ~ mass + pressure, data=PimaIndiansDiabetes)
summary(modell_2)Call:
lm(formula = glucose ~ mass + pressure, data = PimaIndiansDiabetes)
Residuals:
Min 1Q Median 3Q Max
-129.725 -20.893 -3.277 19.206 80.092
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 84.60294 5.48135 15.435 < 0.0000000000000002 ***
mass 0.78442 0.14834 5.288 0.000000161 ***
pressure 0.16201 0.06042 2.681 0.00749 **
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 31.08 on 765 degrees of freedom
Multiple R-squared: 0.05773, Adjusted R-squared: 0.05526
F-statistic: 23.43 on 2 and 765 DF, p-value: 0.0000000001326Fortolkningen af koefficienterne er som følger.
- Når
massstiger med 1 enhed, øgesglucosemed 0,78442 enheder. Denne effekt er justeret for pressure. - Når
pressurestiger 1 enhed, øgesglucosemed 0,16201 enheder. Denne effekt er justeret formass.