
Korrelation er ikke regression
At undersøge sammenhængen (associationen, relationen) mellem to eller flere variabler er almindeligt inden for al forskning og analyse. I denne sammenhæng er termerne sammenhæng, association og relation synonymer. Eksempler på sammenhænge, der kan undersøges, er sammenhængen mellem kolesterol og myokardieinfarkt, eller mellem BMI (Body Mass Index) og blodsukker. Når man har kortlagt associationen mellem variabler, kan følgende spørgsmål besvares:
- Er der en relation mellem variablerne?
- Hvor stærk er relationen mellem variablerne?
- Hvordan ser relationen ud?
Til at studere associationer mellem variabler anvendes oftest korrelation og regression. Med korrelation kan man studere, hvor stærk en lineær sammenhæng mellem to variabler er. Regression er et kraftigere værktøj; med regression kan man nemlig studere, hvor stærk sammenhængen er; man kan studere flere end to variabler samtidig, og man kan bruge resultatet til at prædiktere (lave prædiktioner). At prædiktere betyder, at man bruger en statistisk model til at forudsige værdien af en variabel, hvis værdi er ukendt, ud fra variabler med kendte værdier. Variabler, der bruges til at prædiktere, kaldes prædiktorer. Variablen, der skal prædikteres, betegnes matematisk med og har flere synonymer, f.eks. udfald, udfaldsmål, outcome, afhængig variabel, label osv.
Antag, at vi studerer relationen mellem BMI (Body Mass Index) og blodsukker. Med korrelation kan vi klarlægge, hvor stærk relationen mellem BMI og blodsukker er. Med regression kan vi, ud over at udtale os om relationens styrke, også beskrive, hvordan sammenhængen ser ud, samt lære at prædiktere (forudsige) blodsukker for forskellige værdier af BMI.
Korrelation og regression: kausalitet eller association?
Kausalitet er blevet diskuteret tidligere. Se kapitlet Kausal inferens (kausalitet) for detaljer.
Begrebet kausalitet er centralt inden for al forskning og analyse. En kausal sammenhæng mellem to faktorer betyder, at den ene faktor påvirker den anden. Der er således årsag og virkning mellem faktorerne. Der er en kausal sammenhæng mellem LDL-kolesterol og risikoen for koronararteriesygdom. Det betyder, at efterhånden som LDL-kolesterol stiger, øges risikoen for koronararteriesygdom. Sammenhængen mellem LDL-kolesterol og koronararteriesygdom er således kausal. Som diskuteret i kapitlet Kausal inferens (kausalitet) er dette emne temmelig komplekst. Det centrale teorem er, at en matematisk association (hvad enten den er påvist med korrelation, regression eller machine learning) ikke nødvendigvis er kausal. Alle associationer skal fortolkes med forsigtighed, og vurderingen af, at en sammenhæng er kausal, skal baseres på omfattende, multidisciplinær og reproducerbar videnskab.
Et eksempel på en ikke-kausal sammenhæng følger:
Antag, at vi undersøger sammenhængen mellem gule fingre og risikoen for lungecancer. Vi undersøger 5000 personer og graderer deres fingre fra 0 til 50 med hensyn til, hvor gule fingrene er, og vi opdager, at jo gulere fingre, desto højere risiko for lungecancer. I dette tilfælde er sammenhængen mellem gule fingre og lungecancer ægte, dvs. der er en matematisk bekræftet sammenhæng. Gule fingre er dog ikke årsagen til lungecancer; det er mere sandsynligt, at personer med gule fingre ryger, og jo mere man ryger, desto gulere er fingrene. Det er rygning, der forklarer både gule fingre og lungecancer. Selv om gule fingre ikke var årsagen til canceren, er klarlæggelsen af sammenhængen alligevel vigtig, fordi (1) gule fingre kan bruges klinisk til screening, og (2) gule fingre kan føre os til den egentlige årsag til canceren.
Korrelation og korrelationskoefficienten
En korrelation omfatter to variabler (herefter og ). Disse variabler behandles ens, forstået på den måde, at ingen af dem betragtes som prædiktor eller udfald (outcome). Korrelationen mellem og repræsenterer sammenhængen mellem variablerne. Korrelationen strækker sig fra –1 til +1, og denne værdi, som kaldes korrelationskoefficienten, har ingen enhed. Hvis korrelationskoefficienten er +1, indikerer det en perfekt positiv lineær sammenhæng mellem og . Hvis koefficienten i stedet er –1, indikerer det en perfekt negativ lineær sammenhæng mellem og . Hvis korrelationskoefficienten er 0, er der ingen sammenhæng mellem og .
Vi skal nu visualisere og beregne korrelationen for to variabler i mtcars-data. Til at visualisere korrelationen og beregne korrelationskoefficienten bruger vi pakken ggpubr, som har funktionen ggscatter(). Kommentarerne nedenfor forklarer argumenterne.
library(tidyverse)
data("mtcars")

library(ggpubr)
ggscatter(mtcars,
          x = "wt",
          y = "mpg",
          size = 3,
          add = "reg.line",
          cor.coef = TRUE,
          cor.coeff.args = list(method = "pearson", label.x = 3, label.sep = "\n"))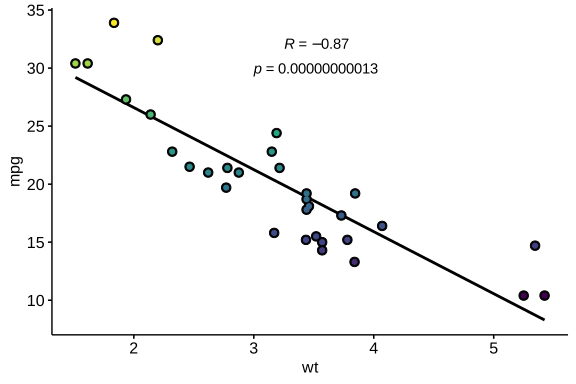
Korrelationskoefficienten var -0,87. Hvilket er en stærk negativ sammenhæng. Bemærk, at linjen i ovenstående graf er en regressionslinje. Korrelationer resulterer ikke i linjer gennem data.
Vi kan generere en korrelationsmatrix for mange variabler samtidig med funktionen ggpairs() i pakken GGally. Koden og resultatet er som følger:
library(GGally)
ggpairs(mtcars,
        # Hvilke kolonner?
       columns = 1:4,
       ggplot2::aes(colour=factor(am)))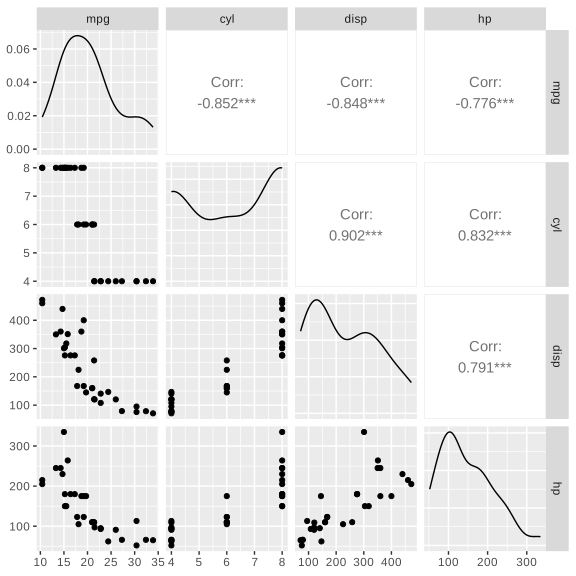
Korrelationskoefficienten er et mål for den lineære sammenhæng mellem X og Y. Koefficienten kan maksimalt være –1 eller +1, afhængigt af om sammenhængen er henholdsvis negativ eller positiv. Jo tættere korrelationen er på 0, desto svagere er sammenhængen. Jo tættere korrelationen er på –1 eller +1, desto stærkere er sammenhængen. Hvis korrelationskoefficienten er 0, fører en ændring i X ikke til en ændring i Y.
Pearsons korrelationskoefficient
Korrelationskoefficienten skal beregnes ud fra data. Der er flere muligheder for at beregne koefficienten. Den mest populære korrelationskoefficient er Pearson’s Product-Moment Coefficient of Correlation, eller blot Pearsons korrelationskoefficient. Den forkortes med bogstavet r. Pearsons korrelationskoefficient fås ved at dividere variablerne og s kovarians med produktet af deres standardafvigelser.
Kovarians og korrelation
Kovarians minder om korrelation. Kovarians er et mål for to variablers (, ) samvariation (dvs. hvordan og varierer sammen). Hvis højere værdier af X svarer til højere værdier af Y, og omvendt, er der en samvariation mellem og . Positiv kovarians betyder, at højere værdier af svarer til højere værdier af . Negativ kovarians betyder det omvendte.
Kovarians er den lineære samvariation mellem og , hvilket minder meget om korrelationen mellem og . Kovarians er dog sværere at fortolke og sammenligne. For eksempel kan man ikke sammenligne, om kovariansen mellem alder og kropsvægt er lige så stærk som kovariansen mellem alder og højde, fordi kovariansen er skalaafhængig (hvis variablerne ikke har samme skala, kan de ikke sammenlignes). Løsningen på problemet er at normalisere kovariansen. Dette gøres ved at dividere kovariansen med en faktor, der repræsenterer skalaen og variationen i og . Dette giver en værdi, der strækker sig fra –1 til +1, uanset hvilke variabler man undersøger. Det gør det også muligt at sammenligne korrelationer mellem variabler. For Pearsons korrelationskoefficient er denne faktor altså produktet af variablernes (, ) standardafvigelser.
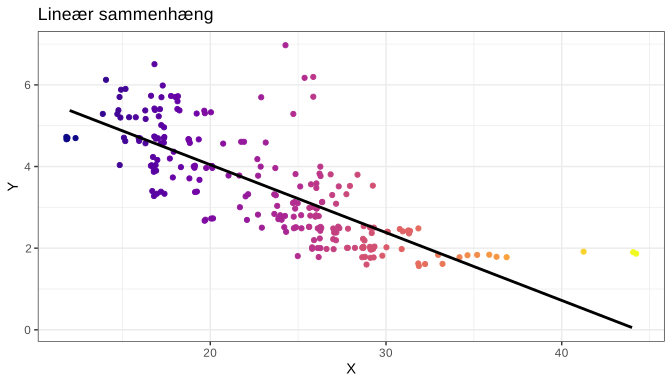
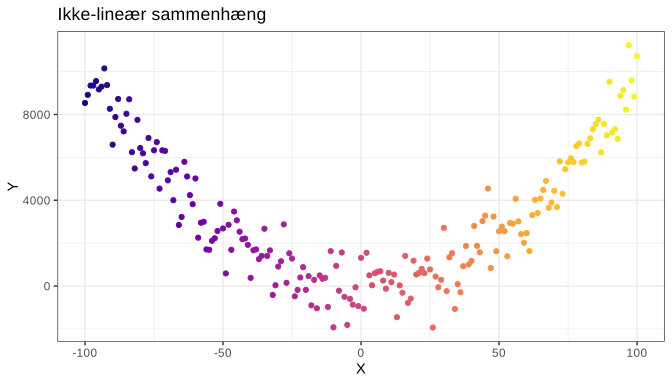
Pearsons korrelationskoefficient bygger på antagelsen om, at og er normalfordelte, og at sammenhængen mellem og er lineær. Pearsons metode er altså parametrisk (den kræver, at variablerne er normalfordelte). Figuren nedenfor viser henholdsvis en lineær og en ikke-lineær sammenhæng.
Spearman rank correlation coefficient (Spearmans korrelationskoefficient)
Hvis variablerne ( og ) ikke opfylder antagelserne ovenfor, findes der ikke-parametriske metoder (dvs. de kræver ikke normalfordeling). Den mest anvendte ikke-parametriske metode er Spearman rank correlation coefficient, eller blot Spearmans korrelationskoefficient. Med denne metode sammenlignes i stedet rangordenen mellem og . Ved at bruge rangorden bliver beregningen mere robust, hvis sammenhængen ikke er lineær. Rangordenen mindsker også betydningen af eventuelle outliers (ekstremværdier).
Hvis antagelserne for Pearsons korrelationskoefficient er opfyldt, bør man ikke bruge Spearmans korrelation, fordi den er mindre effektiv, hvilket betyder, at Pearsons har større mulighed for at påvise en sammenhæng (hvis en sådan findes).
Man kan også transformere og (eller begge), hvis de ikke opfylder Pearsons antagelser. Transformationen kan for eksempel foretages ved, at en eller begge variabler logaritmeres. Dette kan ofte resultere i, at Pearsons antagelser bliver opfyldt. Transformationen påvirker ikke Spearmans korrelationskoefficient, fordi denne udelukkende bruger variablernes rangorden, som ikke påvirkes af transformationen.
Hvordan undersøger jeg, om variablerne er normalfordelte?
Svar: Lav et histogram for hver variabel.
Hvordan undersøger jeg, om relationen mellem og er lineær?
Svar: Punktdiagrammer kan bruges til (visuelt) at undersøge, hvordan relationen ser ud.
Eksempel i R
Aktivér tidyverse, og indlæs diamonds-data, som indeholder information om forskellige diamanter.
library(tidyverse)
data(diamonds)
Lav derefter et punktdiagram med pris (price) på x-aksen, karat (carat) på y-aksen, og farv punkterne efter slibningen (cut).
ggplot(diamonds,
       aes(x=price, y=carat, color=cut)) +
  geom_point() +
  theme_bw()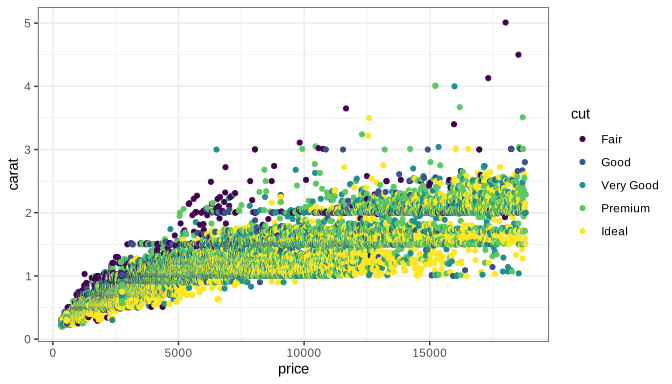
## Hvor stærk er korrelationen ifølge Pearsons metode
cor(tabell$price, tabell$carat, method="pearson")[1] 0.9215913## Hvor stærk er korrelationen ifølge Spearmans metode
cor(tabell$price, tabell$carat, method="spearman")[1] 0.9628828Visuel vurdering af relationen
Man bør altid foretage en visuel vurdering af en korrelation. Et punktdiagram er fremragende til dette, især hvis en regressionslinje kan visualiseres på grafen. Grunden til, at en visuel vurdering er vigtig, er, at selve korrelationskoefficienten ikke karakteriserer sammenhængen mellem variablerne.
Korrelationskoefficienten er altså et sammenfattende mål og skal derfor aldrig erstatte en visuel vurdering af relationen mellem og .