
Regression
Inden for al forskning og analyse er det meget almindeligt, at man indsamler information om flere variabler for at undersøge sammenhængene mellem dem. Det kan betyde, at man indsamler socioøkonomiske data (indkomst, uddannelse, etnicitet osv.), antropometriske data (vægt, højde, BMI osv.), sygehistorie (forekomst af diabetes, reumatisme, lungesygdom, kræft osv.), biomarkører (kolesterol, CRP, tumormarkører osv.) og andre måleværdier (blodtryk, alder osv.). Hvis man vil undersøge sammenhængen mellem disse variabler, er regression et kraftfuldt værktøj. Regression giver os mulighed for følgende:
- Studere relationen (associationen) mellem én afhængig variabel () og én eller flere uafhængige variabler (prædiktorer, ).
- Studere hvor stærk relationen (associationen) er mellem hver enkelt prædiktor () og den afhængige variabel ().
- Skabe en prædiktionsmodel, der kan bruges til at prædiktere, hvilket betyder, at vi på baggrund af information om kan forudsige .
I en regressionsanalyse prædikteres en variabel () af mindst én prædiktor (). Rent terminologisk siges at være afhængig af ; er derfor den afhængige variabel, og er den uafhængige variabel.
| Rolle i modellen | Synonym | |
|---|---|---|
| Y | Variablen, der skal prædikteres | Afhængig variabel, dependent variable, outcome, udfald, udfaldsmål, label, target |
| X | Bruges til at prædiktere Y | Prædiktor, predictor, feature, kovariat, covariate |
Prædiktion vs. effektestimering
Som nævnt ovenfor kan regression bruges til at studere relationen mellem variabler, studere sammenhængenes styrke og/eller udføre prædiktioner. I praksis betyder det, at vi enten studerer, hvordan en eller flere prædiktorer er associeret med udfaldsmålet, eller at vi skaber en prædiktionsmodel for at kunne forudsige en værdi eller en hændelse (). Man bør skelne mellem regressionsmodeller, der sigter mod prædiktion (dvs. at lave prædiktioner), og modeller, der sigter mod effektestimering (dvs. at studere sammenhængenes styrke og form).
Prædiktion: Forestil dig, at vi har indsamlet data om 10000 personer og fulgt dem i flere år for at studere udviklingen af kræft. For hver person har vi blandt andet indsamlet oplysninger om alder, køn, erhverv, socioøkonomi, rygning, sygdomme, lægemiddelforbrug og boligsituation. Hvis formålet er at kunne forudsige, hvilke personer der vil udvikle lungekræft, er formålet med regressionsanalysen at lave prædiktioner.
Effektestimering: Forestil dig, at vi har indsamlet data om 10000 personer og fulgt dem i flere år for at studere udviklingen af lungekræft. For hver person har vi blandt andet indsamlet oplysninger om alder, køn, erhverv, socioøkonomi, rygning, sygdomme, lægemiddelforbrug og boligsituation. Hvis vores formål er at studere relationen mellem (eksempelvis) rygning og risikoen for kræft, er formålet med regressionsanalysen at estimere effekten af en prædiktor (rygning). Da er det vigtigt, at sammenhængen mellem rygning og kræft ikke forstyrres af andre faktorer. Det kan eksempelvis være sådan, at rygere har tendens til at have lavere socioøkonomisk status, som også påvirker risikoen for kræft. Det ville derfor være ønskeligt at tage højde for (med andre ord justere for) socioøkonomisk status. Dette kan gøres ved at inkludere socioøkonomisk status som en prædiktor i modellen. Når man konstruerer regressionsmodeller til effektestimering, er det vigtigt at tage højde for confoundere (se kapitlet Kausal inferens) af denne type.
Simpel lineær regression: én afhængig variabel og én prædiktor
Dette er en kort repetition af kapitlet Lineær regression.
Den almindelige regressionsligning ser ud som følger:
- er interceptet, som er det punkt, hvor regressionslinjen skærer Y-aksen (se figuren ovenfor).
- er koefficienten for
mass, hvilket betyder, at det er værdien af regressionslinjens hældning. - er forskellen mellem modellens prædikterede værdi af og den observerede værdi af . Dette er altså modellens fejl (error).
Følgende figur viser sammenhængen mellem prædiktoren mass (kropsvægt) og udfaldet glucose (blodsukker).
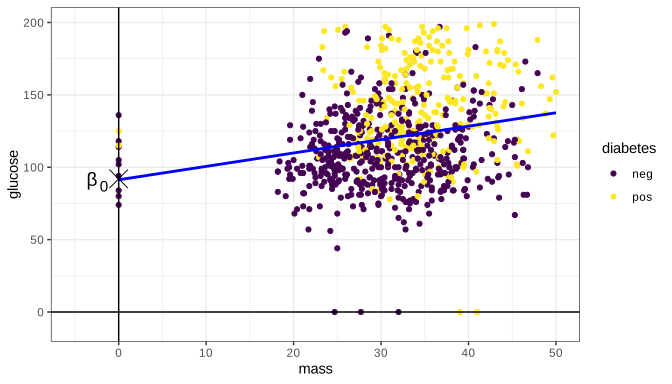
Ovenstående regressionslinje viser en positiv sammenhæng mellem og ; hvis stiger, stiger . Det visuelle indtryk af ovenstående figur er således, at kan bruges til at prædiktere . Vi kan nu omskrive ligningen for lineær regression med variablerne mass og glucose:
Hvis vi ønsker at analysere sammenhængen mellem mass og glucose justeret for alder, kræves multipel regression. Det betyder, at multipel regression bruges til at studere sammenhængen mellem mindst to prædiktorer og et udfald.
Multipel regression
<!-- video: https://science.nu/wp-content/uploads/Regressionsplan.mp4 -->
Multipel regression er en model med flere, mindst 2, prædiktorer. Den matematiske formel for multipel regression med to prædiktorer ser ud som følger:
Denne sammenhæng kan ikke længere præsenteres med en ret regressionslinje. Sammenhængen mellem og prædiktorerne og udgør nu et tredimensionelt regressionsplan, som eksemplificeres i ovenstående figur.
Statistisk signifikans: er sammenhængen mellem X og Y statistisk signifikant?
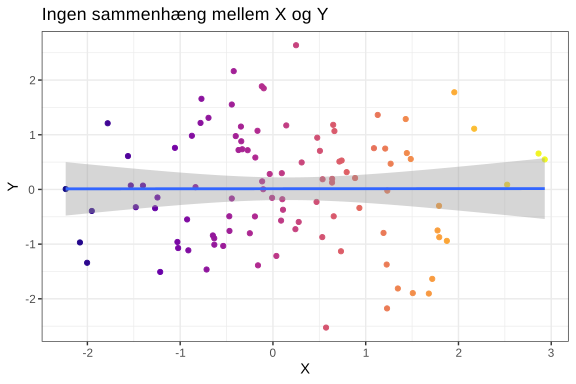
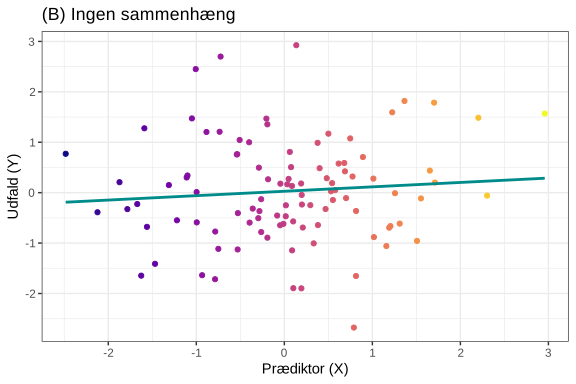
Et centralt spørgsmål er, om sammenhængen mellem og er statistisk signifikant. Dette spørgsmål kan delvist besvares ved en visuel vurdering af den grafiske sammenhæng. Visuelle vurderinger er dog subjektive, og det er desuden svært at vurdere tredimensionelle regressionsplaner (eller regressionsplaner med endnu flere dimensioner ). Der er behov for et formelt mål for, om sammenhængen mellem og er signifikant. Dette kan gøres inden for rammerne af hypotesetestning, dvs. ved at opstille en nulhypotese. I denne sammenhæng er nulhypotesen, at der ikke er nogen sammenhæng mellem og , hvilket betyder, at hældningen (koefficienten) for prædiktoren er lig med 0. Hvis hældningen er 0, er der ingen sammenhæng mellem og . En sådan sammenhæng er illustreret i nedenstående figur.
Signifikanstestning med t-test (t-statistic)
For at undersøge, om der er en statistisk signifikant sammenhæng mellem og , må vi teste nulhypotesen. Nulhypotesen er, at koefficienten for prædiktoren ikke har nogen hældning, hvilket betyder, at værdien af ikke ændres, hvis X øges eller mindskes. Opgaven bliver at beregne sandsynligheden for, at nulhypotesen er sand. Hvis denne sandsynlighed er <5 % (p<0,05), forkaster vi nulhypotesen og siger dermed, at der er en sammenhæng, dvs. er en statistisk signifikant prædiktor.
Nulhypotesen kan testes med en t-test. Den værdi, der beregnes, kaldes t-statistic, og den beregnes ved at dividere koefficienten () med dens standard error. Den aktuelle t-værdi kan derefter omsættes til en p-værdi. Alle statistikprogrammer, inklusive R, udfører disse beregninger automatisk. Det betyder, at når man laver en regressionsmodel, får man automatisk t-test og p-værdier for samtlige prædiktorer i modellen.
Herefter skal vi lave en regressionsmodel og fortolke resultaterne i detaljer.
Øvelseseksempler med multipel regression
Her følger to øvelser med multipel regression, og vægten ligger på fortolkning af resultaterne. Øvelserne gennemføres i R. Du kan kopiere koden nedenfor til R og lave de samme kørsler.
Vi vil bruge flere pakker for at lette og effektivisere arbejdet. Multipel lineær regression findes i base R (standardinstallationen af R). Funktionen hedder lm(). Derudover har vi brug for pakkerne sjPlot, broom og tidyverse til at udtrække og præsentere resultaterne. Vi vil bruge PimaIndiansDiabetes-data (fra pakken mlbench), som indeholder information om Pima-indianere, der har høj risiko for diabetes. For at installere og aktivere pakkerne samt data skrives følgende kommandoer:
install.packages(c("sjPlot", "broom", "mlbench"))
library(sjPlot)
library(broom)
library(tidyverse)

## Data om Pima-indianere
library(mlbench)
data("PimaIndiansDiabetes")

## Kopier data til et objekt med et kortere navn
pima <- PimaIndiansDiabetes

## Inspicer de første 5 rækker
head(pima, 5)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
6 148 72 35 0 33.6 0.627 50 pos
1 85 66 29 0 26.6 0.351 31 neg
8 183 64 0 0 23.3 0.672 32 pos
1 89 66 23 94 28.1 0.167 21 neg
0 137 40 35 168 43.1 2.288 33 posI næste trin laver vi en regressionsmodel. Dette gøres med funktionen lm() (linear model), som bruges, når den afhængige variabel er kontinuerlig. I dette tilfælde er den afhængige variabel (udfaldet, Y) blodsukker (glucose).
Med funktionen lm() bruges tegnet ~ til at specificere modellen. Til venstre for ~ placeres den afhængige variabel (glucose), og til højre specificeres alle prædiktorer adskilt med +. Resultatet gemmer vi i objektet my_model. Vi kører derefter objektet for at se resultatet.
my_model <- lm(glucose ~ mass + age + insulin + pressure, data=pima)
my_modelCall:
lm(formula = glucose ~ mass + age + insulin + pressure, data = pima)
Coefficients:
(Intercept) mass age insulin pressure
68.89351 0.58340 0.72475 0.08665 0.03373Ovenfor ser vi modellens specifikation under overskriften Call. Under overskriften Coefficients ser vi koefficienterne. Det var altså en temmelig sparsom præsentation af modellen. Lad os i stedet anvende funktionen summary() på objektet.
summary(my_model)Call:
lm(formula = glucose ~ mass + age + insulin + pressure, data = pima)
Residuals:
Min 1Q Median 3Q Max
-123.65 -17.78 -2.50 16.23 86.57
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 68.893507 5.491146 12.546 < 2e-16 ***
mass 0.583397 0.138432 4.214 2.81e-05 ***
age 0.724746 0.090398 8.017 4.06e-15 ***
insulin 0.086647 0.009137 9.483 < 2e-16 ***
pressure 0.033732 0.057169 0.590 0.555
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 28.52 on 763 degrees of freedom
Multiple R-squared: 0.2087, Adjusted R-squared: 0.2045
F-statistic: 50.3 on 4 and 763 DF, p-value: < 2.2e-16Dette udtrækker mere information om modellen. For hver prædiktor præsenteres nu koefficienten (Estimate), standard error (Std. Error), t statistic (t value) og p-værdi (Pr(>|t|)). Resultaterne fortolkes som følger:
- (Intercept): Vi er ikke interesserede i interceptet. Det er yderst sjældent, at interceptet er af interesse. Interceptet angiver, hvad Y-værdien (glucose) er, hvis alle X-værdier er 0, og det er ikke biologisk meningsfuldt (f.eks. er der intet menneske, der vejer 0 kilo). Interceptet rapporteres alligevel altid.
- Prædiktorerne:
- mass: Hvis mass stiger 1 enhed, stiger glucose 0,583397 enheder.
- age: Hvis age stiger 1 enhed, stiger glucose 0,724746 enheder.
- Ligeledes er de øvrige prædiktorer også positivt associeret med glucose, da alle koefficienterne er positive.
- Alle prædiktorer undtagen pressure har signifikante p-værdier (p<0,05). Det betyder, at sammenhængen mellem pressure og glucose ikke er statistisk signifikant.
- Associationen for hver prædiktor er justeret for alle andre prædiktorer. Det betyder, at hver koefficient viser, hvordan prædiktoren påvirker glucose, når de øvrige prædiktorer holdes konstante.
- R2 og Adjusted R2: R2 er modellens forklaringsevne. I dette tilfælde er R2 0,2087, hvilket betyder, at modellen forklarer 20,87 % af al variation i glucose.
Der findes yderligere funktioner og pakker, som kan udtrække og præsentere modellens resultater. Vi begynder med pakken sjPlot, som har flere nyttige funktioner til formålet. Med tab_model() præsenteres modellens resultater i en tabel:
library(sjPlot)
tab_model(my_model)| Predictor | Estimates | 95% CI | P value |
|---|---|---|---|
| (Intercept) | 68.89 | 58.11 – 79.67 | <0.001 |
| mass | 0.58 | 0.31 – 0.86 | <0.001 |
| age | 0.72 | 0.55 – 0.90 | <0.001 |
| insulin | 0.09 | 0.07 – 0.10 | <0.001 |
| pressure | 0.03 | -0.08 – 0.15 | 0.555 |
| Observations | 768 | ||
| R2 / R2 adjusted | 0.209 / 0.205 |
I resultaterne ovenfor præsenteres også et konfidensinterval, som angiver, inden for hvilket interval den sande koefficient ligger med 95 % sandsynlighed. Med 95 % sandsynlighed ligger koefficienten for mass mellem 0,31 og 0,86. Bemærk, at dette interval ikke inkluderer 0 (nul), hvilket betyder, at vi med 95 % sikkerhed kan sige, at en stigning i mass giver en stigning i glukose. Dette stemmer med p-værdien, som er <0,001. Sammenhængen mellem mass og glukose er altså statistisk signifikant. Denne effekt af mass er justeret for effekten af de øvrige prædiktorer (kovariater) i modellen.
Koefficienten for mass angiver, hvor stor en effekt 1 enheds stigning i mass har på glucose, når alle andre prædiktorer (kovariater) holdes konstante. Samme princip gælder for de øvrige prædiktorer.
Bemærk rækken Observations i tabellen. Den viser, hvor mange observationer der blev inkluderet i regressionsmodellen. Husk, at hvis en observation mangler oplysning (dvs. har "missing") for nogen af de prædiktorer, der indgår i modellen, ekskluderes denne observation fra hele modellen. Det betyder, at hvis en observation eksempelvis mangler oplysning om mass, men har værdier for alle øvrige variabler, ekskluderes denne person fra modellen, og vi mister en observation.
Med funktionen plot_model() får vi en grafisk præsentation af resultaterne. Funktionen har en lang række argumenter, som du kan bruge til at justere grafen.
plot_model(my_model, show.values = T)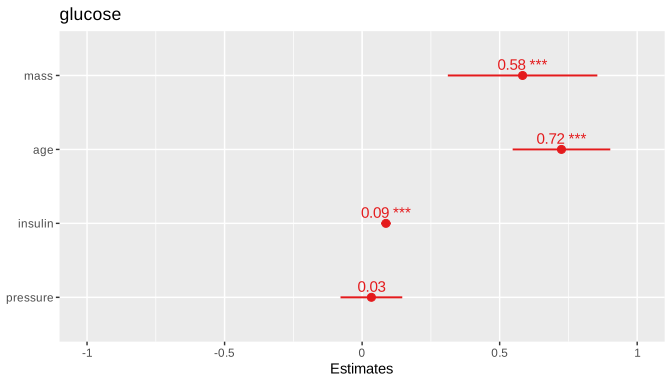
Linearitet (Linearity)
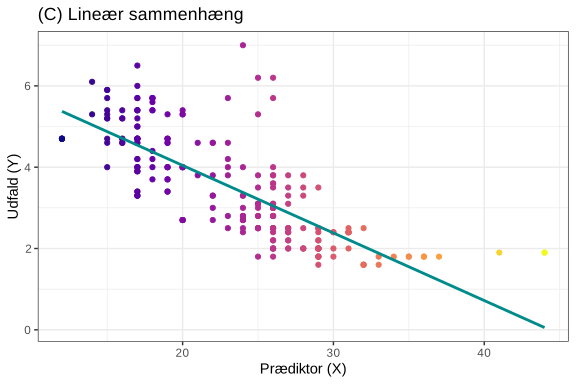
Anvendelse af lineær regression kræver, at hver prædiktor er lineært associeret med Y. Figuren nedenfor viser en lineær regressionslinje gennem (A) data med ikke-lineær sammenhæng, (B) data uden sammenhæng og (C) data med lineær sammenhæng. I tilfælde (A) formår den lineære model ikke at indfange en eksisterende sammenhæng. I tilfælde (B) er der ingen nævneværdig sammenhæng at indfange.
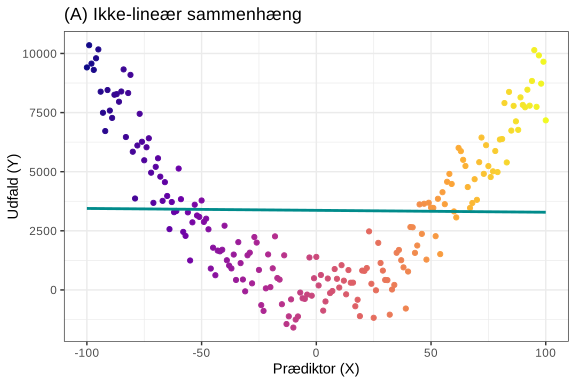
At logaritmere X hjælper ikke med at indfange sammenhængen i tilfælde (A), selvom logaritmering kan gøre ikke-lineære sammenhænge mere lineære. For at indfange sammenhængen i tilfælde (A) kræves en mere fleksibel linje. Metoder til håndtering af ikke-linearitet er blevet diskuteret i kapitlet Håndtering af kontinuerlige variabler.
Modelspecifikation: at specificere modellen korrekt
Hvis en regressionsmodel er forkert specificeret, er koefficienterne ikke pålidelige. At udelade vigtige kovariater eller interaktioner mellem variabler eller at ignorere ikke-lineære sammenhænge er almindelige årsager til, at modellen er forkert specificeret. Dette kan føre til, at effekten af en eller flere prædiktorer overvurderes, undervurderes eller fejlfortolkes. En interaktion betyder, at to (eller flere) prædiktorer interagerer med hinanden, forstået på den måde, at effekten af den ene prædiktor afhænger af den anden prædiktor.
Interaktioner
Forestil dig, at lægemiddel X bruges til at behandle hovedpine. Lægemidlet virker kun hos kvinder, fordi substansen aktiveres af et enzym, der findes i brystkirtlerne. Effekten af lægemidlet afhænger således af køn. Der er altså en interaktion mellem lægemidlets effekt og køn. Hvis man ikke tager højde for denne interaktion, fører det til en forkert model. Den forkerte model specificeres som følger.
Modellen er forkert, fordi den behandler køn og lægemiddel som to separate parametre (prædiktorer). Den korrekte model specificeres med interaktionen mellem lægemiddel og køn. Interaktionen betyder, at man multiplicerer lægemiddel med køn (rent matematisk betyder det, at kombinationen af hvert niveau af køn og hvert niveau af lægemiddel introduceres som en prædiktor):
For at afgøre, om interaktionen er signifikant, vurderer man p-værdien for interaktionsleddet. Al statistisk software (inklusive R) rapporterer p-værdi (og 95 % konfidensinterval) for interaktionsled. Hvis interaktionsleddet er signifikant (p < 0,05), er det evidens for, at der er en interaktion mellem prædiktorerne.
Multicollinearity (Multikollinearitet)
Formålet med multipel regression er at kvantificere den uafhængige effekt af hver enkelt prædiktor. Der er dog situationer, hvor en prædiktor ikke kan gøres uafhængig af en eller flere andre prædiktorer. Forestil dig, at vi undersøger, hvordan BMI (body mass indeX) påvirker blodsukkeret. Vi laver en regression, hvor blodsukker er udfaldsmål, og BMI samt alder er prædiktorer:
Lad os sige, at effekten (koefficienten) for BMI er 0,5, hvilket betyder, at for hver enhed BMI stiger, stiger blodsukkeret med 0,5 enheder. Denne effekt af BMI er uafhængig af alder, da vi har justeret for alder. Man kan også sige, at dette er effekten af BMI, når vi holder alder konstant. Hvis vi skulle introducere endnu en kovariat, nemlig vægt, kunne der opstå multicollinearity. BMI og vægt er nemlig meget stærkt relaterede (BMI er en funktion af vægt og højde), forstået på den måde, at når BMI stiger, har kropsvægten også tendens til at stige. Man kan da ikke hævde, at koefficienten for BMI repræsenterer effekten af BMI, når vægt holdes konstant, da vægt med stor sandsynlighed også stiger, når BMI stiger. Dette er et eksempel på multikollinearitet, dvs. når to eller flere prædiktorer er stærkt korrelerede med hinanden.
Denne type korrelation mellem prædiktorer forringer koefficienternes præcision. Det betyder også, at vi bruger mere information end nødvendigt. Hvis informationen i BMI også findes i vægt og omvendt, er det tilstrækkeligt, at én af disse prædiktorer inkluderes i modellen.
Risikoen for multicollinearity er høj, hvis korrelationen (se kapitlet Korrelation) mellem to prædiktorer er 0,9 eller højere. Multicollinearity kan dog også blive et problem ved lavere korrelationsgrader. Med variance inflation factor (VIF) kan man undersøge multicollinearity.
Test for multikollinearitet (multicolinearity)
Der findes flere forskellige mål til at teste multikollinearitet. Dette kan testes globalt for hele modellen og for enkelte prædiktorer i modellen. Et almindeligt mål for multikollinearitet er VIF (variance inflation factor). VIF er et mål for, hvor oppustet en prædiktors varians er som følge af multikollinearitet i modellen. Hvis VIF er større end 5, foreligger der multikollinearitet. Hvis VIF er >10, bør variablen ekskluderes fra modellen.
Vi laver nu en model med data fra Pima-indianerne. Denne gang bruger vi alle variabler i datasættet til at prædiktere blodsukker (glucose). Vi aktiverer pakken mlbench for at indlæse data med Pima-indianere.
library(mlbench)
data("PimaIndiansDiabetes")
my_model <- lm(glucose ~ ., data=PimaIndiansDiabetes)
Derefter installerer vi pakken performance og bruger funktionen check_model() til at udtrække VIF grafisk og i tabelformat:
install.packages("performance")
library(performance)

## Grafisk
check_model(my_model, check="vif")

## I tabelformat
multicollinearity(my_model)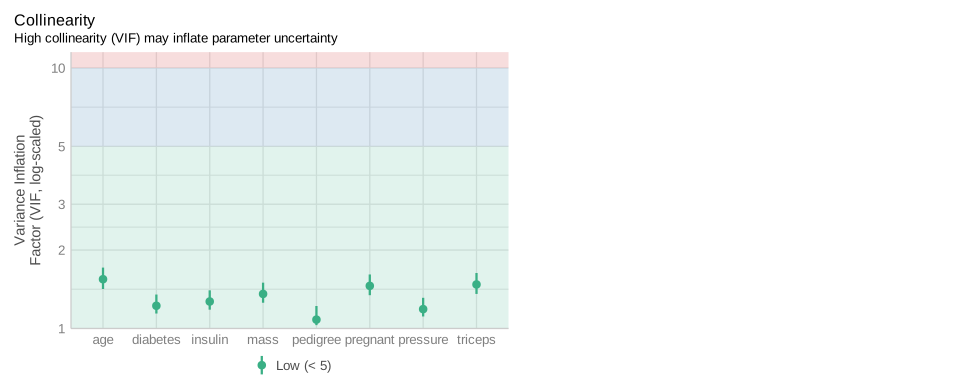
## Check for Multicollinearity

Low Correlation

     Term  VIF   VIF 95% CI Increased SE Tolerance Tolerance 95% CI
 pregnant 1.46 [1.34, 1.61]         1.21      0.69     [0.62, 0.75]
 pressure 1.19 [1.11, 1.31]         1.09      0.84     [0.76, 0.90]
  triceps 1.48 [1.36, 1.63]         1.21      0.68     [0.61, 0.74]
  insulin 1.27 [1.18, 1.40]         1.13      0.79     [0.71, 0.85]
     mass 1.36 [1.26, 1.50]         1.17      0.74     [0.67, 0.80]
 pedigree 1.08 [1.03, 1.22]         1.04      0.92     [0.82, 0.97]
      age 1.55 [1.42, 1.71]         1.24      0.65     [0.58, 0.71]
 diabetes 1.22 [1.14, 1.35]         1.11      0.82     [0.74, 0.88]
Som det fremgår ovenfor, var der ingen prædiktor med VIF >5, så kollinearitet er ikke et problem i vores model.
Kategoriske prædiktorer (factors)
Indtil nu har diskussionen udelukkende omhandlet prædiktorer, der er kontinuerlige variabler. Selvfølgelig kan man studere prædiktorer, der er kategoriske variabler, såsom køn, behandling, by, land osv. Regressionsmodeller indeholder som regel både kontinuerlige og kategoriske prædiktorer.
Lad os sige, at vi studerer, hvordan alder, vægt og fødeland påvirker blodtrykket. Modellen ser ud som følger:
Alder og vægt er kontinuerlige variabler. Fødeland (land) er derimod en kategorisk variabel med følgende kategorier: (1) Sverige, (2) Norden og (3) Europa. Når vi inkluderer land i modellen, skal en af disse kategorier bruges som referencekategori, og de øvrige kategorier sammenlignes med denne reference. Lad os nu fortolke resultaterne fra regressionsmodellen ovenfor:
| Estimate | 95% CI | P values | |
|---|---|---|---|
| (Intercept) | 83.68 | 73.47 – 90.90 | <.001 |
| BMI | 0.91 | 0.76 – 1.05 | <.001 |
| Alder | 1.14 | 1.01 – 1.30 | <.001 |
| Fødeland | |||
| Sverige | ref | ||
| Norden | 3.0 | 2.0 – 4.1 | <.001 |
| Europa | 2.1 | 1.5 – 2.7 | <.001 |
| Observations | 150 | ||
| R2 / adj. R2 | .837 / .832 |
Vi ser, at der er koefficienter (Estimate) for Norden og Europa, men for Sverige står der kun teksten "ref". Det skyldes, at kategorien Sverige er referencekategori, som Norden og Europa sammenlignes med. De effekter, der præsenteres for Norden og Europa, er altså i sammenligning med Sverige. Fortolkningen bliver da som følger:
- For hver enhed BMI stiger, stiger blodtrykket med 0,91 enheder, og dette er statistisk signifikant.
- For hvert år man bliver ældre, stiger blodtrykket med 1,14 enheder, og dette er statistisk signifikant.
- Sammenlignet med svenskere har personer født i Norden 3,0 enheder højere blodtryk. Dette er statistisk signifikant (p<0,001), og den sande værdi ligger mellem 2,0 og 4,1 enheder lavere blodtryk.
- Sammenlignet med svenskere har personer født i Europa 2,1 enheder højere blodtryk. Dette er statistisk signifikant (p<0,001), og den sande værdi ligger mellem 1,5 og 2,7 enheder lavere blodtryk.