Håndtering af prædiktorer: kategoriske, kontinuerte
Under dataindsamling og ved udvikling af prædiktionsmodeller bør man altid tilstræbe at anvende kontinuerte variabler. En kontinuert variabel indeholder altid mere information (uanset model) end en kategorisk variabel, og det er som regel forkert at kategorisere en kontinuert variabel, hvad enten variablen er udfaldet () eller en prædiktor (). Alligevel bliver kontinuerte variabler ofte kategoriseret, uden at det er begrundet.
Der findes dog scenarier, hvor det er begrundet at kategorisere en kontinuert variabel. Antag, at vi undersøger, hvordan kropsvægt (kg) påvirker risikoen for at udvikle diabetes. Vi opstiller da en prædiktionsmodel med kropsvægt (kg) som prædiktor og diabetes (ja/nej) som udfald. Hvis kropsvægt er en kontinuert variabel (kg), vil regressionskoefficienten vise, hvor meget risikoen for diabetes stiger for hvert kg (kilogram), kropsvægten stiger. Den risikostigning, der følger af, at vægten stiger 1 kg, kan forekomme lille og muligvis endda uden klinisk relevans. Så kan det være begrundet at inddele kropsvægt i kategorier (eksempelvis i kategorierne normalvægt, overvægt, fedme). Når prædiktionsmodellen i stedet anvender denne kategoriserede prædiktor, vil "effekten" (dvs. regressionskoefficienten) være kraftigere. I dette tilfælde kan det altså være meningsfuldt at kategorisere prædiktoren. Det tjener dog udelukkende et pædagogisk formål; modellen med den kategoriserede prædiktor vil i princippet altid være dårligere end modellen med den kontinuerte prædiktor.
Prospektive studier bør så vidt muligt indsamle data som kontinuerte variabler. Så er der mulighed for at kategorisere variablerne på et senere tidspunkt.
Antagelsen om linearitet: lempelse med restricted cubic splines og polynomier
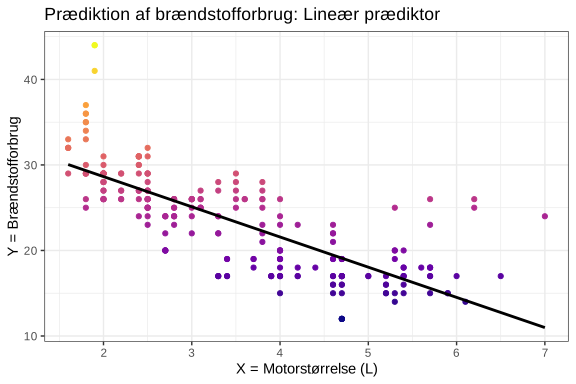
Lineære modeller, eller modeller nært beslægtet med den lineære model, dominerer de analyser, der udføres til effektestimering og prædiktion. Den lineære model bygger på antagelsen om, at der er en lineær sammenhæng mellem prædiktoren og udfaldet (se figuren nedenfor). Denne antagelse er bekvem, eftersom lineære sammenhænge er enkle at håndtere matematisk. Faktum er dog, at naturen sjældent er helt lineær, og det kan være naivt at gå ud fra, at sammenhænge er lineære. Forklaringen på, at analytikere og forskere ofte nøjes med lineære funktioner, er, at de giver en acceptabel tilnærmelse til virkeligheden. I nedenstående figur ser vi en regressionslinje (sort), som viser, hvordan prædiktoren relaterer sig til brændstofforbrug (). Af figuren fremgår det, at regressionslinjen er en acceptabel tilnærmelse til sammenhængen, men ved lave (<2) og høje værdier (>5) af ligger regressionslinjen længere fra datapunkterne (fejlen er større).
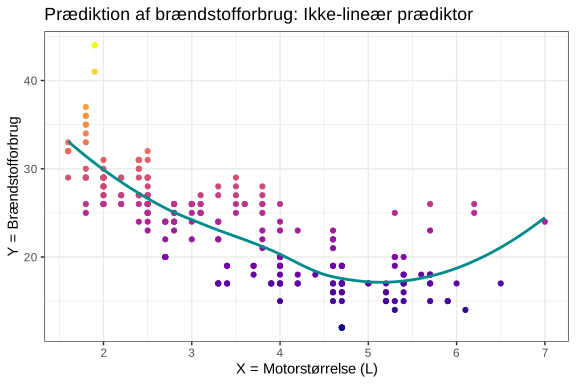
Lad os lave ovenstående model om og lade prædiktoren have en ikke-lineær sammenhæng med . Det betyder, at sammenhængen mellem og får lov at variere (være fleksibel) over 's interval. Resultatet bliver som følger:
Hvis graferne lægges oven på hinanden, bliver det tydeligere, at den ikke-lineære model har højere præcision:
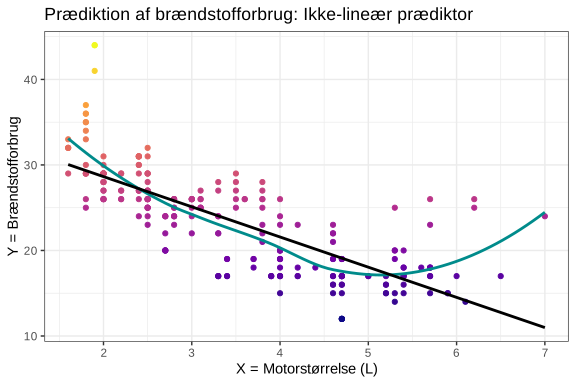
Antagelsen om linearitet bør som regel drages i tvivl. Antagelsen kan let undersøges som i eksemplet ovenfor (se kapitlet Lineær regression). Den lineære models validitet er højere, hvis prædiktorerne er korrekt specificeret.
Hvis sammenhængen mellem og ikke er lineær, kan det føre til forkerte konklusioner. I figuren nedenfor vises en kraftigt ikke-lineær sammenhæng, som fører til den forkerte konklusion, at der ikke er nogen sammenhæng mellem og , hvilket regressionslinjen viser ved, at linjen i princippet ikke har nogen hældning (β ≈ 0).
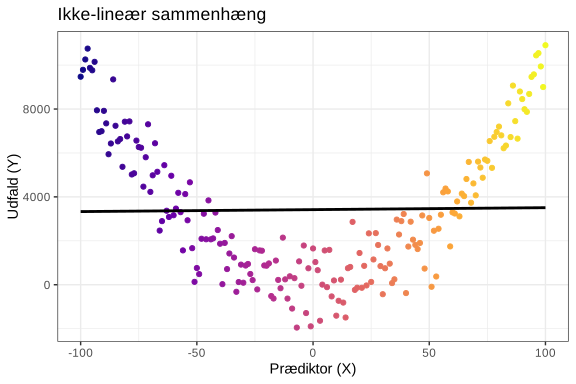
Der er brug for en mere fleksibel regressionslinje. Antagelsen om linearitet må lempes, for at regressionslinjen kan følge (prædiktere) data bedre. At transformere prædiktoren var tidligere en populær metode. Lad os logaritmetransformere prædiktoren og visualisere regressionslinjen igen:
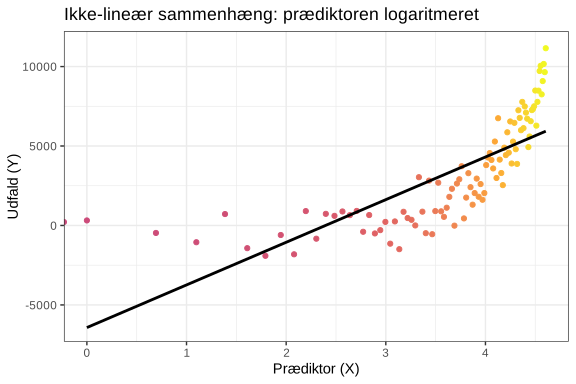
At transformere prædiktoren fører i ovenstående tilfælde til en bedre model, men den er ikke optimal (se intervallet < 2), og nu bliver koefficienten desuden sværere at fortolke (forestil dig, at vi havde logaritmetransformeret kropsvægt i kg). Det er bedre at anvende ikke-lineære funktioner af , som ikke forudsætter, at sammenhængen mellem og er lineær. Vi opstiller prædiktionsmodellen igen med en ikke-lineær funktion, uden at logaritmetransformere , hvilket giver følgende resultat:
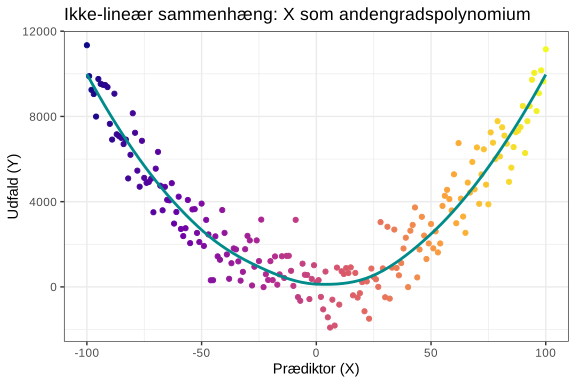
I ovenstående figur er modelleret med et andengradspolynomium, hvilket betyder, at er ganget med . Dette er den enkleste måde at lempe antagelsen om linearitet på, og det betyder, at man anvender et polynomium (eng. polynomial), dvs. heltalspotenser af prædiktoren . Der findes følgende polynomier:
- Andengradspolynomium:
- Tredjegradspolynomium:
- Fjerdegradspolynomium:
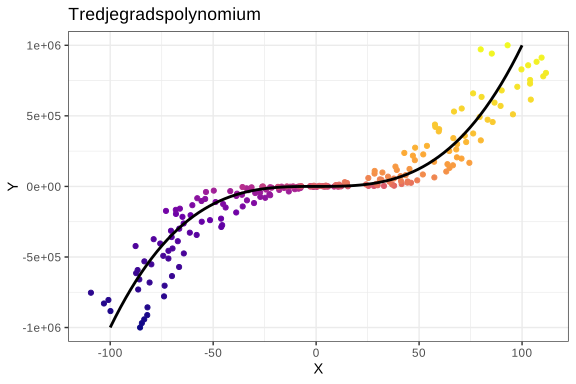
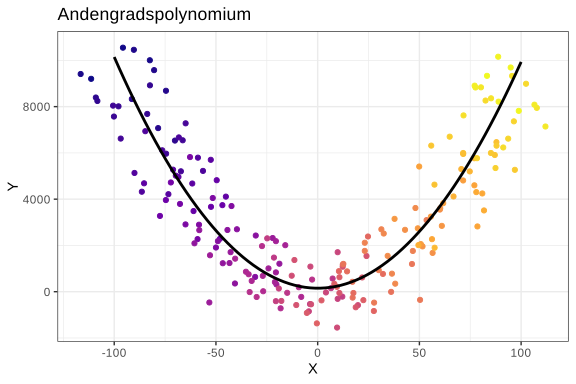
Hvis man ønsker at inkludere polynomier i en regression, skal alle lavere grader af prædiktoren også inkluderes. Det betyder, at hvis et tredjegradspolynomium () for alder skal inkluderes i modellen, skal og også inkluderes som selvstændige prædiktorer. En ofte anvendt, og lige så ofte kritiseret, metode til at inkludere polynomier i modeller er at teste polynomierne og beholde dem, hvis koefficienterne er statistisk signifikante (P < 0,05), eftersom dette er bevis for, at der findes en ikke-lineær funktion i data. Syntaksen for en lineær model med et tredjegradspolynomium for prædiktoren x er som følger:
lm(y ~ x + poly(x, 2) + poly(x, 3), data=data)Faktum er, at R altid inkluderer lavere grader af et polynomium, selv om man ikke specificerer det. Det betyder, at ovenstående model er ækvivalent med følgende:
lm(y ~ poly(x, 3), data=data)Lad os opstille en lineær regression med et tredjegradspolynomium i mpg data. Vi bruger pakken broom til at udtrække resultater fra modellen.
library(tidyverse)
data(mpg)

my_fit <- lm(hwy ~ drv + cyl + poly(displ, 3), data=mpg)

library(broom)
tidy(my_fit)| term | estimate | std.error | statistic | p.value |
|---|---|---|---|---|
| (Intercept) | 24.8304756 | 2.1392664 | 11.607005 | 0.000000 |
| drvf | 4.4553554 | 0.5050549 | 8.821528 | 0.000000 |
| drvr | 4.1892200 | 0.6871610 | 6.096417 | 0.000000 |
| cyl | -0.6548109 | 0.3682590 | -1.778126 | 0.0767217 |
| poly(displ, 3)1 | -41.8215567 | 9.8728249 | -4.236027 | 0.000033 |
| poly(displ, 3)2 | 17.0200984 | 3.2063213 | 5.308295 | 0.000000 |
| poly(displ, 3)3 | 2.0802160 | 3.0357794 | 0.685233 | 0.493896 |
Som det fremgår ovenfor, er tredjegradspolynomiet ("poly(displ, 3)3") ikke statistisk signifikant (p=0,493896), men andengradspolynomiet er derimod statistisk signifikant (p=0,000000), ligesom den lineære prædiktor (p=0,000033). Polynomier har dog flere svagheder, som kan føre til utilfredsstillende prædiktioner. Splines foretrækkes ofte frem for polynomier.
Regression splines: lineære splines, cubic splines, restricted cubic splines
En spline er en fleksibel funktion, som består af flere polynomier. Hvert polynomium repræsenterer et interval af fordelingen for prædiktoren , og alle polynomier er forbundet i enderne.
Den enkleste spline-funktion er den lineære. En simpel lineær spline betyder ganske enkelt, at prædiktoren er inddelt i intervaller, hvilket fører til, at reelt opdeles i flere prædiktorer. Selv om de enkelte intervaller er lineære funktioner, kan de tilsammen danne en ikke-lineær funktion. I figuren nedenfor er inddelt i 3 intervaller ved hjælp af to knudepunkter (eng. knots). Antallet og placeringen af disse knots kan justeres.
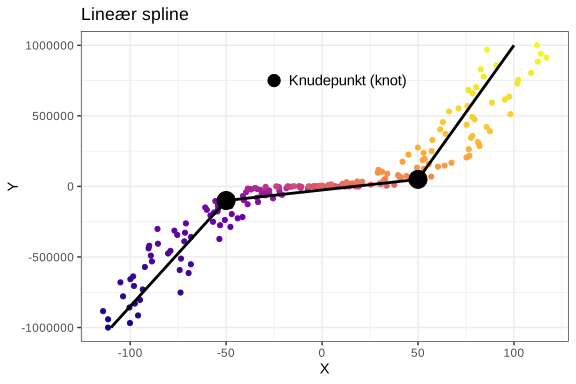
En simpel lineær spline gør det muligt at modellere ikke-lineære funktioner og kræver kun, at sammenhængen mellem og er lineær inden for hvert interval.
Ligningen for den oprindelige model (uden spline) er som følger:
Y = β0 + β1X1
Hvis prædiktoren X1 udvides til en spline med 3 intervaller, bliver ligningen:
Y = β0 + β1X1 + β2X2 + β3X3
Cubic splines (CS)
En lineær spline er oftest at foretrække frem for polynomier, men desværre er lineære splines ikke fleksible netop i knudepunkterne, og derfor bliver modellering af bøjede/krumme sammenhænge ikke optimal. For at komme uden om dette kan man anvende cubic splines, som er det samme som lineære splines, men hvor man i hvert interval anvender polynomier. Det gør, at overgangene mellem intervallerne er bløde, og cubic splines er bedre (end lineære splines) til at beskrive bøjede/krumme sammenhænge. Hvis en cubic spline har 3 knudepunkter (knots), skal der i alt estimeres 6 regressionskoefficienter (β1 til β6). Antallet af koefficienter, der skal estimeres, er nemlig k+3, hvor k er antallet af knots. Det betyder, at brugen af cubic splines bliver omkostningstung, eftersom flere parametre skal estimeres.
Restricted cubic splines (RCS, natural splines)
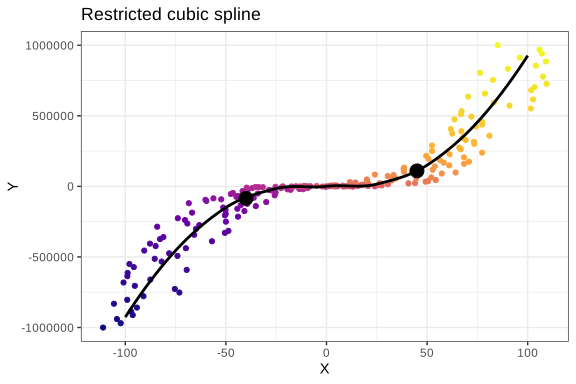
Den bedste og mest anvendte spline-funktion er restricted cubic spline. Disse spline-funktioner er som cubic splines, men funktionen tvinges til at være lineær i halerne (i begyndelsen og slutningen af prædiktorens fordeling). Det giver bedre præcision i modellen. Brugen af restricted cubic splines koster modellen k+1 parametre. Det betyder, at hvis der anvendes 3 knots, skal der estimeres 4 koefficienter.
Er der brug for splines?
Hvis en prædiktor udvides til en spline-funktion, kan man bruge P-værdien til at afgøre, om spline-funktionen er nødvendig. Nulhypotesen er, at koefficienterne (for de enkelte spline-intervaller) er lig med 0, og hvis P-værdien er < 0,05, er dette usandsynligt, og så beholder man disse splines.
Hvor mange knudepunkter (knots) er der brug for?
Hvis man kender sammenhængen mellem prædiktoren og udfaldet og ved, hvor der findes krumninger og ikke-lineariteter, kan man selv specificere, hvor knudepunkterne skal placeres. Man behøver ikke at vide, hvor ikke-linearitet findes. Det går fint at anvende splines uden viden om dette, forudsat at knudepunkterne placeres jævnt fordelt over 's interval.
I R angiver du det ønskede antal knudepunkter, og de placeres automatisk i de rette intervaller. Man anvender mindst 3 knudepunkter (selv om eksemplerne ovenfor er illustreret med to knudepunkter), og det er sjældent nødvendigt at anvende flere end 6 knudepunkter. Jo flere observationer man har, desto flere knudepunkter kan anvendes.
Restricted cubic splines kan anvendes til lineær regression, logistisk regression, Poisson-regression, Cox-regression osv.
Man bør være rundhåndet med at anvende restricted cubic splines, eftersom det er naivt at forudsætte, at sammenhænge er lineære. Man bør dog præspecificere sine splines, før modellen bygges. At foregribe dette ved at visualisere sammenhænge mellem variabler (f.eks. med korrelationsdiagrammer) anbefales ikke. Man bør være særligt rundhåndet med splines for prædiktorer, der er stærkt relateret til udfaldsmålet. Det kan oftest ikke betale sig at investere frihedsgrader i variabler med svage sammenhænge med udfaldsmålet.
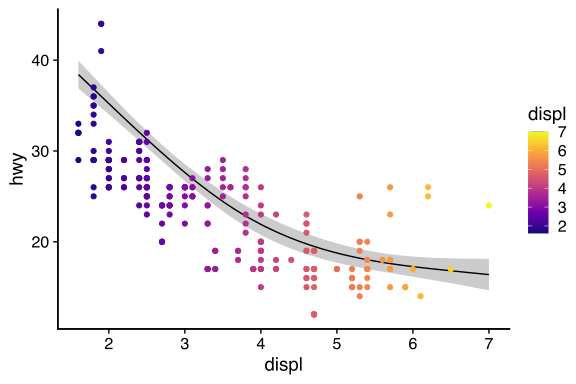
I nedenstående kode aktiverer vi pakkerne tidyverse, Hmisc og rms for derefter at indlæse mpg data. Pakken rms har funktioner til restricted cubic splines (rcs()). For at bruge rms skal vi fortælle pakken, hvilke fordelinger der findes i mpg data. Derefter indstiller vi dette i options(). Så bygger vi en model med ols() (dette er funktionen til lineær regression i pakken rms), hvor prædiktoren displ modelleres med en spline-funktion. Sammenhængen visualiseres derefter med ggplot(). Bemærk, at vi laver to grafer og placerer dem oven på hinanden med cowplot().
library(Hmisc)
library(rms)

## Fordelinger
ddist <- datadist(mpg)
options(datadist='ddist')

## Opretter modellen
model <- ols(hwy ~ rcs(displ, 3), data=mpg, x=T, y=T)

## Laver graf af spline-funktionen
p1 <- ggplot(Predict(model, "displ"), ylab="Y (hwy)") +theme_half_open()

## Laver graf med x- og y-værdier indtegnet
p2 <- ggplot(mpg, aes(x=displ, y=hwy, color=displ)) + geom_point() + scale_color_viridis_c(option = "plasma") + theme_half_open()

## Placerer graferne oven på hinanden
library(cowplot)
aligned_plots <- align_plots(p1, p2, align="hv", axis="tblr")
ggdraw(aligned_plots[[1]]) + draw_plot(aligned_plots[[2]])