
Logistisk regression
Synonym: logit-regression, logit-model
Med lineær regression kan vi undersøge kontinuerte udfald (), eksempelvis kropsvægt, blodtryk, indkomst eller pris. Lineær regression bør dog ikke anvendes til at studere binære udfald, dvs. udfald med to kategorier. Eksempler på binære udfald er sådanne, der klassificeres som ja/nej, 0/1, syg/rask, god/dårlig, tilfreds/utilfreds, lidt/meget osv.
Der er flere grunde til, at lineær regression ikke bør anvendes til at studere hverken binære udfald eller kategoriske udfald med mere end 2 kategorier. Den første grund er konceptuel og kan demonstreres med et kategorisk udfald med tre niveauer. Lad os antage, at vi studerer sammenhængen mellem prædiktoren og en diagnose , som kan have en af følgende kategorier: apopleksi, epilepsi eller Parkinsons sygdom. For at anvende lineær regression koder vi disse diagnoser med tallene 1 til 3. Vi definerer vores udfald som følger:
Der er flere problemer ved at definere udfaldet på denne måde. Først og fremmest hævder det, at der findes en iboende rækkefølge mellem diagnoserne, hvilket der ikke gør i dette tilfælde. Desuden indebærer det, at vi hævder, at forskellen mellem apopleksi og epilepsi (numerisk forskel på 1) er lige så stor som forskellen mellem epilepsi og Parkinsons sygdom (numerisk forskel på 1), hvilket er en irrationel sammenligning.
Hvis formålet med regressionsmodellen er at studere, hvordan forskellige prædiktorer () relaterer sig til risikoen for disse diagnoser (Y), fører den lineære model til urimelige resultater. For at illustrere dette laver vi en lineær regression med data fra PimaIndiansDiabetes, som findes i pakken mlbench. Pakken kan installeres med kommandoen install.packages("mlbench"). I PimaIndiansDiabetes er variablen diabetes kodet som neg (negative) eller pos (positive), hvilket vi omkoder til henholdsvis 0 og 1 for at kunne lave lineær regression. I netop dette tilfælde laver vi den lineære regression direkte i ggplot() (normalt anvendes funktionen lm()). Med ggplot() tegner vi et punktdiagram med glucose på x-aksen og diabetes på y-aksen, og derefter bruger vi geom_smooth() til at lave en lineær regression i data.
library(mlbench)
data("PimaIndiansDiabetes")

## Omkoder diabetes til 0 / 1
PimaIndiansDiabetes$diabetes <- ifelse(PimaIndiansDiabetes$diabetes=='pos', 1, 0)

## Lineær regressionsmodel
PimaIndiansDiabetes %>%
  ggplot(aes(glucose, diabetes)) +
  geom_point(alpha = 0.5, size=3) +
  geom_smooth(method = "lm") +
  labs(title = "Linjär regression med binärt utfall",
       x = "Glucose",
       y = "Sannolikhet för diabetes")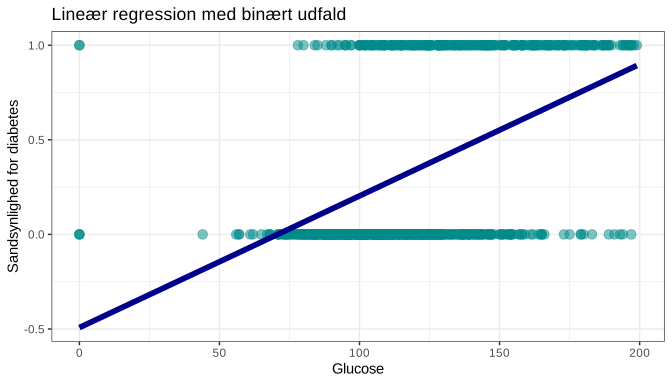
Ovenstående graf er problematisk. Først og fremmest prædikterer modellen negative sandsynligheder ved glucose <75. En sandsynlighed kan aldrig være negativ. Desuden ville modellen prædiktere en sandsynlighed >1 ved høje værdier (>200) af glucose. En sandsynlighed kan aldrig overstige 1,0. Det er således tydeligt, at lineær regression er uegnet til kategoriske udfald.
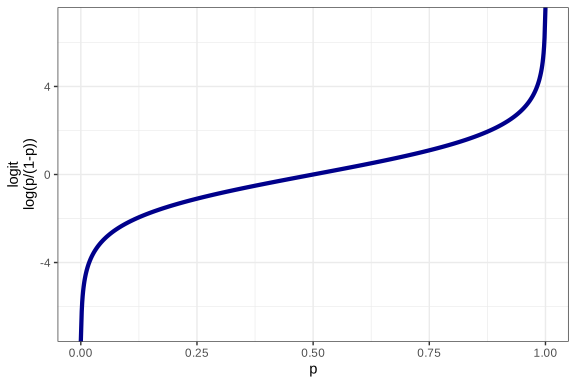
Den matematiske løsning på ovenstående problem er at lave en regressionsmodel, der altid giver en prædiktion mellem 0 og 1, uanset værdien af prædiktoren . For at gøre dette skal udfaldet håndteres som en sandsynlighed (, probabilitet), som altid ligger mellem 0 og 1. Dette kan opnås med funktionen logit eller log odds :
I ovenstående formel er ækvivalent med odds for udfaldet. For at forstå den videre diskussion er begrebet odds vigtigt.
Odds
Odds er centralt for logistisk regression. I en logistisk regression er udfaldet binært (0/1). Vi kan betragte dette som en situation, hvor en hændelse kan udeblive (0) eller indtræffe (1). Den logistiske model beregner odds for, at hændelsen indtræffer. Odds er sandsynligheden for, at noget indtræffer, divideret med sandsynligheden for, at det ikke indtræffer. Nedenfor vises odds for et udfald defineret som ja/nej, hvor er sandsynligheden.
Dette er ækvivalent med:
Eksempel 1: Hvad er odds for at slå et lige tal (2, 4 eller 6) ved et kast med en terning?
Svar: En terning har seks tal (1, 2, 3, 4, 5, 6). Sandsynligheden for at slå 2, 4 eller 6 er 3/6. Sandsynligheden for ikke at slå 2, 4 eller 6 er også 3/6. Odds beregnes som følger:
Odds på 1,0 betyder, at der er lige stor chance for, at udfaldet indtræffer, som for at udfaldet ikke indtræffer.
Eksempel 2: Hvad er odds for at slå et af tallene 1, 2, 3 eller 4 ved et kast med en terning?
Svar: Sandsynligheden for at slå 1, 2, 3 eller 4 er 4/6, og sandsynligheden for et andet resultat er 2/6. Odds beregnes som:
Odds er således 2,0, hvilket betyder, at sandsynligheden for, at hændelsen indtræffer, er dobbelt så høj som sandsynligheden for, at den ikke indtræffer.
Vi vender nu tilbage til diskussionen om logit.
I nedenstående figur visualiseres mod logit (log odds). Figuren viser, at sandsynligheder kan oversættes til en hvilken som helst odds ved hjælp af logit.
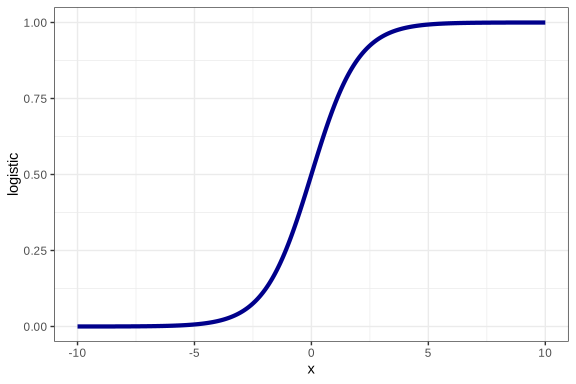
Vi kan beregne sandsynligheder ud fra log odds ved hjælp af den logistiske funktion (logistic function):
Denne formels funktion kan visualiseres som vist i nedenstående figur. Bemærk, at sandsynligheden (y-aksen) ligger mellem 0 og 1, uanset værdien af prædiktoren .
Ved at anvende logit til at transformere sandsynligheden får vi en værdi, der kan prædikteres med en lineær ligning, som følger:
Logit-funktionen gør det altså muligt at forbinde med . Logit kan derfor betragtes som en linkfunktion (link function). I logistisk regression er logaritmen af odds altså en lineær funktion af prædiktorerne.
Hvis denne funktion anvendes på de samme data som ovenfor (prædiktion af diabetes), får regressionsmodellen følgende funktion:
PimaIndiansDiabetes %>%
  ggplot(aes(glucose, diabetes)) +
  geom_point(alpha = 0.5) +
  geom_smooth(method = "glm", method.args = list(family = "binomial")) +
  labs(title = "Logistisk regression med binärt utfall",
       x = "Glucose",
       y = "Sannolikhet för diabetes")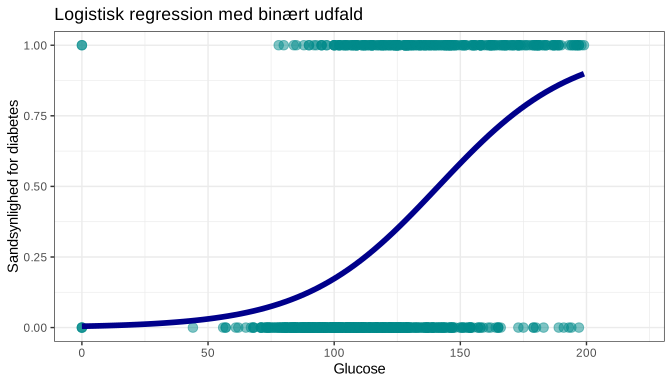
Denne model vil altid give sandsynligheder mellem 0 og 1.
Fortolkning af logistisk regression
Regressionskoefficienten () repræsenterer, hvordan logaritmen af odds for hændelsen ændres, når prædiktoren øges med 1 enhed. Dette minder om lineær regression, hvor repræsenterer, hvordan ændres, når prædiktoren øges med 1 enhed. Ved logistisk regression er det altså logaritmen af odds for hændelsen, der ændres.
Odds ratio (oddsratio)
Sandsynlighed (probabilitet) er et svært begreb at forstå. At fortolke logaritmerede sandsynligheder er endnu sværere. Derfor transformerer vi regressionskoefficienten ved at eksponentiere den og dermed danne en oddsratio (odds ratio, OR). Odds ratio er betydeligt lettere at fortolke. Eksempel følger:
- For prædiktoren får vi en regressionskoefficient på 0,5, hvilket betyder, at når prædiktoren øges med 1 enhed, øges logaritmen af odds for, at hændelsen indtræffer, med 0,5.
- Vi eksponentierer koefficienten:
- Det betyder, at når prædiktoren øges med 1 enhed, øges odds for hændelsen med 65 %.
Man kan altså omregne en odds ratio til procent! Dette gøres med formlen: .
Eksempel 1: Odds ratio = 1,10. Beregning: 100•(1,10 – 1) = 10 %. Fortolkning: For hver enhed, prædiktoren X øges, øges odds for hændelsen med 10 %.
Eksempel 2: Odds ratio = 0,90. Beregning: 100•(0,9 – 1) = –10 %. Fortolkning: For hver enhed, prædiktoren X øges, mindskes odds for hændelsen med 10 %.
En odds ratio (oddsratio) på 1,0 betyder, at prædiktoren ikke har en sammenhæng med , eftersom en stigning/et fald i ikke påvirker odds for hændelsen . Hvis odds ratio er større end 1,0, øges odds for hændelsen, og hvis odds ratio er mindre end 1,0, mindskes odds for hændelsen. En odds ratio på 1,50 betyder 50 % øget odds, og en odds ratio på 0,5 betyder 50 % mindsket odds.
Når man bruger odds ratio, er den procentvise ændring i odds den samme, hver gang prædiktoren øges med 1 enhed. Det skyldes, at den logistiske regression forudsætter, at forholdet mellem og log(odds) er lineært.
Eksempel på logistisk regression
Vi laver en logistisk regression med data fra PimaIndiansDiabetes, som findes i pakken mlbench. Installér pakken med kommandoen install.packages("mlbench"). I data er variablen diabetes kodet som pos (positive) eller neg (negative). Den logistiske regression laves ved hjælp af funktionen glm(), som findes i grundinstallationen af R. GLM står for generalized linear model, som estimerer lineære modeller ved hjælp af en linkfunktion (link function). I logistisk regression er log odds (logit) linkfunktionen. Modellen specificeres som følger:
diabetes="pos" ~ glucose + agebetyder, at det er kategorien "pos", vi vil prædiktere ved hjælp af variablerne glucose og age.family = binomial(link = logit)angiver, hvilken linkfunktion GLM skal anvende.
library(mlbench)
data("PimaIndiansDiabetes")

min_modell <- glm(diabetes=="pos" ~ glucose + age,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)
Resultatet af modellen med base R-funktionen summary():
summary(min_modell)Call:
glm(formula = diabetes == "pos" ~ glucose + age, family = binomial(link = logit),
data = PimaIndiansDiabetes)
Deviance Residuals:
Min 1Q Median 3Q Max
-2.3367 -0.7775 -0.5087 0.8367 3.1630
Coefficients:
Estimate Std. Error z value Pr(>|z|)
(Intercept) -5.912449 0.462620 -12.78 < 0.0000000000000002 ***
glucose 0.035644 0.003290 10.83 < 0.0000000000000002 ***
age 0.024778 0.007374 3.36 0.000778 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
(Dispersion parameter for binomial family taken to be 1)
Null deviance: 993.48 on 767 degrees of freedom
Residual deviance: 797.36 on 765 degrees of freedom
AIC: 803.36
Number of Fisher Scoring iterations: 4Under overskriften Coefficients præsenteres regressionskoefficienterne. Begge koefficienter (se Estimate for glucose og age) er positive (>0). Desuden er p-værdierne <0,005, hvilket betyder, at koefficienterne er statistisk signifikante.
I en videnskabelig publikation er man oftest interesseret i at præsentere odds ratio (OR) med 95 % konfidensinterval. For at gøre dette bruger vi funktionen tidy fra pakken broom. Husk, at koefficienten er log odds for Y, hvilket betyder, at koefficienten skal eksponentieres for at få odds ratio. Med kommandoen nedenfor beder vi om både eksponentiering og 95 % konfidensinterval:
library(broom)
tidy(min_modell, exponentiate=T, conf.int=T)
## A tibble: 3 × 7
term estimate std.error statistic p.value conf.low conf.high
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 0.00271 0.463 -12.8 2.11e-37 0.00106 0.00653
2 glucose 1.04 0.00329 10.8 2.37e-27 1.03 1.04
3 age 1.03 0.00737 3.36 7.78e- 4 1.01 1.04Resultatet ovenfor fortolkes som følger:
- Estimate er odds ratio for hændelsen Y.
- Når glucose øges med 1 enhed, øges risikoen for diabetes med 4 %.
- Når age øges med 1 enhed, øges risikoen for diabetes med 3 %.
- conf.low og conf.high angiver et 95 % konfidensinterval. Med 95 % sikkerhed ligger odds ratio mellem 1,03 og 1,04 for glucose, hvilket betyder, at 1 enheds stigning i glucose med 95 % sikkerhed giver 3 % til 4 % højere sandsynlighed for diabetes.
Modeldiagnostik kan fås effektivt med funktionen check_model() fra pakken easystats:
library(easystats)
check_model(min_modell)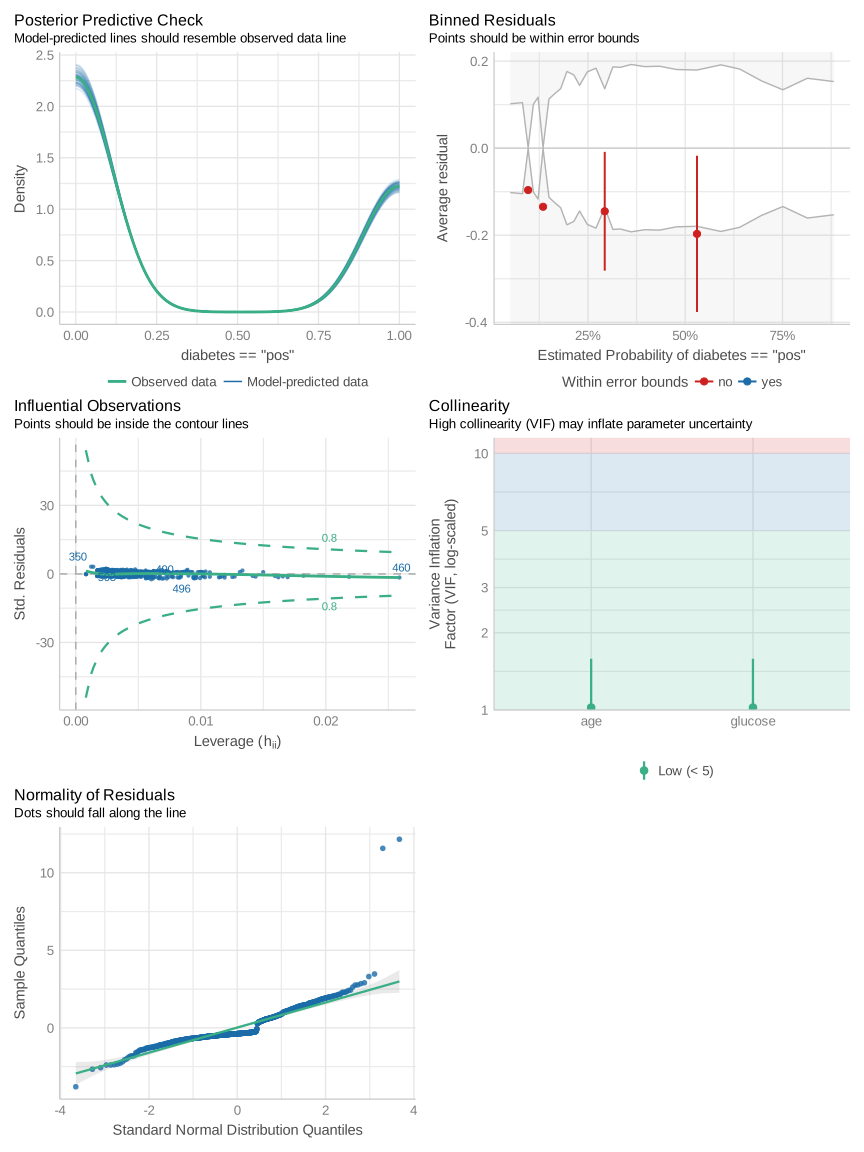
Prædiktion med logistisk regression
Vi kan lave prædiktioner med regressionsmodellen ved hjælp af funktionen predict(). Her følger to eksempler, hvor vi prædikterer for en enkelt person ved at lave en ny dataframe med personens værdier for glucose og age:
## Definer en ny observation og kald objektet "new_patient"
new_patient = data.frame(age=50,
                         glucose=150)

## Prædikter sandsynligheden for diabetes
predict(min_modell, newdata=new_patient, type="response")0.00422564Ovenstående tal er sandsynligheden () for, at personen har diabetes.
ROC-kurve for modellen
Evaluering af modellens prædiktive evne foretages som regel ved hjælp af en ROC-kurve. Nedenfor laver vi tre varianter af modellen og sammenligner dem ved hjælp af ROC. Bemærk dog, at en sammenligning af forskellige modeller helst bør foretages med en form for resampling, for eksempel krydsvalidering (se kapitlet Evaluere og sammenligne modeller).
## En model med glucose og age
min_modell_1 <- glm(diabetes=="pos" ~ glucose + age,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)

## En model med glucose, age, insulin og pressure
min_modell_2 <- glm(diabetes=="pos" ~ glucose + age + insulin + pressure,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)

## En model med samtlige tilgængelige prædiktorer i data
## Punktum (.) er en genvej til "samtlige prædiktorer"
min_modell_3 <- glm(diabetes=="pos" ~ .,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)

library(easystats)
plot(performance_roc(min_modell_1, min_modell_2, min_modell_3))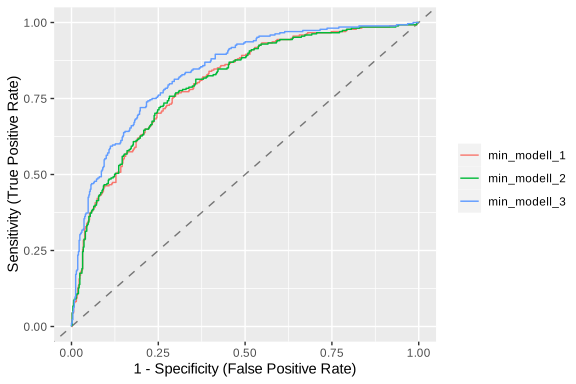
Multipel logistisk regression
Som det fremgår af eksemplerne ovenfor, kan man inkludere flere prædiktorer i den logistiske model, og den accepterer både kategoriske og kontinuerte prædiktorer. Hvis modellen omfatter flere prædiktorer, fortolkes koefficienten for hver enkelt prædiktor som dennes "effekt", når de øvrige prædiktorer holdes konstante. "Effekten" af prædiktoren er således den, der observeres, når der justeres for de øvrige prædiktorer i modellen.
Maximum Likelihood Estimation (MLE): Beregning af regressionskoefficienter i logistisk regression
Husk, at den lineære model har en enkel formel til at finde modellens parametre (intercept og regressionskoefficienter). Ligningen er den regressionslinje, der bedst beskriver data. Dette gøres ved at minimere summen af alle fejl (errors) (se Lineær regression). For logistisk regression findes der ingen enkel ligning at løse. I stedet skal softwaren finde parametrene ved hjælp af optimeringsfunktioner (optimizer functions). Den mest anvendte metode til dette er MLE (maximum likelihood estimation).
Maximum likelihood estimation (MLE, maksimum likelihood-metoden) anvendes generelt til at beregne parametrene i en sandsynlighedsfordeling. Metoden vælger de parametre, der maksimerer sandsynligheden for at opnå de observerede udfald. Metoden kræver, at der anvendes en sandsynlighedsfordeling for , hvilket i tilfældet med logistisk regression er Bernoulli-fordelingen. Givet denne fordeling kan en likelihood-funktion beregnes for de observerede data. Funktionen kan derefter optimeres for at finde de parametre, der bedst beskriver data. Den præcise beregning af disse parametre ligger uden for rammerne af dette kursus.