
Overlevelsesanalyse (survival analysis): fra Kaplan-Meier til Cox-regression
En revideret version af dette kapitel findes her:
Overlevelsesanalyse er et kraftfuldt værktøj til at studere hændelser (events). Centralt for overlevelsesanalyse er information om observationstid. Man studerer nemlig altid tiden, indtil en hændelse indtræffer. I engelsksproget litteratur anvendes betegnelserne survival analysis eller time-to-event analysis. Den sidstnævnte term, time-to-event analysis, er egentlig mere korrekt, fordi disse analyser kan bruges til at studere alle hændelser og ikke kun død. I dette kapitel vil vi dog bruge død som eksempel, fordi det gør det lettere at forstå.
Centralt for overlevelsesanalyse er kendskab til observationstiden, dvs. den tidsperiode, hvor individet observeres. Det behøver naturligvis ikke at være en person, der observeres; det kan lige så godt være celler, bakterier eller lignende. I sin reneste form starter observationstiden, når individet inkluderes i studiet, og observationstiden slutter, når hændelsen indtræffer, eller når studiets opfølgningsperiode er slut. Den tidsperiode, hvor individet observeres, kaldes survival time.
Formålet med overlevelsesanalyse er følgende:
- At studere overlevelsesprocessen.
- At studere, hvordan forskellige prædiktorer påvirker overlevelsen.
For at studere overlevelsesprocessen kan man anvende deskriptive metoder, hvoraf den vigtigste er Kaplan-Meier-estimatoren (Kaplan-Meier-kurven). Med Kaplan-Meier-metoden får man en grafisk (og matematisk) beskrivelse af overlevelsen. Med metoden kan man også sammenligne overlevelsen mellem to eller flere grupper. Med Kaplan-Meier-estimatoren kan man dog ikke foretage dybdegående analyser af forskellige prædiktorers indflydelse på overlevelsen.
For at studere, hvordan forskellige prædiktorer påvirker overlevelsen, kræves regressionsanalyse. I dag domineres overlevelsesanalyse af Cox-regression (Cox Proportional Hazards Model), som gør det muligt at sammenligne overlevelsen mellem to eller flere grupper samt at studere, hvordan forskellige prædiktorer påvirker overlevelsen. Cox-regression er et overordentlig kraftfuldt værktøj, og der publiceres dagligt tusindvis af artikler, hvor Cox-regressionen udgør studiets hjørnesten.
Kaplan-Meier-estimatoren og Cox-regression er de vigtigste værktøjer at beherske, og derfor fokuserer den videre diskussion på disse to.
Overlevelsesanalyse vs. logistisk regression
Med overlevelsesanalyse studeres altså dikotome (binære) hændelser (events). Man studerer, om en hændelse indtræffer eller udebliver. I den henseende har overlevelsesanalyse ligheder med logistisk regression (se Logistisk regression). Faktisk bruges logistisk regression også til at studere dikotome hændelser. Der publiceres dagligt hundredvis af artikler, hvor logistisk regression er blevet brugt til at studere sammenhænge mellem diverse prædiktorer og død og andre events. Logistisk regression er dog (i princippet) altid et dårligere valg end overlevelsesanalyse til at studere survival, og det skyldes, at logistisk regression ikke kan tage højde for observationstiden. Selve observationstiden er nøglen til overlevelsesanalysen (det er faktisk survival time-fordelingen, der studeres ved overlevelsesanalyse), og den kan ikke inkorporeres i en logistisk regression. Lad os illustrere dette med et (ekstremt) eksempel:
Du studerer effekten af et lægemiddel, som blev givet til 50 af 100 patienter med lungekræft i løbet af 2013. Disse patienter blev fulgt op i 2014, og da var samtlige patienter døde. Der dør altså lige mange blandt dem, der fik, og dem, der ikke fik lægemidlet. Du gennemfører en logistisk regression, hvor overlevelsen undersøges (som et dikotomt udfald) i 2014. Fordi alle patienter er døde, vil den logistiske regression indikere, at lægemidlet er virkningsløst, eftersom antallet af døde i 2014 var lige stort i begge grupper. Lad os sige, at medianoverlevelsen i gruppen, der ikke fik lægemidlet, var 1 måned, og at gruppen, der fik lægemidlet, havde en medianoverlevelse på 6 måneder. Alle var ganske vist døde efter 12 måneder, men det ser alligevel ud til, at lægemidlet forlængede livet. Med en korrekt overlevelsesanalyse ville vi kunne bekræfte, at lægemidlet er effektivt, og det skyldes, at overlevelsesanalysen kan inkorporere selve overlevelsestiden (survival time)!
Med overlevelsesanalyse (og i særdeleshed Cox-regression) har man altså større chance for at finde forskelle i overlevelse. Man bør altid foretrække overlevelsesanalyse (især Cox-regression) frem for logistisk regression, hvis man har oplysninger om survival time. (Det kan dog nævnes, at logistisk regression under særlige omstændigheder kan være ækvivalent med Cox-regression, men det diskuteres ikke i dette kapitel).
Event (outcome, udfaldsmål, hændelsen) i overlevelsesanalyse
Udfaldet i en overlevelsesanalyse er en hændelse (engelsk: event). Hændelsen kan være død, apopleksi, kræftdiagnose eller blødere events såsom opstart af et lægemiddel eller udskrivelse fra hospitalet. Man kan altså studere alle typer hændelser med overlevelsesanalyse. Det omfatter også levetiden for en computer. Selve hændelsens natur er altså af underordnet betydning, men det er undersøgerens ansvar at definere en tydelig og meningsfuld hændelse. Alle personer, der indgår i populationen, skal følges fra det tidspunkt, hvor de inkluderes i studiet, indtil opfølgningen er slut. Det er vigtigt at kunne datere tidspunktet for hændelsen (med så høj præcision som muligt), så observationstiden kan beregnes med høj opløsning. Det er altså meget bedre at registrere survival time i antal dage i stedet for antal måneder. Jo grovere mål for survival time, desto dårligere præcision i analysen.
Prædiktorer, kovariater & uafhængige variabler
Når overlevelsesanalyse bruges til at studere, hvordan forskellige variabler påvirker udfaldet, sker det sædvanligvis med Cox-regression (Cox proportional hazards model). De variabler, der studeres, kaldes prædiktorer, kovariater eller uafhængige variabler. Alle tre betegnelser kan bruges, og de henviser altså til det samme.
Censoring (censurering)
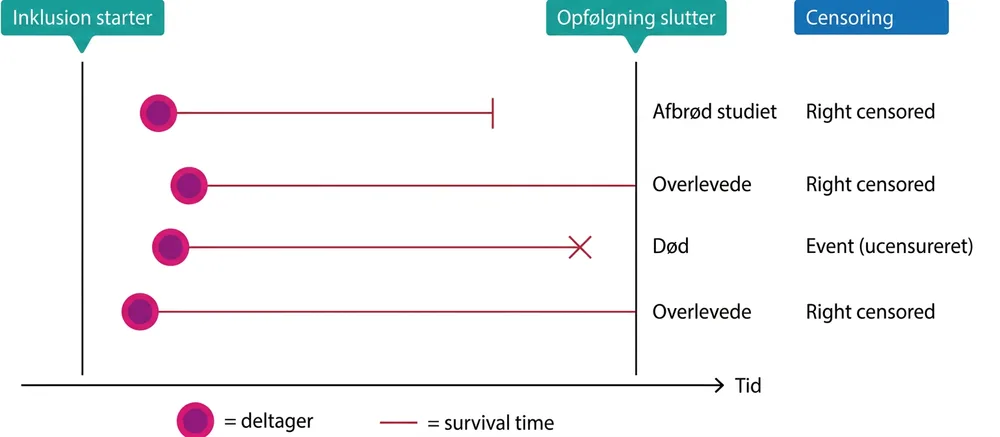
Overlevelsestid (survival time) er en kontinuert variabel, og det kan derfor være fristende at bruge lineær regression til at studere overlevelse. Det er dog ikke muligt at bruge lineær regression, og det skyldes censurering (eng: censoring). Som regel vil ikke alle personer opleve den hændelse, der studeres; det er eksempelvis sjældent, at alle personer i studiet dør. De personer, der overlever hele observationstiden, udgør altså et problem, fordi vi ikke kan sige, om eller hvornår de vil dø. Disse personer bliver censurerede (eng: censored), når studiets opfølgning slutter. Det samme problem opstår, hvis studiedeltagere udgår af studiet (fx på grund af bivirkninger af lægemidler, eller fordi de flytter til udlandet etc). Disse personer bliver også censurerede (fordi vi ikke kan sige, om eller hvornår de vil dø). Censoring indebærer altså, at opfølgningen slutter, før hændelsen er indtruffet. Man skelner mellem tre typer censoring:
- Hvis en person gennemfører studiet, uden at hændelsen indtræffer, bliver personen right censored. Det betyder, at vi kun kan udtale os om patientens skæbne frem til det øjeblik, hvor opfølgningen slutter. Personer, der udgår af studiet (uanset årsag), bliver også right censored.
- Vi er ofte interesserede i en bestemt eksponering; et studie kan eksempelvis undersøge, hvordan diabetes påvirker overlevelsen. Ofte er det dog ukendt, hvornår diabetessygdommen opstod. Sygdommen kan have været til stede i mange år, før diagnosen blev stillet. Hvis det er ukendt, hvornår en eksponering startede, er individet left censored i den henseende. Left censoring indebærer altså, at det er uklart, hvornår individets risiko startede. Dette plejer dog ikke at være noget større problem.
- Hvis et individ er både left og right censored, er det interval censored.
Informativ vs. non-informativ censoring
Censoring skal være uafhængig af (1) individets kovariater (prædiktorer) og (2) hvor længe individet har klaret sig i studiet. Censoring i løbet af studiet (før opfølgningen er afsluttet) skal være tilfældig, ellers foreligger der bias i studiet. Et eksempel følger. Antag, at vi studerer effekten af blodtryksmedicin på død. Det aktuelle lægemiddel, der studeres, viser sig at medføre svære bivirkninger, i den grad at mange personer, der får lægemidlet, er tvunget til at udgå af studiet. I det tilfælde drives censoring af en kovariat (prædiktor), nemlig lægemidlet, og så opstår der bias, fordi patienterne udgår af studiet, før de når at dø. Dette fører til underestimering af antallet af dødsfald og dermed overestimering af overlevelsen. Denne type censoring kaldes informativ censoring, hvilket betyder, at censoring ikke var tilfældig.
Censoring skal altså være non-informativ, hvilket betyder, at der ikke må være nogen årsag til censoring. I eksemplet med blodtryksmedicin vil fordelingen af survival time være ens mellem grupperne, hvis censoring er non-informativ.
Survival function og hazard function
Overlevelse (survival time) er en kontinuert variabel, som kan beskrives med to enkle funktioner:
S(t), survival function (overlevelsesfunktion): S(t) er sandsynligheden for, at en person er i live efter tidspunkt t.
h(t), hazard function (hazardfunktion): h(t) angiver den øjeblikkelige risiko for, at hændelsen indtræffer ved tidspunkt t, forudsat at personen har overlevet indtil da.
Formlen og sammenhængen mellem S(t) og h(t) er som følger:
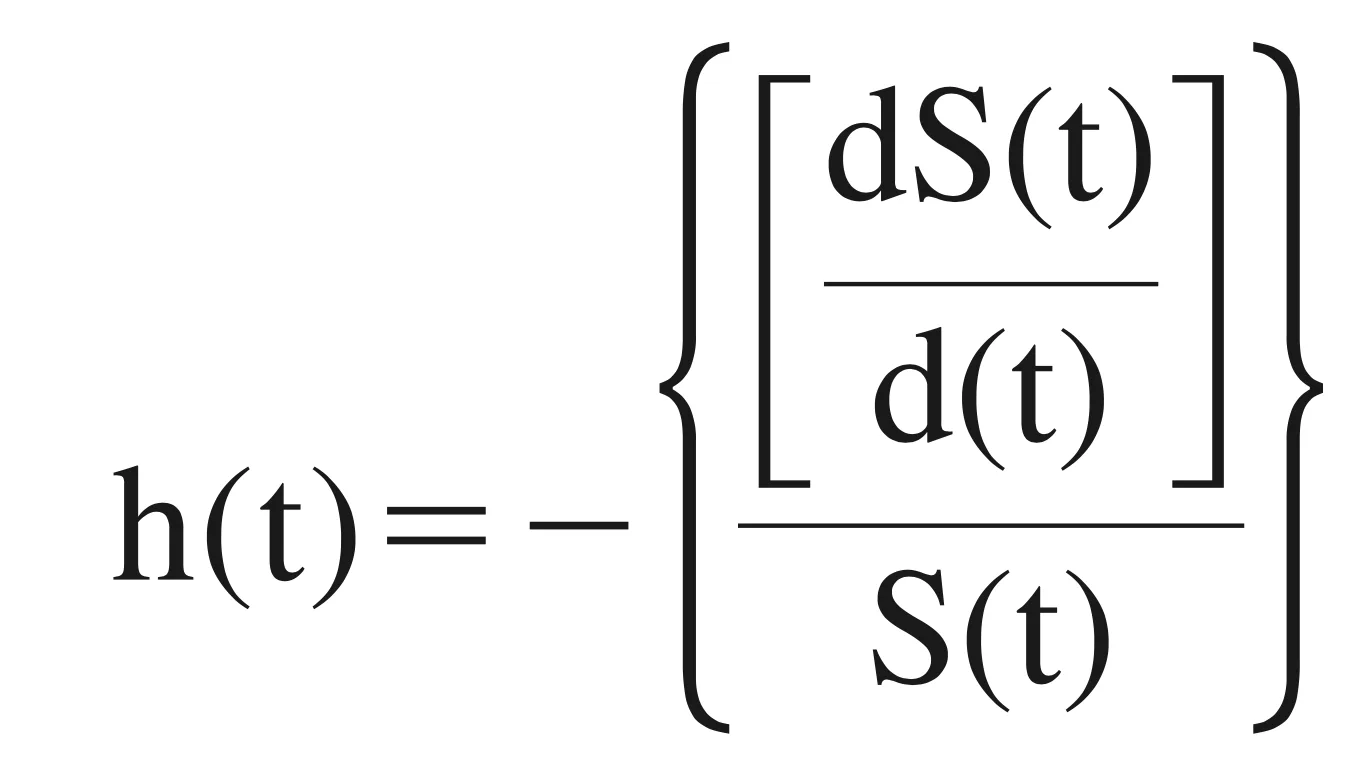
S(t) bruges til at lave deskriptiv statistik. Ved at beregne S(t) kan man blandt andet bestemme overlevelseskurver og medianoverlevelse. Medianoverlevelsen er det tidspunkt, hvor 50% af den oprindelige kohorte er i live, hvilket betyder, at S(t) = 0,5. Bemærk, at både overlevelseskurver og medianoverlevelse rapporteres i de fleste undersøgelser med overlevelsesanalyse. Hazardfunktionen derimod plejer ikke at blive præsenteret i et videnskabeligt studie. Den har ikke desto mindre fundamental betydning for overlevelsesanalyse, hvilket diskuteres senere.
S(t) og Kaplan-Meier-estimatoren (kurven)
Det er som regel altid af interesse at visualisere overlevelsen med en graf, fordi den viser, hvordan overlevelsesprocessen ser ud over tid. Om deltagerne hovedsageligt dør i begyndelsen, i midten eller i slutningen af et studie, kan let ses med en graf. Den mest almindelige metode til at præsentere S(t) er ved hjælp af Kaplan-Meier-estimatoren.
For at lave en Kaplan-Meier-kurve skal tidsskalaen (opfølgningstiden) opdeles i intervaller (Figur 2). Hvert interval begynder, når et event indtræffer. Alle tidspunkter, hvor hændelser indtræffer (event times), rangordnes fra første til sidste event. Ved t1 indtræffer den første hændelse, ved t2 indtræffer den anden hændelse, ved t3 indtræffer den tredje hændelse og så videre. Studiet begynder ved t0, og da er der endnu ikke indtruffet nogen hændelse. Ved t0 er S(t) = 1,0, hvilket betyder, at sandsynligheden for overlevelse er 100%. For at beregne S(t) ved t1 udføres følgende beregning:
(n1 - m1) / n1
n1 er antallet af patienter observeret i begyndelsen af t1.
m1 er antallet af events ved t1.
Dette er altså andelen af patienter, der overlever efter t1, blandt de patienter, der overlevede frem til t1.
For at beregne sandsynligheden for at overleve efter t2, forudsat at man klarer sig frem til da, udføres beregningen i to trin:
(n2 - m2) / n2
n2 er antallet af patienter observeret i begyndelsen af t2.
m2 er antallet af events ved t2.
Hvilket altså er andelen af patienter, der overlever efter t2, blandt dem, der overlevede frem til t2. S(t) er produktet af sandsynligheden for at overleve frem til t2, hvilket bliver:
(n1 -m1)/n1 × (n2 - m2)/n2
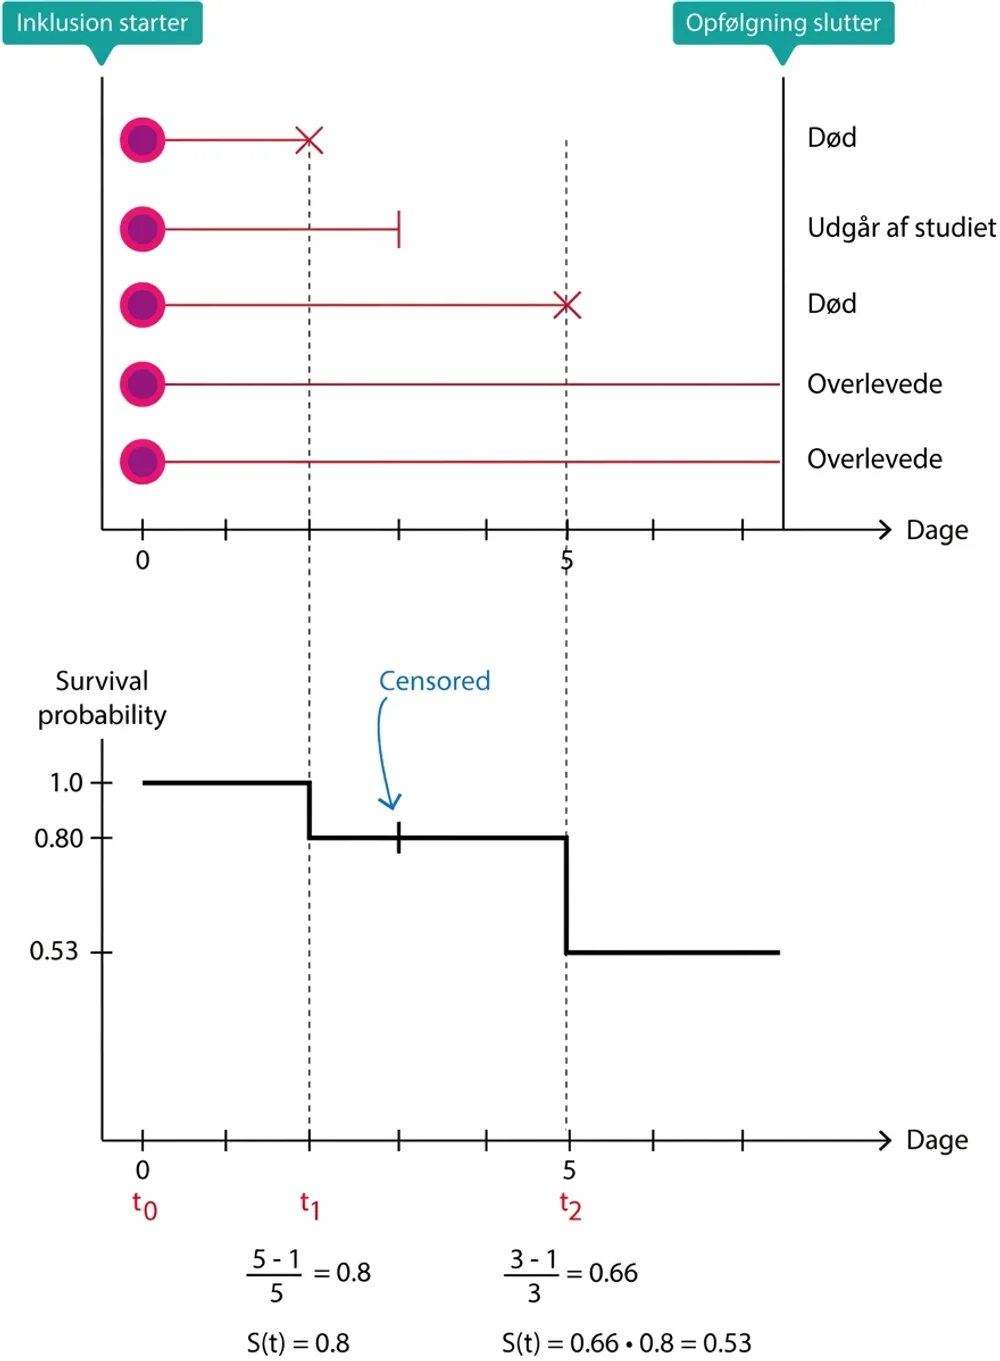
Overlevelseskurven (Kaplan-Meier-kurven) viser survival probability på Y-aksen og tid på X-aksen. Survival probability er S(t), og det er altså andelen, der stadig er i live ved hvert tidspunkt. Kurven begynder altid ved Y = 1, fordi alle overlever frem til t1 (hvor det første event indtræffer). Derefter går kurven gradvist nedad, efterhånden som folk dør. Eventuelle ”+” på kurven angiver tidspunkter, hvor personer censureres (dvs. opfølgningen slutter, før et event indtræffer). Som du kan se på figuren ovenfor, påvirkes S(t) ikke af censurering. Kaplan-Meier-kurven når kun S(t) = 0, hvis alle i studiet dør. Medianoverlevelsen er ganske enkelt andelen, der lever ved S(t) = 0,5.
Test af forskel mellem overlevelseskurver: log-rank test
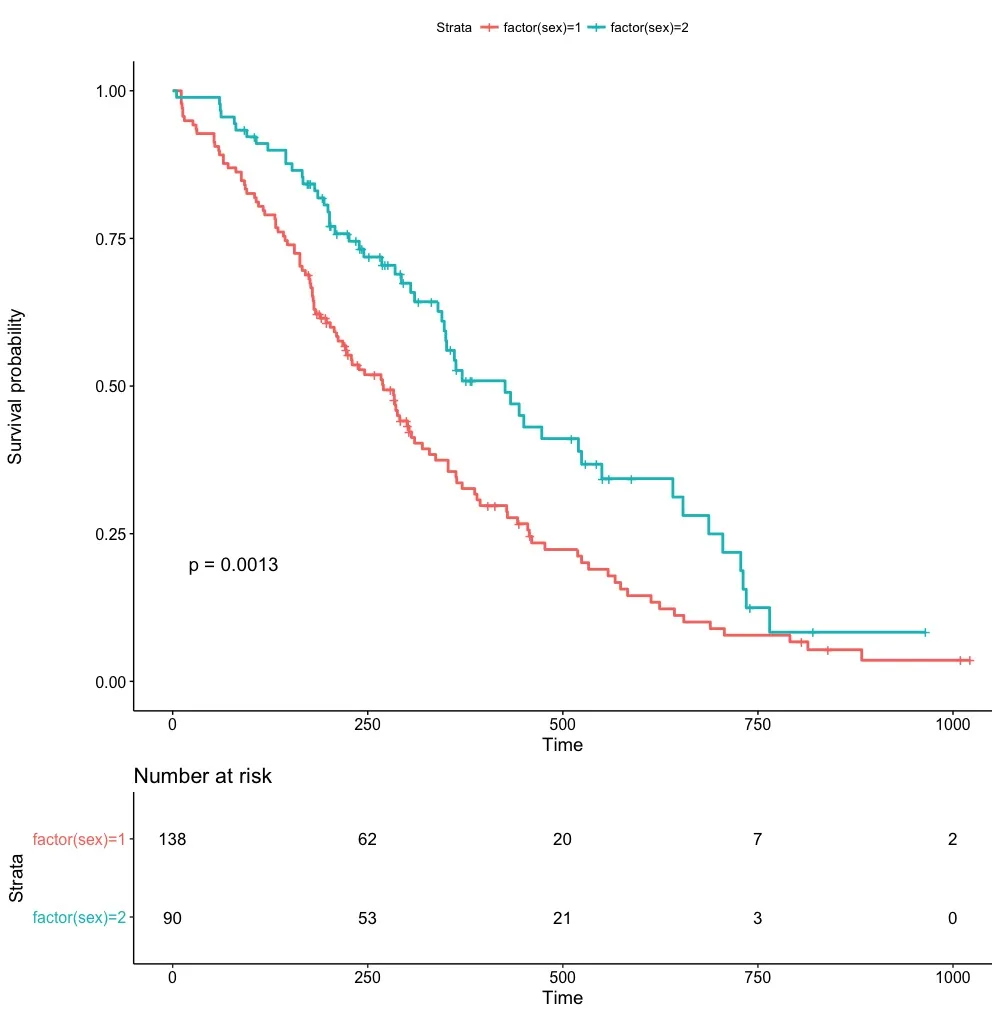
I den følgende figur sammenlignes overlevelsen mellem mænd og kvinder.
R-kode til ovenstående Kaplan-Meier-kurve
install.packages("survival")
library(survival)
install.packages("survminer")
library(survminer)
## Indlæs eksempeldata og se datastrukturen
data(lung)
str(lung)
## sikrer, at sex er en kategorisk variabel, ved at tvinge den til det via funktionen "as.factor"
lung$sex <- as.factor(lung$sex)
## Opret survfit-objekt. I dette objekt oprettes overlevelsesfunktionen
fit <- survfit(Surv(time, status==2) ~ sex, data = lung)
## Tegn Kaplan-Meier-kurve
ggsurvplot(fit, data = lung, risk.table = TRUE, pval = TRUE)
Som det fremgår ovenfor, er kurverne adskilte, hvilket betyder, at overlevelsen er forskellig for mænd og kvinder. Ved hvert tidspunkt er S(t) højere for kvinder (linjen for kvinder ligger over linjen for mænd). Det betyder, at overlevelsen er bedre for kvinder, og det kan altså vurderes visuelt. Det er dog ønskværdigt at teste, om overlevelsen er forskellig, ved at bruge en statistisk test. Til dette formål bruger man log-rank test.
Princippet for log-rank test følger princippet for hypotesetestning. Man tager udgangspunkt i nulhypotesen, som siger, at der ikke er nogen forskel mellem grupperne, og derefter beregnes en sandsynlighed (p-værdi) for, at nulhypotesen er korrekt. Hvis sandsynligheden er <0,05, forkastes nulhypotesen. Grupperne kan baseres på en vilkårlig kategorisk variabel med to eller flere kategorier. I eksemplet ovenfor er der kun to grupper, nemlig mænd og kvinder. Log-rank-testen kan altså bruges til at sammenligne to eller flere overlevelseskurver.
Således kan Kaplan-Meier-kurven bruges til at studere overlevelse. Dette kan gøres i hele populationen eller i undergrupper (fx mænd og kvinder). Man kan dog ikke justere for kovariater i en Kaplan-Meier-beregning; det kræver regressionsanalyse.
Cox-regression (Proportional Hazards Model)
I dag er Cox-regression næsten synonym med overlevelsesanalyse. Det skyldes metodens mange fordele i forhold til andre regressionsmodeller. Alternativerne til Cox-regression, eksempelvis Weibull-regression, giver under visse omstændigheder mere korrekte parameterestimater, men på bekostning af kompleksiteten. Cox-regressionen er en enkel og kraftfuld model til at studere overlevelse. Forskellen mellem Cox-regression og Kaplan-Meier-analyse er, at førstnævnte netop er en regressionsmodel, hvilket betyder, at vi kan studere, hvordan forskellige prædiktorer påvirker overlevelsen. Cox-regressioner kan, ligesom almindelig multipel regression, inkludere en eller flere prædiktorer. Cox-regression er faktisk en variant af den lineære model, hvilket forklares nedenfor.
I en Cox-regression studeres sammenhængen mellem prædiktorer (kovariater) og survival time. For at nå frem til ligningen for Cox-regression tager vi udgangspunkt i hazard function, h(t), og survival function, S(t).
- Hazard function, h(t), for en hændelse ved tidspunkt t (altså et vilkårligt tidspunkt) er ækvivalent med event rate (den hastighed, hvormed hændelser indtræffer) for de patienter, der endnu ikke har oplevet hændelsen.
- Survival function, S(t), er sandsynligheden for endnu (ved tidspunkt t) ikke at have oplevet hændelsen.
Der er en matematisk sammenhæng mellem h(t) og S(t), og den er som følger:
Cox-regressionen tager udgangspunkt i hazard function og definerer følgende model:
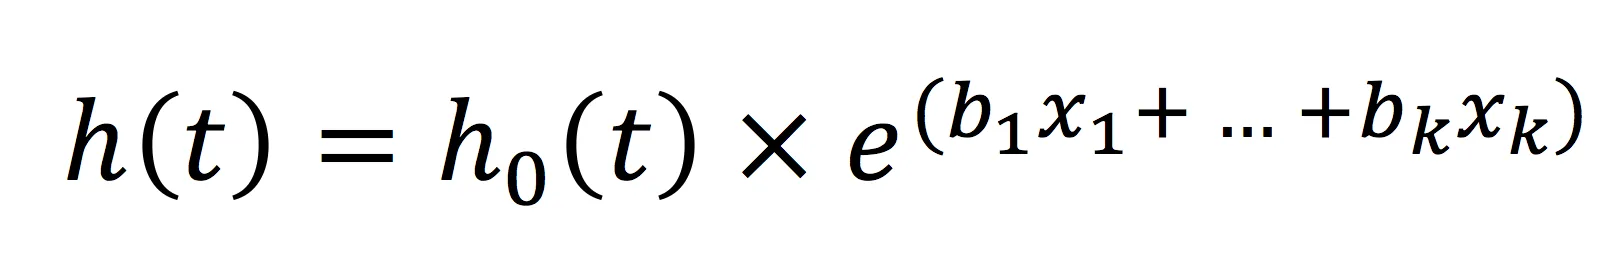
h0(t) er baseline hazard, og denne størrelse kan være en anelse besværlig. Baseline hazard er den risiko, individet har, når værdien af alle prædiktorer er 0. To eksempler følger. (1) Forestil dig, at vi studerer, hvordan alder påvirker dødeligheden. I en Cox-regression, hvor alder er den eneste prædiktor, ville baseline hazard være den risiko, mennesket har ved alder = 0 år. Efter fødslen kommer der risiko til, efterhånden som alderen stiger. (2) Forestil dig, at vi i stedet studerer, hvordan blodtryk påvirker dødeligheden. I en sådan model ville baseline hazard være individets risiko ved blodtryk = 0, hvilket ikke er biologisk meningsfuldt (ingen levende person har blodtryk = 0). Det betyder, at baseline hazard er individets risiko, når alle prædiktorer sættes til 0, hvilket er det samme som, at modellen mangler prædiktorer. Baseline hazard kan altså betragtes som risikoen ved "udgangspunktet".
x1, x2 ... xk er de prædiktorer (kovariater), der bruges til at modellere et individs hazard function. Samlingen af prædiktorer ligner således en almindelig multipel (lineær) regression. Prædiktorerne kan være kontinuerte eller kategoriske variabler. Som det fremgår af formlen ovenfor, er hele samlingen af prædiktorer eksponentieret (e).
Cox-modellen indebærer altså, at hazard ved tidspunkt t er produktet af h0(t) og eksponenten (e) af prædiktorernes samlede effekt. I næste trin dividerer vi begge sider af lighedstegnet med baseline hazard, og desuden logaritmeres begge sider. På højre side af lighedstegnet forsvinder h0(t), og eksponentieringen forsvinder. På venstre side af lighedstegnet står den naturlige logaritme af h(t)/h0(t) tilbage.
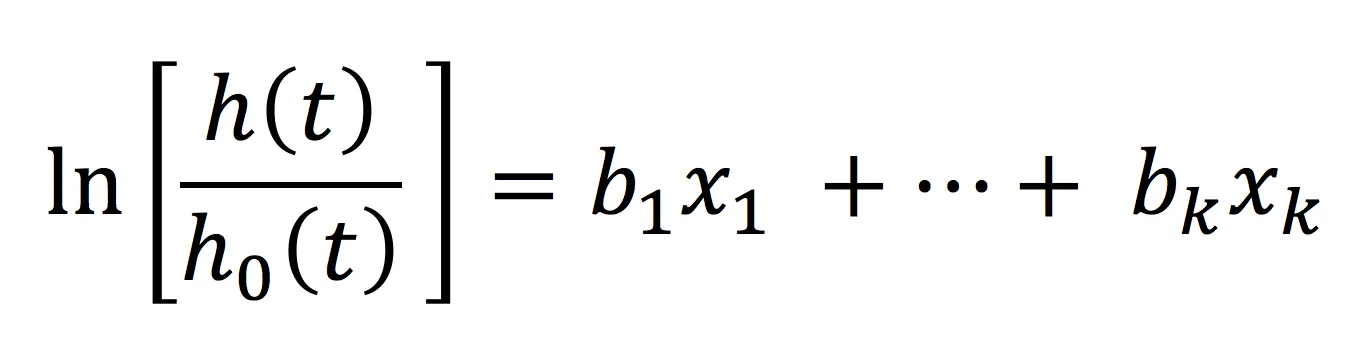
Den venstre side af ligningen er individets hazard (risiko), og den højre side er en almindelig lineær regression. Denne fremgangsmåde er nærmest genial, fordi vi nu er nået frem til en ligning, der lader os studere overlevelsen som en lineær funktion af individets prædiktorer. Det var Sir David Cox, der fremlagde de matematiske beviser for dette, og han fremhævede, at ligningen kun holder, hvis hazard er proportional. Cox Proportional Hazards Model er synonym med Cox-regression. Proportional hazard betyder, at ratio (kvotienten) mellem to individers hazard function skal være konstant over tid. Dette gælder for alle karakteristika, der definerer individerne i studiet. Et eksempel følger. Hvis vi studerer dødeligheden i Göteborg og inkluderer diabetes som en prædiktor i modellen, skal kvotienten mellem diabetikeres og ikke-diabetikeres hazard function være konstant under hele opfølgningen. Hvis der er 3 gange øget risiko for død for diabetikere i begyndelsen af opfølgningen, skal der være lige så høj risiko (3 gange) for diabetikere under hele studiets opfølgning. Forklaringen på dette følger af den næste ligning, hvor hazard function for to individer sammenlignes:
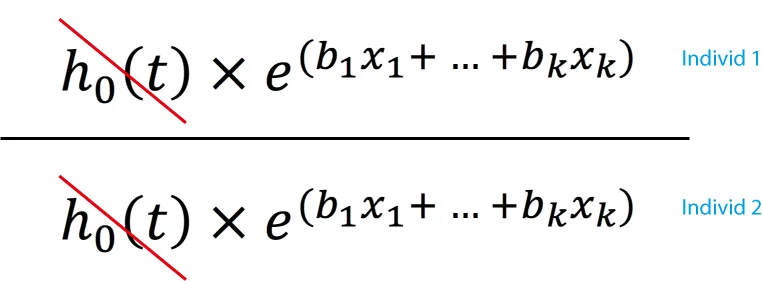
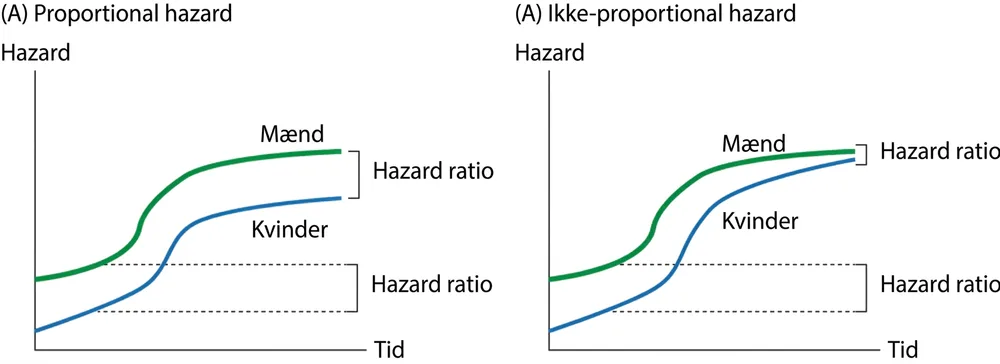
Denne kvotient mellem to hazard functions er hazard ratio (HR). Det er altså den relative forskel i risiko for individ 1 sammenlignet med individ 2. Fordi h0(t) indgår i både tælleren og nævneren, udgår den fuldstændigt. I ligningen findes heller ikke tid. Således er det kun værdierne af prædiktorerne, der adskiller individ 1 og individ 2; hverken baseline hazard eller tid kan påvirke hazard ratio, som derfor er konstant mellem individ 1 og individ 2. Det betyder også, at hvis nogen af prædiktorerne (x1, x2 ... xk) skulle have en varierende effekt over tid, vil kravet om proportional hazards ikke være opfyldt, og modellen bliver ugyldig. I Figur 4 illustreres proportional hazards og non-proportional hazards.
Hazard ratio (hazardkvotient)
Hazard ratio beregnes ved at dividere hazard for et individ med hazard for et andet individ (se formlen ovenfor). Hazard ratio beregnes, når en hændelse indtræffer. Hvis en hændelse indtræffer ved tidspunkt t, beregnes hazard ratio ved at dividere hazard for det individ, der oplevede hændelsen, med hazard for de øvrige, der klarede sig frem til tidspunkt t uden at opleve hændelsen. Baseline hazard udgår (som forklaret ovenfor) af kvotienten; ligeledes er tidspunktet irrelevant, fordi alle individer sammenlignes ved samme tidspunkt. Det, der karakteriserer individerne, bliver således deres prædiktorer (x1, x2 ... xk). Således kan effekten af prædiktorerne analyseres! I en Cox-regression beregner vi altså koefficienterne for prædiktorerne (x1, x2 ... xk), hvilket er disse prædiktorers indflydelse på overlevelsen. Den hazard ratio, der fås, når to individers hazard divideres, er logaritmeret, hvilket også gør den svær at fortolke. For at løse dette eksponentieres koefficienten. Hvis regressionskoefficienten er 0,5, bliver den eksponentierede koefficient e0,5 = 1,65. Når vi bruger termen hazard ratio, henviser vi egentlig til den eksponentierede koefficient!
Fortolkning af hazard ratio
- For en kontinuert prædiktor er hazard ratio den stigning/det fald i hazard, der følger, når prædiktoren X stiger med én enhed.
- For en kategorisk variabel er hazard ratio forskellen i hazard mellem to (eller flere grupper), hvor en af grupperne er referencegruppe.
For bedre at forstå dette har vi brug for et eksempel, og vi laver selv dette eksempel i R.
R-kode
library(survival)
## Vi opretter en Cox-regression, som studerer, hvordan age, sex og meal.cal påvirker dødeligheden
modell2 <- coxph(Surv(time, status==2) ~ age + factor(sex) + meal.cal, data = lung)
## Vi installerer og aktiverer en pakke, der laver pæne tabeller med resultaterne
install.packages("forestmodel")
library(forestmodel)
forest_model(modell2)
Resultater fra modellen
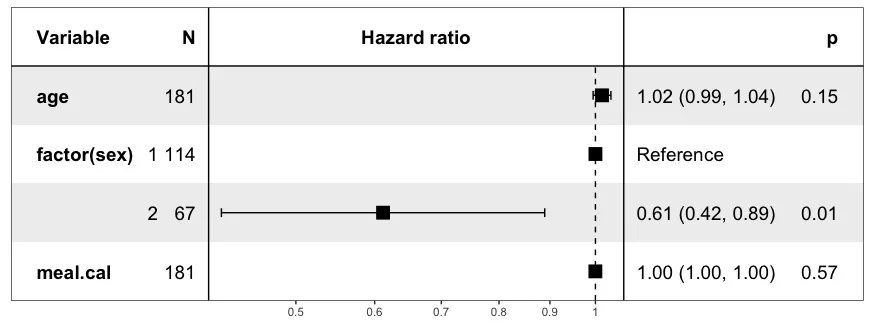
Denne model har altså tre prædiktorer: age, sex og meal.cal. Sex er en kategorisk prædiktor med niveauerne 1 (mænd) og 2 (kvinder). Age og meal.cal er kontinuerte prædiktorer. Hazard ratio præsenteres både med en graf (midten) og tal (næstsidste kolonne). Bemærk, at hazard ratio præsenteres sammen med sit 95% konfidensinterval. Eksempelvis er hazard ratio for sex 1,02 med et 95% konfidensinterval, der strækker sig fra 0,99 til 1,04. Den sidste kolonne er p-værdien, som angiver, om prædiktoren har en statistisk signifikant sammenhæng med dødeligheden. Dette er en typisk præsentation af en Cox-regression. Kolonnen "N" angiver, hvor mange individer der indgår i hver kategori (denne kolonne kan ignoreres). Herefter følger fortolkningen af resultaterne.
- Hazard ratio for sex: I tabellen er sex præsenteret på to rækker. Det skyldes, at sex er en kategorisk variabel med to niveauer. Vi får ingen koefficienter (hazard ratio) for mænd, hvilket skyldes, at mænd er referencekategorien. For alle kategoriske variabler findes der altid en referencekategori, som de øvrige kategorier skal sammenlignes med. Vi får således hazard ratio for kvinder, og resultatet er 0,61 med et konfidensinterval, der strækker sig fra 0,42 til 0,89. Dette er hazard ratio for kvinder, når de sammenlignes med mænd. Hazard ratio er mindre end 1, hvilket betyder, at kvinder har lavere risiko end mænd. Hvis vi trækker 1 fra 0,61 og multiplicerer forskellen med 100, får vi risikoforskellen i procent; (0,61-1,0)×100 = -39%. Kvinder har, sammenlignet med mænd, 39% lavere risiko for død. Dette er altså "punktestimatet", og der er en vis usikkerhed i det. Derfor får vi også et 95% konfidensinterval, som indikerer, at kvinder har (med 95% sikkerhed) mellem 58% og 11% lavere risiko end mænd.
- Hvis vi havde en prædiktor med flere end 2 niveauer, ville fortolkningen være den samme; én kategori er reference, og de øvrige kategorier sammenlignes med den.
- Konfidensintervallet for kvinder omslutter ikke værdien 1,0. Hvis hazard ratio er 1,0, er kvotientens tæller og nævner jo lige store, hvilket betyder, at der ikke er nogen forskel mellem grupperne. Det betyder, at et konfidensinterval, der omslutter 1,0, indikerer, at man ikke med 95% sikkerhed kan sige, at der er en forskel mellem grupperne. For kvindernes vedkommende indgår 1,0 ikke i konfidensintervallet, så vi kan med 95% sikkerhed sige, at der er en forskel mellem mænd og kvinder. Dette understøttes af p-værdien (0,01), som angiver, at køn er en statistisk signifikant prædiktor.
- Denne model inkluderer altså også age og meal.cal ud over sex. Så er effekten af sex justeret for effekten af de øvrige prædiktorer i modellen (de øvrige prædiktorer "holdes konstante").
- Age (alder) er en kontinuert prædiktor. Derfor fortolkes hazard ratio som stigningen i hazard for hver enhed, alderen stiger. I dette studie var alder målt på skalaen år, så hazard ratio er stigningen i hazard for hvert år, deltagerne bliver ældre. Resultatet blev 1,02 med et konfidensinterval fra 0,99 til 1,04. Eftersom hazard ratio (punktestimatet) er 1,02, betyder det, at for hvert år deltagerne bliver ældre, stiger risikoen for død med 2%. Man kan let beregne, hvor meget risikoen stiger over 15 år, ved beregningen 1,0215, hvilket giver en hazard ratio på 1,35 (dvs. 35% øget risiko). I dette tilfælde omslutter konfidensintervallet dog 1,0, fordi intervallet strækker sig fra 0,99 til 1,04, og dermed kan vi ikke med sikkerhed sige, at alder har en effekt. Denne påstand understøttes af p-værdien, som er 0,15 og dermed ikke signifikant.
I Cox-regression er sammenhængen mellem prædiktoren og hazard altså lineær. Modellen er dog ikke helt parametrisk, fordi der findes en baseline hazard. Cox-regression er således en semiparametrisk model.
Konfidensinterval og p-værdier for hazard ratio
I R og al anden statistisk software får man automatisk standard error (SE), p-værdier og konfidensintervaller, når man opretter modellen. Konfidensintervallet er et såkaldt Wald-interval, fordi man bruger estimater direkte fra modellen til at beregne intervallet.
Nedre grænse: HR - 1,96×SE
Øvre grænse: HR + 1,96×SE
Hvor HR er hazard ratio, og SE er standard error.
Detaljer om proportional hazards
Proportional hazard kan også forklares ved interaktioner mellem en prædiktor og tid. Hvis en prædiktor opfylder kriteriet for proportional hazard, må der ikke være nogen statistisk signifikant interaktion mellem den prædiktor og opfølgningstiden (survival time). Man kan således lave et interaktionsled (prædiktor×opfølgningstid) og vurdere, om det er statistisk signifikant. Hvis interaktionen ikke er signifikant, betyder det, at prædiktoren udøver den samme effekt på hazard function ved alle værdier af t (opfølgningstid), og så er kriteriet for proportional hazard opfyldt. Hvis interaktionen derimod er signifikant, betyder det, at effekten af prædiktoren varierer over tid, og så strider den variabel mod antagelsen om proportional hazard. Der findes yderligere måder at vurdere proportional hazards på, og de er som følger:
- Vurdering af Schoenfeld-residualer
- Visualisering af log(-log S(t)) mod t
Egentlig bør man foretrække de to sidstnævnte metoder frem for interaktionsled. I R findes enkle funktioner, der præsenterer både Schoenfeld-residualer og grafer over log(-log S(t)) mod t.
Stratificering (den stratificerede Cox-model)
Cox-regressionen giver mulighed for at justere for variabler, der ikke indgår i modellen, og det gøres ved at stratificere. Man må ikke forveksle stratificering ved Cox-regression med stratificering ved almindelig lineær (multipel) regression.
Ved almindelig lineær (multipel) regression betyder stratificering, at man laver separate modeller ud fra en kategorisk variabel. Eksempel følger. Antag, at vi studerer, hvordan alder påvirker blodtrykket, og at vi også har oplysninger om vægt. Hvis vi vil vide, hvordan alder påvirker blodtrykket i forskellige vægtkategorier, kan vi stratificere analysen ved at lave én regression for normalvægtige, én regression for overvægtige og én regression for personer med svær overvægt. Dette er altså tre separate modeller, som giver separate koefficienter for alder.
Ved Cox-regression kan stratificeringen håndteres anderledes. Cox-modellen tillader os at stratificere data (patienterne) ud fra en kategorisk variabel. Baseline hazard tillades at variere mellem disse strata. Modellen kan derefter estimere en samlet (kumulativ) effekt af alder i alle strata. Så får vi kun én koefficient for alder i stedet for separate koefficienter i hvert stratum. Man kan sige, at effekten af alder "pooles" (vægtes sammen) på tværs af alle strata.
Der er flere situationer, hvor det er klogt at stratificere modellen. Eksempel følger. Hvis en variabel strider mod antagelsen om proportional hazard, kan man kategorisere variablen i to eller flere passende niveauer og stratificere modellen på den variabel. Så har man justeret for variablen, og man behøver ikke bekymre sig om, at den strider mod proportional hazards. Ulempen er, at man ikke får nogen regressionskoefficienter for variablen (men hvis den alligevel ikke er af interesse for analysen, er dette ingen større ulempe.