
Overlevelsesanalyse
Overlevelsesanalyse er et kraftfuldt værktøj til at studere hændelser (events). Centralt for overlevelsesanalyse er information om observationstid. Med overlevelsesanalyse studeres nemlig tiden, indtil en hændelse indtræffer. I engelsksproget litteratur anvendes termerne survival analysis eller time-to-event analysis. Den sidstnævnte term, time-to-event analysis, er egentlig den mest korrekte, fordi disse analyser kan bruges til at studere alle typer hændelser, ikke kun død. I dette kapitel vil vi dog bruge død som eksempel, fordi det gør det lettere at forstå.
Fundamentet i overlevelsesanalyse er Kaplan-Meier-metoden og Cox-regression. Originalpublikationerne for disse metoder er blandt de mest citerede værker nogensinde i medicinsk forskning (1, 2).
For at gennemføre en overlevelsesanalyse kræves information om observationstid, dvs. den tidsperiode, hvor individet observeres. I sin reneste form starter observationstiden, når individet inkluderes i studiet, og observationstiden slutter, når hændelsen indtræffer, eller når studiets opfølgningsperiode er slut. Den tidsperiode, hvor individet observeres, kaldes survival time.
Overlevelsesanalyse kan bruges til at studere tid til hændelser for andre organismer (eksempelvis dyr, bakterier), virus eller endda teknisk udstyr (eksempelvis mobiltelefoner). Hvis formålet er at studere tiden, indtil en hændelse indtræffer, kan overlevelsesanalyse anvendes, uanset hvilken type enhed der studeres.
Formålet med overlevelsesanalyse er følgende:
- At studere overlevelsesprocessen.
- At studere, hvordan forskellige prædiktorer (variabler) påvirker overlevelsen.
- At skabe en prædiktionsmodel, der prædikterer (forudsiger) overlevelse.
For at studere overlevelsesprocessen kan man bruge deskriptive metoder, hvoraf den vigtigste er Kaplan-Meier-estimatoren. Med Kaplan-Meiers metode får man en grafisk (og matematisk) beskrivelse af overlevelsen. Med metoden kan man også sammenligne overlevelsen mellem to eller flere grupper. Metoden er dog en rent deskriptiv beskrivelse af overlevelsen og tillader dermed ikke analyse af, hvordan forskellige prædiktorer påvirker overlevelsen.
For at studere, hvordan forskellige prædiktorer påvirker overlevelsen, kræves regressionsanalyse. Aktuelt domineres overlevelsesanalyse af Cox-regression (Cox Proportional Hazards Model), som gør det muligt at opstille en regressionsmodel for overlevelse. Cox-regression er et overordentlig kraftfuldt værktøj, og der publiceres dagligt tusindvis af artikler, hvor Cox-regressionen udgør studiets hovedmetode.
Kaplan-Meier-estimatoren og Cox-regression er de vigtigste værktøjer at beherske, og derfor kredser den videre diskussion om disse to metoder.
Overlevelsesanalyse vs. logistisk regression
Med overlevelsesanalyse studeres således dikotome (binære) hændelser (events). Formålet er at studere, om en hændelse indtræffer eller udebliver. I den henseende har overlevelsesanalyse ligheder med logistisk regression (se Logistisk Regression). Faktisk bruges logistisk regression også til at studere binære hændelser, herunder overlevelse. Logistisk regression er dog (i princippet) altid et dårligere valg end overlevelsesanalyse til at studere overlevelse, hvis der findes information om observationstid. Det skyldes, at logistisk regression ikke kan tage højde for observationstiden. Selve observationstiden er nøglen til overlevelsesanalysen (det er faktisk survival time-fordelingen, der studeres ved overlevelsesanalyse), og den kan ikke tages i betragtning i en logistisk regression. Lad os illustrere dette med et overdrevet eksempel:
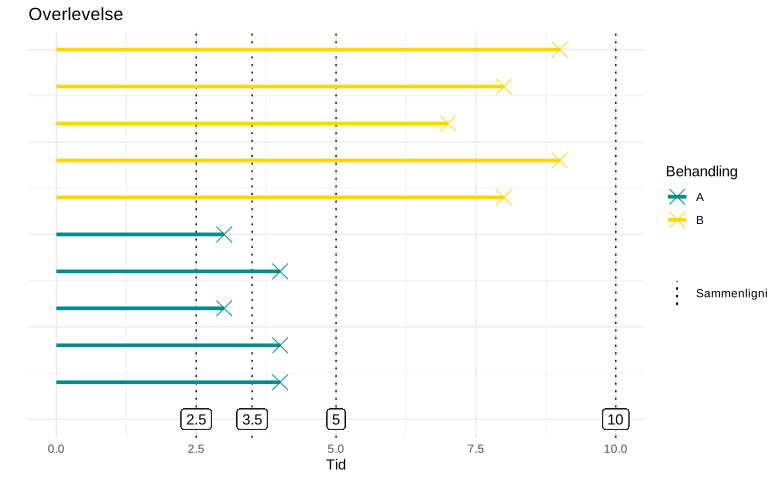
Vi studerer effekten af lægemiddel A og B, som blev givet til 10 patienter med lungekræft. Disse patienter blev fulgt fra inklusion i op til 10 år. Da opfølgningen var slut, var samtlige patienter døde (se figuren ovenfor). Det betyder, at lige mange var døde i begge grupper, da studiets opfølgning var slut. Vi gennemfører en logistisk regression, hvor overlevelse studeres (som et binært udfald) på følgende tidspunkter:
- Tid 2,5: På dette tidspunkt er der ingen forskel mellem grupperne.
- Tid 3,5: På dette tidspunkt er overlevelsen 5 af 5 i gruppe B og 3 af 5 i gruppe A. Risikoen for død er højere i gruppe A.
- Tid 5: Alle i gruppe A er døde, mens ingen er døde i gruppe B. Risikoen for død i gruppe A er uendeligt meget højere end i gruppe B.
- Tid 10: Alle er døde i begge grupper. Der er ingen forskel mellem lægemiddel A og B.
Det betyder, at logistisk regression kan give meget upålidelige resultater for en overlevelsesproces. Figuren ovenfor viser, at lægemiddel B sandsynligvis er bedre end A. Med overlevelsesanalyse ville vi kunne bekræfte dette, fordi overlevelsesanalyse inkorporerer selve overlevelsestiden (survival time), som er forskellig mellem grupperne. Med overlevelsesanalyse har vi større chance for at finde forskelle i overlevelse. Man bør altid foretrække overlevelsesanalyse frem for logistisk regression til at studere overlevelse. (Det skal dog nævnes, at logistisk regression under særlige omstændigheder kan være ækvivalent med Cox-regression, men det diskuteres ikke i dette kapitel).
Event (outcome, udfaldsmål, hændelsen) i overlevelsesanalyse
Udfaldet i en overlevelsesanalyse er en hændelse (eng. event). Denne hændelse kan i princippet være af en hvilken som helst type. Eksempler på processer, der kan studeres med overlevelsesanalyse, er følgende:
- Tid til død
- Tid til kræftdiagnose
- Tid til helbredelse
- Tid til indlæggelse på hospital
- Tid til, at man bliver arbejdsløs
- Tid til, at en computer skal repareres
- Tid til, at et fødevareprodukt ikke længere kan spises
Man kan altså studere alle typer hændelser med overlevelsesanalyse. Selve hændelsens natur er altså af underordnet betydning. Det er dog undersøgerens ansvar at definere en klar og meningsfuld hændelse. Alle personer eller enheder, der indgår i populationen, skal følges fra det tidspunkt, hvor de inkluderes i studiet (hvor observationstiden starter), indtil opfølgningen er slut. Det er vigtigt at kunne datere tidspunktet for hændelsen (med så høj præcision som muligt), så observationstiden kan beregnes med høj præcision. Det er eksempelvis bedre at registrere survival time i dage frem for måneder. Jo grovere mål for survival time, desto dårligere præcision i analysen.
Prædiktorer, kovariater & uafhængige variabler
Når overlevelsesanalyse bruges til at studere, hvordan forskellige variabler påvirker udfaldet, sker det sædvanligvis med Cox-regression (Cox proportional hazards model). De variabler, der studeres, kaldes prædiktorer (alternativt , kovariater eller uafhængige variabler). Alle tre betegnelser kan bruges, og de henviser altså til det samme.
Censoring (censurering)
Overlevelsestid (eng. survival time) er en kontinuert variabel, og det kan derfor være fristende at bruge lineær regression til at studere overlevelse. Det er dog ikke muligt at bruge lineær regression, og det skyldes *censurering (*eng. censoring). Der er stor sandsynlighed for, at ikke alle personer vil blive ramt af den hændelse, der studeres. De personer, der overlever hele opfølgningen (dvs. dem, der ikke rammes af hændelsen i løbet af studiets observationstid), udgør et matematisk problem, fordi vi ikke kan sige, om eller hvornår de vil blive ramt af hændelsen. Disse personer bliver censurerede (eng. censored), når studiets opfølgning slutter (eng. end of follow-up). Samme problem opstår, hvis studiedeltagere udgår af studiet eller af en anden grund ikke længere kan følges. Disse personer bliver også censurerede (fordi vi ikke ved, om eller hvornår de vil blive ramt).
Censurering (censoring) betyder, at opfølgningen er afsluttet, og at hændelsen endnu ikke er indtruffet.
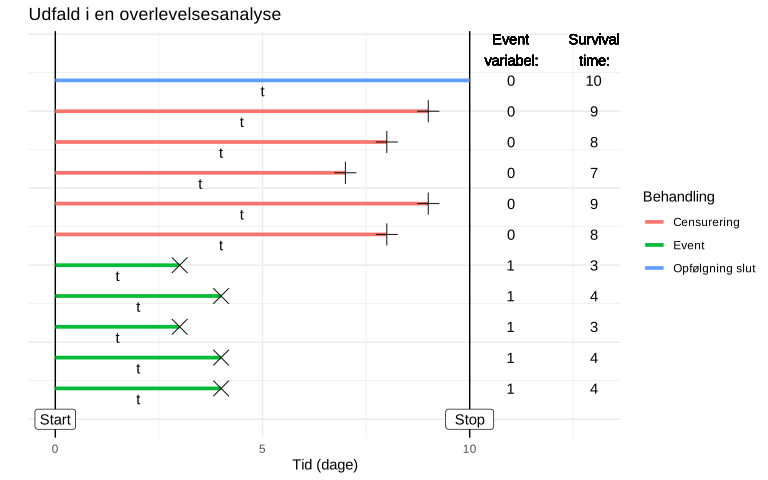
Man skelner mellem tre typer censoring:
- Right censoring: Hvis en person gennemfører studiet, uden at hændelsen indtræffer, bliver personen right censored. Det betyder, at vi kun kan udtale os om personens skæbne frem til det øjeblik, hvor opfølgningen slutter. Personer, der udgår af studiet (uanset årsag), bliver også right censored.
- Left censoring: Vi er ofte interesserede i, hvordan en bestemt eksponering, f.eks. en sygdom, påvirker overlevelsen. Ofte er det dog ukendt, hvornår sygdommen debuterer (opstår). Det er meget almindeligt, at sygdomme har været til stede i mange år, før de opdages. Hvis det er ukendt, hvornår en eksponering startede, er individet left censored i den henseende. Left censoring betyder altså, at det er uklart, hvornår individets risiko startede. Dette plejer dog ikke at være et større problem.
- Interval censoring: Hvis en person er både left og right censored, er den interval censored.
Kodning af overlevelsesvariabler
For at analysere overlevelse kræves mindst følgende to variabler:
- Event-variabel: Denne kodes oftest som 0 eller 1 og angiver, om eventet er indtruffet (1) eller udeblevet (0).
- Survival time: Survival time er observationstiden (kontinuert variabel).
Figuren ovenfor viser, hvordan disse variabler ville blive kodet for de 10 personer, der følges i grafen.
Informativ vs. non-informativ censoring
Censoring skal være uafhængig af (1) individets kovariater (prædiktorer) for overlevelse og (2) hvor længe individet har klaret sig i studiet. Censoring i løbet af studiet (før opfølgningen er afsluttet) skal være tilfældig, ellers foreligger der bias i studiet. Antag, at vi studerer, hvordan et lægemiddel påvirker risikoen for død. Lægemidlet viser sig at medføre svære bivirkninger, i en sådan grad at mange personer, der får lægemidlet, tvinges til at udgå af studiet. I det tilfælde påvirkes censoring af en prædiktor, nemlig lægemidlet, og så opstår der bias, fordi patienterne udgår af studiet, før de når at udvikle komplikationer. Dette fører til underestimering af antallet af events (dødsfald) og dermed overestimering af overlevelsen. Den type censoring kaldes informativ censoring, hvilket betyder, at censoring ikke var tilfældig. Hvis censoring er non-informative, vil fordelingen af survival time blandt censurerede tilfælde være ensartet mellem de grupper, der sammenlignes.
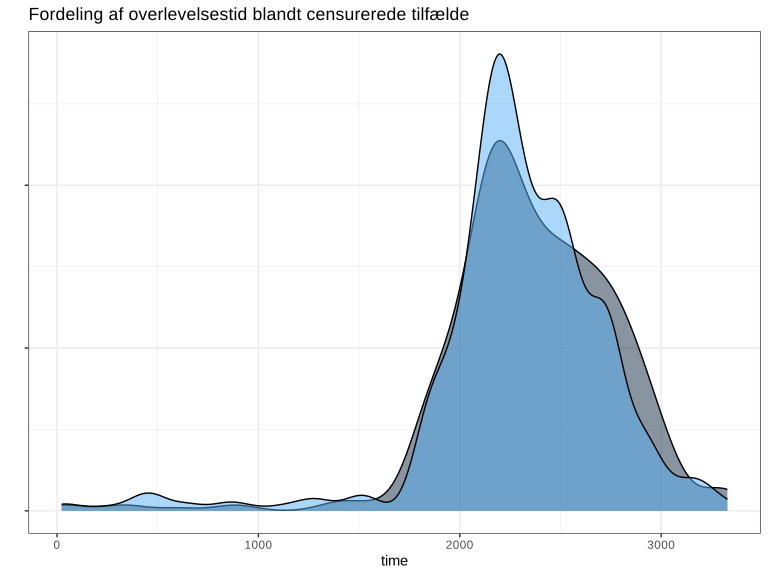
Censoring skal være non-informativ, hvilket betyder, at censoring skal være tilfældig. Der må ikke findes nogen mekanisme, der påvirker sandsynligheden for censoring.
I næste kapitel diskuteres de to mest almindelige metoder til at studere overlevelse, nemlig Kaplan-Meier-metoden og Cox-regression.