
Cox-regression
Cox-regression er synonym med overlevelsesanalyse. Det skyldes metodens mange fordele i forhold til andre regressionsmodeller. Alternativerne til Cox-regression, eksempelvis Weibull-regression, giver under visse omstændigheder mere korrekte modeller, men på bekostning af øget kompleksitet. Cox-regression er en enkel og kraftfuld model til at studere overlevelse. Forskellen mellem Cox-regression og Kaplan-Meier-estimatoren er, at førstnævnte er en regressionsmodel, hvilket betyder, at vi kan studere, hvordan flere prædiktorer påvirker overlevelsen. Cox-regressioner kan, ligesom almindelig multipel regression, indeholde en eller flere prædiktorer.
Kapitlerne Overlevelsesanalyse og Kaplan-Meier-estimatoren bør læses før dette kapitel. Det er ikke nødvendigt at forstå alle nedenstående formler for at bruge Cox-regression. Efter den matematiske gennemgang nedenfor følger forklaringer og praktiske eksempler på udførelse og fortolkning af Cox-regressioner.
Med Cox-regression undersøges sammenhængen mellem prædiktorer (kovariater) og survival time (observationstid). For at forstå Cox-regression tager vi udgangspunkt i hazard function, , og survival function, .
- : Overlevelsesfunktionen (survival function) er sandsynligheden for, at en person er i live efter tidspunkt .
- Fortolkning: Hvad er sandsynligheden for, at jeg lever om 1 år?
- : Hazardfunktionen (hazard function, hazard rate) er den momentane risiko (sandsynlighed) for, at hændelsen indtræffer på tidspunkt , forudsat at personen har overlevet til .
- Fortolkning: Hvad er sandsynligheden for, at jeg dør om 1 år, givet at jeg har overlevet indtil nu?
og har egenskaber, der gør dem velegnede til at studere overlevelse. Det fremgår ikke mindst af de relevante spørgsmål, som funktionerne besvarer (se fortolkning ovenfor).
Survival time (overlevelsestid, T) er en kontinuert variabel (ofte angivet som antal dage) og kan derfor beskrives med en kumulativ fordelingsfunktion (cumulative distribution function, CDF):
beskriver sandsynligheden for, at er mindre end eller lig med . Overlevelsestid betegnes og kan også beskrives med en kumulativ fordelingsfunktion:
beskriver sandsynligheden for, at hændelsen indtræffer senest på tidspunkt . Sandsynligheden for, at et nyfødt barn dør i en alder af 90 år, er cirka 1 %, men hvis barnet når en alder af 89 år, er sandsynligheden for død på 90-årsdagen 10 %. Med kan vi estimere , som er sandsynligheden for, at individet overlever tidspunkt :
er sandsynligheden for at overleve tidspunkt .
Hazardfunktionen (hazard function) har følgende formel:
betyder, at brøken gælder, når risikoen (hazard) studeres over en meget kort tidsperiode, dvs. når (forskellen i ) går mod . Tælleren i indeholder |, hvilket betyder, at der er tale om en betinget sandsynlighed. Tælleren beskriver sandsynligheden for, at hændelsen indtræffer i et lille tidsinterval mellem og , betinget af at individet har overlevet til . Nævneren angiver tidsintervallets længde (). Hazardfunktionen () svarer således til event rate (den hastighed, hvormed hændelser indtræffer) for individer, som endnu ikke har oplevet hændelsen.
Tælleren i udgør forholdet mellem sandsynligheden for, at T ligger i intervallet til , og , hvoraf sidstnævnte svarer til , og førstnævnte kan omskrives til for små . Ved at dividere dette forhold med får vi følgende formel:
Dette er den simple hazardfunktion. Den fortæller, at den hastighed, hvormed hændelser indtræffer på tidspunkt , svarer til tætheden (eng. density) af events på tidspunkt divideret med sandsynligheden for at overleve til tidspunkt uden at opleve hændelsen. Tælleren er en tæthedsfunktion (probability density function, PDF). Da er den afledte af , kan formlen skrives som følger:
Hvis denne integreres fra til , og , kan følgende formel bruges til at beskrive sandsynligheden for at overleve til tidspunkt som en funktion af hazard på alle tidspunkter frem til .
Integralfunktionen ovenfor er cumulative hazard (cumulative risk) og formuleres som følger:
Kumulativ hazard er den akkumulerede risiko, et individ erhverver sig, når det bevæger sig fra til .
Med kan vi altid beregne og dermed få . Med kan vi altid beregne kumulativ hazard og eksponentiere den for at få .
Et individ, der har overlevet til tidspunkt , er som regel mere interesseret i sin betingede sandsynlighed for overlevelse end i den ubetingede. I praksis betyder det, at et individ, der har overlevet til tidspunkt efter en kræftdiagnose, er mere interesseret i sin forventede overlevelse fra tidspunkt . Desuden er hazardfunktionen en enkel og pragmatisk beregning, når observationerne er højrecensurerede.
Cox-regression
Med Cox-regression beskrives hazard for et individ med prædiktorerne (kovariaterne) som følger:
Hvor er baseline hazard, som er individets risiko, når alle variabler har værdien 0 (for kontinuerte variabler) eller er på referenceniveauet (for kategoriske variabler), og er de eksponentierede prædiktorer. Den eneste størrelse ovenfor, som indeholder , er baseline hazard. Som det fremgår nedenfor, vil baseline hazard automatisk blive elimineret, og dermed bliver hazard uafhængig af .
Hvis alle prædiktorer har værdien 0, elimineres hele eksponenten, og formlen bliver som følger:
.
Ovenstående formel er definitionen på baseline hazard, som altså er hazard, når alle prædiktorer har værdien 0. Baseline hazard er uinteressant i Cox-regression. Der gøres ingen antagelser om baseline hazard, og den må variere vilkårligt. Forklaringen er, at formålet med Cox-regression er at sammenligne eksponeringer (eksempelvis behandlinger, interventioner osv.), og når to individer sammenlignes, eliminerer de hinandens baseline hazard, hvilket demonstreres nedenfor.
Hvis begge sider af ligningen logaritmeres, får vi en model, hvor prædiktorernes effekt er additiv (dvs. de har en uafhængig indflydelse på det undersøgte udfald) og lineær, hvilket minder om klassisk lineær regression.
Antag, at vi studerer sammenhængen mellem prædiktoren køn og overlevelse. Køn er defineret som følger:
For denne variabel er mand referencegruppe. Cox-regressionen for denne model er som følger:
Hazard for mænd:
Hazard for kvinder:
Hazard ratio (HR, hazardratio)
Hazard ratio (HR) beregnes som forholdet mellem gruppernes hazard, hvor referencegruppen (mænd) udgør nævneren:
Effekten af er den samme ved alle . Formlen forudsætter og fungerer kun, hvis hazard ratio ikke varierer over tid. Cox' model kaldes derfor også Cox proportional hazards model.
Cox-regression betyder altså, at hazard (risiko) på tidspunkt er produktet af baseline hazard og eksponenten af prædiktorernes samlede effekt.
Cox-regression i praksis
Baseline hazard i Cox-regression
er baseline hazard, og denne størrelse kan være svær at forstå. Baseline hazard er den risiko, individet har, når værdien af alle prædiktorer er 0. To eksempler følger:
- Antag, at vi studerer, hvordan alder påvirker dødelighed. I en Cox-regression, hvor alder er den eneste prædiktor, vil baseline hazard være den risiko, mennesket har ved alder = 0 år. Efter fødslen øges risikoen, efterhånden som alderen stiger.
- Antag, at vi studerer, hvordan blodtryk påvirker dødelighed. I en sådan model vil baseline hazard være individets risiko ved blodtryk = 0, hvilket ikke er biologisk meningsfuldt (ingen levende person har blodtryk = 0). Det betyder, at baseline hazard er individets risiko, når alle prædiktorer sættes til 0, hvilket er det samme, som at modellen ikke har nogen prædiktorer.
Prædiktorer (kovariater) i Cox-regression
er de prædiktorer (kovariater), der bruges til at modellere et individs hazard function. Samlingen af prædiktorer ligner således en almindelig multipel (lineær) regression. Prædiktorerne kan være kontinuerte eller kategoriske variabler. Prædiktorerne udøver en additiv effekt, hvilket betyder, at hver enkelt prædiktor har en uafhængig (af de andre prædiktorer) effekt på udfaldet (). Desuden er sammenhængen mellem prædiktorerne og udfaldet lineær. Antagelserne om additivitet og linearitet kan modificeres (se nedenfor).
Proportional hazards
Som nævnt ovenfor er hazard (risiko) på tidspunkt produktet af baseline hazard og eksponenten af prædiktorernes samlede effekt. Det holder under antagelsen om, at hazard er proportional over tid. Proportional hazard betyder, at forholdet (ratio) mellem to individers hazard function skal være konstant over tid. Det gælder for alle de karakteristika, der definerer individerne. Et eksempel følger.
Hvis vi studerer dødelighed blandt personer med eller uden diabetes, skal forholdet mellem diabetikeres og ikke-diabetikeres hazard function være konstant under hele opfølgningen. Hvis der er 2 gange øget risiko for død for diabetikere i starten af opfølgningen, skal der være lige så høj risiko (2 gange øget risiko) for diabetikere under hele studiets opfølgning.
Forholdet mellem to hazard functions er hazard ratio (HR). Det er altså den relative forskel i risiko for to individer. Da indgår i både tælleren og nævneren, elimineres den. I ligningen indgår tid heller ikke. Således er det kun værdierne af prædiktorerne, der adskiller individ 1 og individ 2; hverken baseline hazard eller tid kan påvirke hazard ratio, som derfor er konstant mellem individ 1 og individ 2. Det betyder også, at hvis nogen af prædiktorerne () har en effekt, der varierer over tid, vil kravet om proportional hazards ikke være opfyldt, og modellen bliver ugyldig.
Hazard ratio (hazardratio)
Hazard ratio beregnes ved at dividere hazard for et individ med hazard for et andet individ (se formlen ovenfor). Hazard ratio beregnes, når en hændelse indtræffer. Hvis en hændelse indtræffer på tidspunkt t, beregnes hazard ratio ved at dividere hazard for det individ, der oplevede hændelsen, med hazard for de øvrige, som klarede sig til tidspunkt t uden at opleve hændelsen. Baseline hazard udgår (se ovenfor) af brøken, og ligeledes er tidspunktet irrelevant, fordi alle individer sammenlignes på samme tidspunkt. Det, der karakteriserer individerne, bliver således deres prædiktorer (x1, x2 … xk). Dermed kan effekten af prædiktorerne analyseres.
I en Cox-regression beregnes således koefficienterne for prædiktorerne (), som er disse prædiktorers indflydelse på overlevelsen. Den hazard ratio, man får, når to individers hazard divideres, er logaritmeret, hvilket også gør den svær at fortolke. For at afhjælpe dette eksponentieres koefficienten. Hvis regressionskoefficienten er 0,5, bliver den eksponentierede koefficient e0,5 = 1,65. Når vi bruger betegnelsen hazard ratio, henviser vi egentlig til den eksponentierede koefficient.
Fortolkning af hazard ratio
- For en kontinuert prædiktor er hazard ratio den stigning/det fald i hazard, der følger, når prædiktoren stiger med én enhed.
- For en kategorisk variabel er hazard ratio forskellen i hazard mellem to (eller flere) grupper, hvor en af grupperne er referencegruppe.
For bedre at forstå dette har vi brug for et eksempel, og vi laver selv dette eksempel i R.
Eksempel på Cox-regression i R
Vi bruger data fra et klinisk studie om coloncancer (tyktarmskræft). Disse data findes i pakken survival, som også indeholder mange vigtige funktioner til overlevelsesanalyse.
## Aktivér tidyverse
library(tidyverse)

## Aktivér survival-pakken
library(survival)

## Importér eksempeldata
data(cancer)
## Inspicér de første rækker
head(colon)
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1Vi omkoder visse variabler, så de korrekt klassificeres som kategoriske:
## Omkoder visse kategoriske variabler
colon <- colon |>
  mutate(sex = recode_factor(sex, '1'='Man', '0'='Kvinna'),
         perfor = recode_factor(perfor, '1'='Yes', '0'='No'),
         obstruct = recode_factor(obstruct, '1'='Yes', '0'='No'))
Nu laver vi en Cox-regression ved hjælp af funktionen coxph(). Resultatet gemmes i objektet min_modell. Bemærk, at vi skal angive et overlevelsesobjekt ved hjælp af funktionen Surv(). I Surv() angiver vi, hvilke variabler der udgør observationstiden (time) og udfaldet (status). I dette tilfælde angiver vi med status==1, hvilken værdi af status der betyder, at hændelsen er indtruffet.
min_modell <- coxph(Surv(time, status==1) ~ sex + age + nodes + perfor + obstruct, data=colon)

## Udskriv resultatet
summary(min_modell)Call:
coxph(formula = Surv(time, status == 1) ~ sex + age + nodes +
perfor + obstruct, data = colon)
n= 1822, number of events= 897
(36 observations deleted due to missingness)
coef exp(coef) se(coef) z Pr(>|z|)
sexKvinna 0.057961 1.059674 0.067077 0.864 0.38753
age 0.001363 1.001364 0.002822 0.483 0.62911
nodes 0.088342 1.092362 0.006342 13.929 < 2e-16 ***
perforNo -0.223009 0.800107 0.181919 -1.226 0.22025
obstructNo -0.249065 0.779529 0.082675 -3.013 0.00259 **
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
exp(coef) exp(-coef) lower .95 upper .95
sexKvinna 1.0597 0.9437 0.9291 1.2086
age 1.0014 0.9986 0.9958 1.0069
nodes 1.0924 0.9154 1.0789 1.1060
perforNo 0.8001 1.2498 0.5601 1.1429
obstructNo 0.7795 1.2828 0.6629 0.9167
Concordance= 0.635 (se = 0.009 )
Likelihood ratio test= 145.1 on 5 df, p=<2e-16
Wald test = 202.8 on 5 df, p=<2e-16
Score (logrank) test = 206.2 on 5 df, p=<2e-16Ovenstående udskrift er ganske vist informativ, men den mangler en del information og er ikke æstetisk tiltalende nok til at indgå i en rapport. Ved hjælp af pakken gtsummary kan vi lave en æstetisk tiltalende tabel, som er let at modificere. Funktionerne i gtsummary fungerer som de øvrige funktioner i tidyverse, hvilket betyder, at man trinvis tilføjer lag med komponenter, som vist nedenfor. Du kan formentlig gætte, hvad de forskellige funktioner tilføjer til tabellen.
library(gtsummary)

min_modell |>
  tbl_regression(exponentiate = TRUE) |>
  add_global_p() |>
  bold_labels() |>
  italicize_levels() |>
  add_nevent() |>
  add_glance_source_note()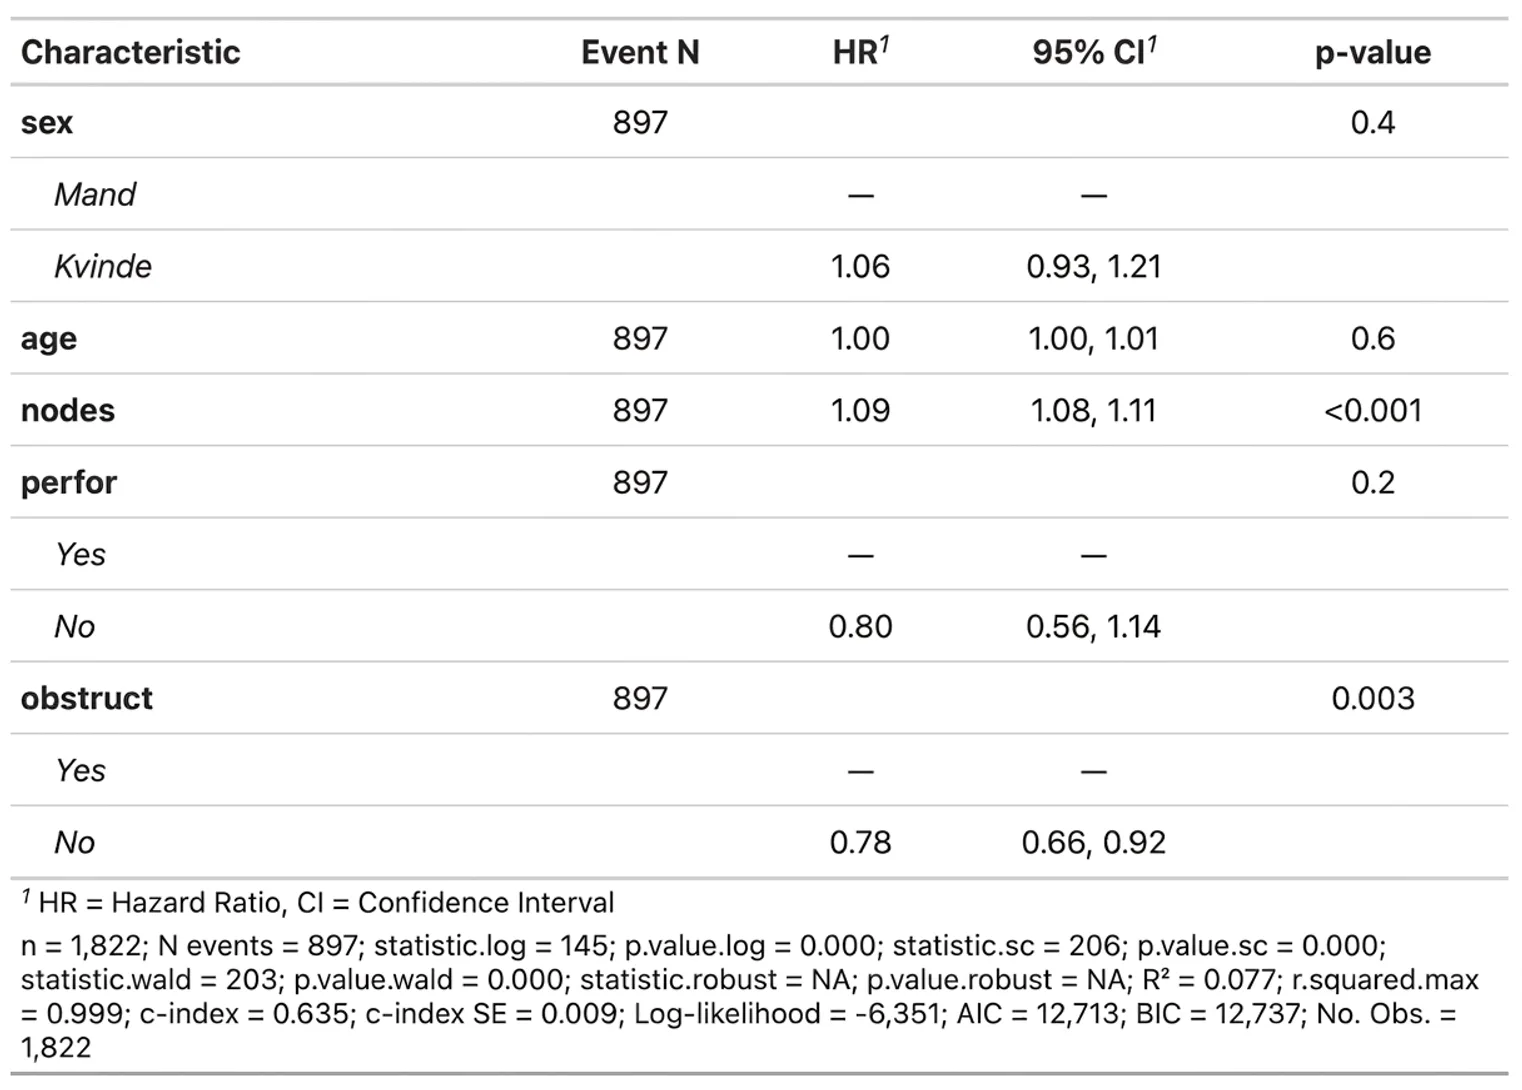
Fortolkning af Cox-regression
Ovenstående model har fem prædiktorer: sex, age, nodes, perfor og obstruct. Sex er en kategorisk prædiktor med niveauerne Man og Kvinna. Age og nodes er kontinuerte prædiktorer. Hazard ratio (HR) præsenteres sammen med et 95 % konfidensinterval (95 % CI). Hazard ratios ovenfor fortolkes som følger:
- For mænd er der ikke angivet nogen hazard ratio. Det skyldes, at mænd er referenceniveauet for variablen sex. Alle kategoriske variabler har et referenceniveau, som de øvrige niveauer sammenlignes med.
- Hazard ratio for kvinder er 1,06, hvilket betyder, at den relative risiko er 1,06 gange højere (dvs. 6 % højere) for kvinder sammenlignet med mænd. Konfidensintervallet er 0,93 til 1,21. Det betyder, at den sande risiko for kvinder med 95 % sandsynlighed ligger mellem 0,93 (hvilket betyder, at risikoen er 7 % lavere for kvinder sammenlignet med mænd) og 1,21 (hvilket betyder, at risikoen er 21 % højere for kvinder sammenlignet med mænd). Dette konfidensinterval indeholder altså tallet 1,0, hvilket betyder, at der er en sandsynlighed for både lavere og højere risiko for kvinder sammenlignet med mænd. Derfor er variablen sex ikke statistisk signifikant. Det fremgår også af p-værdien, som er 0,4.
- Af ovenstående følger, at hvis et konfidensinterval indeholder tallet 1,0, er prædiktoren ikke statistisk signifikant.
- Af ovenstående følger også, at en kategorisk prædiktor skal have et referenceniveau, som de øvrige niveauer sammenlignes med.
- For variablen age er hazard ratio 1,00, og konfidensintervallet indeholder også 1,00, hvilket gør, at variablen ikke er en statistisk signifikant prædiktor.
- For variablen nodes er hazard ratio 1,09, hvilket betyder, at hver gang nodes stiger med 1 enhed, øges risikoen for hændelsen (død) med 9 %. Konfidensintervallet er 1,08 til 1,11, hvilket betyder, at den sande værdi med 95 % sandsynlighed ligger mellem 8 % og 11 % øget risiko for hændelsen, hver gang nodes stiger med 1 enhed. P-værdien er <0,001, hvilket er tydeligt signifikant.
- For hver prædiktor i modellen er hazard ratio justeret for de øvrige variabler i modellen. Effekten af at øge nodes med 1 enhed er 1,09 (9 % øget risiko), justeret for de øvrige prædiktorer i modellen.
- Denne model indeholder altså også age og meal.cal ud over sex. Så er effekten af sex justeret for effekten af de øvrige prædiktorer i modellen (de øvrige prædiktorer "holdes konstante").
Konfidensintervallet i Cox-regression
Oftest bruges Walds konfidensinterval, som er en enkel beregning med standard error (SE):
Nedre grænse: HR – 1,96×SE
Øvre grænse: HR + 1,96×SE
Hvor HR er hazard ratio, og SE er standard error.
Mere om proportional hazards (PH)
Proportional hazard kan også forklares ved hjælp af interaktioner mellem en prædiktor og tid (opfølgningstid). Hvis en prædiktor opfylder kriteriet for proportional hazard, må der ikke være nogen statistisk signifikant interaktion mellem den prædiktor og opfølgningstiden (survival time). Man kan således danne et interaktionsled (prædiktor × opfølgningstid) og vurdere, om det er statistisk signifikant. Hvis interaktionen ikke er signifikant, betyder det, at prædiktoren udøver den samme effekt på hazard function ved alle værdier af t (opfølgningstid), og så er kriteriet for proportional hazard opfyldt. Hvis interaktionen derimod er signifikant, betyder det, at effekten af prædiktoren varierer over tid, og så strider den variabel mod antagelsen om proportional hazard. Der findes yderligere måder at vurdere proportional hazards på, og de er som følger:
- Vurdering af Schoenfeld-residualer
- Visualisering af log(-log S(t)) mod t
Egentlig bør man foretrække de to sidstnævnte metoder frem for interaktionsled. I R findes enkle funktioner, der præsenterer både Schoenfeld-residualer og grafer over log(-log S(t)) mod t.
For at vurdere antagelsen om PH kan følgende kode bruges:
library(survminer)

cox_ph <- cox.zph(min_modell)

ggcoxzph(cox_ph)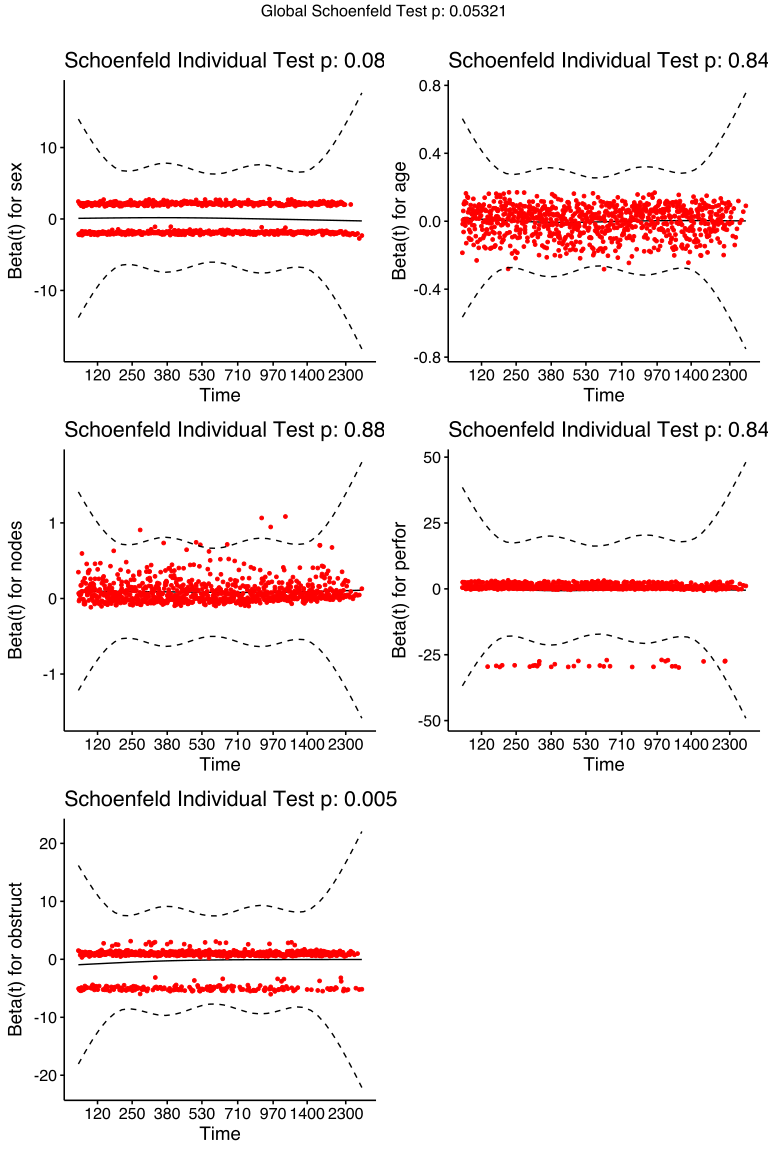
Ovenstående grafer viser, hvordan varierer over tid for hver enkelt prædiktor. Der må ikke være nogen hældning eller systematisk trend væk fra den vandrette linje. Hvis det er tilfældet, er effekten af konstant over tid, og antagelsen om proportional hazard er opfyldt.
Hvis en variabel strider mod antagelsen om PH, kan det afhjælpes på en af følgende måder:
- Inkludér en interaktion mellem variablen og tid i modellen.
- Stratificér på den variabel, der strider mod PH. Ulempen ved dette er, at man ikke får en hazard ratio for en variabel, der bruges til at stratificere. Det er dog kun et problem, hvis man er interesseret i hazard ratio for netop den variabel.
Stratificeret Cox-regression
Cox-regressionen giver mulighed for at justere for variabler, som ikke indgår i modellen, og det gøres ved at stratificere. Man må ikke forveksle stratificering ved Cox-regression med stratificering ved almindelig lineær (multipel) regression.
Ved almindelig lineær (multipel) regression betyder stratificering, at man laver separate modeller ud fra en kategorisk variabel. Antag, at vi studerer, hvordan alder påvirker blodtrykket, og at vi også har oplysninger om vægt. Hvis vi vil vide, hvordan alder påvirker blodtrykket i forskellige vægtkategorier, kan vi stratificere analysen ved at lave én regression for normalvægtige, én regression for overvægtige og én regression for personer med svær overvægt. Det er altså tre separate modeller, som giver separate koefficienter for alder.
Ved Cox-regression kan stratificeringen håndteres anderledes. Cox-regression tillader os at stratificere data (observationerne) ud fra en kategorisk variabel. Baseline hazard får lov at variere mellem disse strata. Modellen kan derefter estimere en samlet (kumulativ) effekt af alder i alle strata. Så får vi kun én koefficient for alder i stedet for separate koefficienter i hvert stratum. Man kan sige, at effekten af alder "pooles" (vægtes sammen) på tværs af alle strata.
Der er flere situationer, hvor det er klogt at stratificere modellen. Hvis en variabel strider mod antagelsen om proportional hazard, kan man kategorisere variablen i to eller flere passende niveauer og stratificere modellen på den variabel. Så har man justeret for variablen, og man behøver ikke bekymre sig om, at den strider mod proportional hazards. Ulempen er, at man ikke får nogen regressionskoefficienter for variablen (men hvis den alligevel ikke er af interesse for analysen, er dette ikke nogen større ulempe.
Med følgende kode stratificeres Cox-regressionen på køn (sex):
min_modell <- coxph(Surv(time, status==1) ~ strata(sex) + age + nodes + perfor + obstruct, data=colon)Vi udskriver resultatet med funktionen tbl_regression() som følger:
min_modell|>
  tbl_regression(exponentiate = TRUE) |>
  add_global_p() |>
  bold_labels() |>
  italicize_levels() |>
  add_nevent() |>
  add_glance_source_note()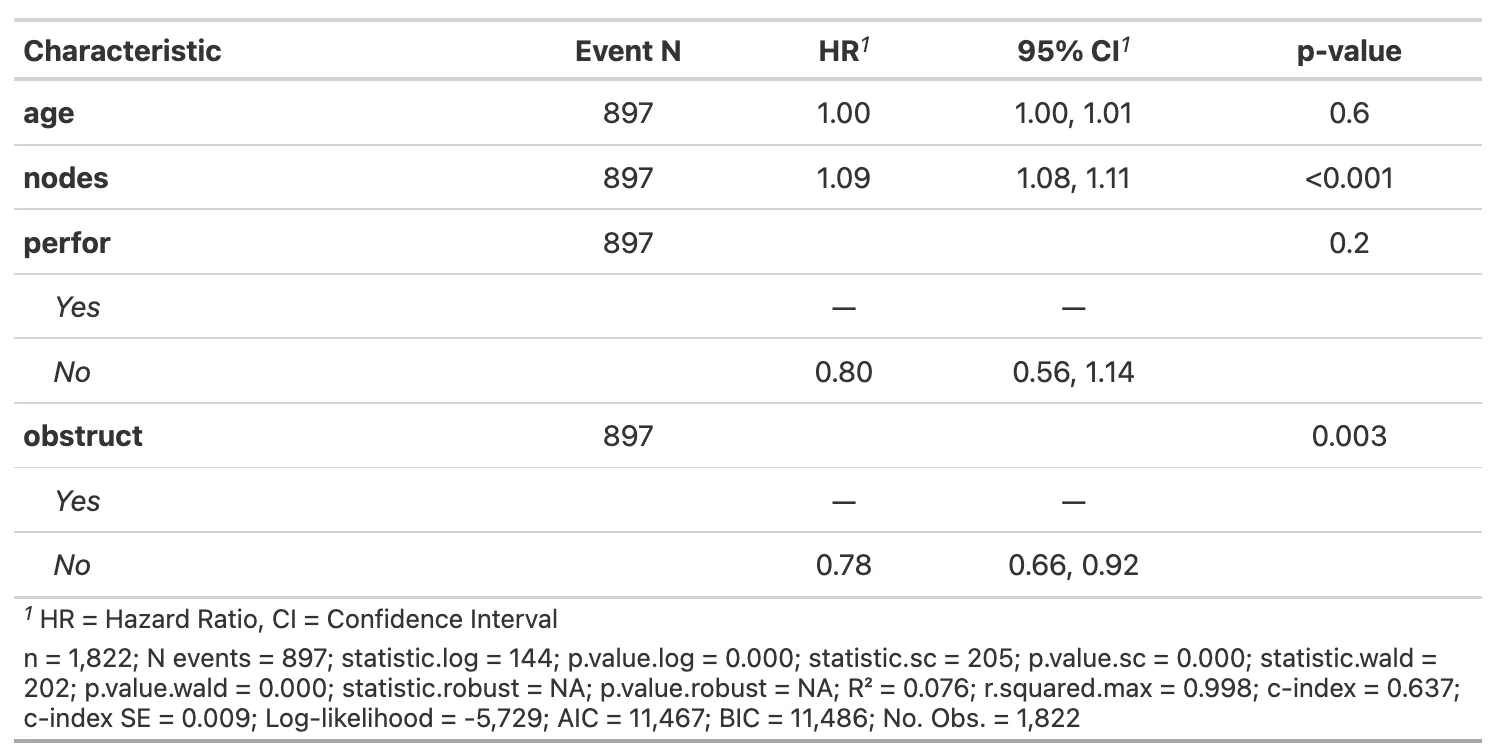
Som det fremgår af ovenstående, har stratificeringen ikke påvirket hazard ratioerne for de øvrige prædiktorer i modellen.
Referencer
Germán Rodríguez, Survival Models, Princeton university.
Cox DR and Oakes D (1984). Analysis of Survival Data. Chapman and Hall, New York.
Kalbfleisch JD and Prentice RL (2002). The Statistical Analysis of Failure Time Data. Second Edition. Wiley, New York.
Klein and Moeschberger (1997). Survival Analysis: Techniques for Censored and Truncated Data. Springer-Verlag, New York.
Lagakos SW (1979). General right censoring and its impact on the analysis of survival data, Biometrics 35:139-156.
Lawless JF (2003). Statistical Models and Methods for Lifetime Data. Wiley, New York.
Clark, T., Bradburn, M., Love, S., & Altman, D. (2003). Survival analysis part I: Basic concepts and first analyses. 232-238. ISSN 0007-0920.
M J Bradburn, T G Clark, S B Love, & D G Altman. (2003). Survival Analysis Part II: Multivariate data analysis – an introduction to concepts and methods. British Journal of Cancer, 89(3), 431-436.
Bradburn, M., Clark, T., Love, S., & Altman, D. (2003). Survival analysis Part III: Multivariate data analysis – choosing a model and assessing its adequacy and fit. 89(4), 605-11.
Clark, T., Bradburn, M., Love, S., & Altman, D. (2003). Survival analysis part IV: Further concepts and methods in survival analysis. 781-786. ISSN 0007-0920.