
Overlevelsesfunktion (survival function) og hazard function
Det foregående kapitel (Overlevelsesanalyse) er en forudsætning for at forstå dette kapitel.
Overlevelse (survival time) er en kontinuert variabel, som kan beskrives med to enkle funktioner:
- : Overlevelsesfunktionen (survival function) er sandsynligheden for, at en person er i live efter tidspunkt t.
- : Hazardfunktionen (hazard function) beskriver den øjeblikkelige risiko for, at hændelsen (event) indtræffer ved tidspunkt t, forudsat at personen har overlevet frem til tidspunkt t.
Alle kontinuerte variabler (inklusive survival time) kan beskrives med en kumulativ fordelingsfunktion (cumulative distribution function, CDF). Disse funktioner er sandsynlighedsfordelinger, som defineres således:
Funktionen beskriver sandsynligheden for, at er mindre end eller lig med . Overlevelsestid, , har også en kumulativ fordelingsfunktion:
Denne funktion beskriver sandsynligheden for, at eventet indtræffer på eller før tidspunkt , men ikke senere end . Vores mål er dog at estimere , som er sandsynligheden for, at individet har overlevet tidspunkt (dvs. ikke har fået hændelsen ved tidspunkt ). er altså sandsynligheden for at overleve tidspunkt :
har en trappetrinslignende form, hvilket fremgår af nedenstående graf (Kaplan-Meier-kurve). Grafen beskriver, hvordan sandsynligheden for overlevelse falder over tid. Plustegnene (+) på grafen angiver tidspunkter, hvor personer er blevet censureret. påvirkes ikke af censureringer. falder kun, når et eller flere individer får eventet.
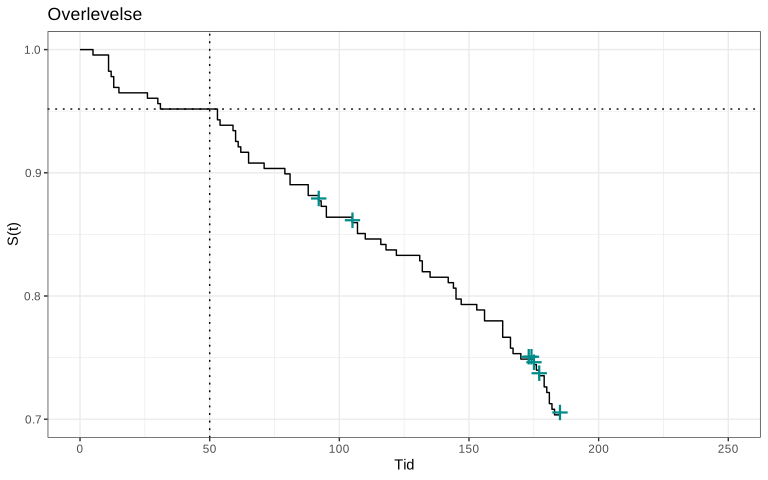
I ovenstående graf er værdien af 0,952 ved , hvilket betyder, at sandsynligheden for at overleve mindst 50 dage er 95,2 %, og at 4,8 % har fået hændelsen ved . Medianoverlevelsen er det tidspunkt, hvor 50 % af populationen har fået eventet, dvs. .
Kaplan-Meier-estimator (Product Limit Estimator)
Det er altid vigtigt at visualisere overlevelsen med en graf, fordi den viser, hvordan overlevelsesforløbet udvikler sig over tid. Den mest almindelige metode til at præsentere er ved hjælp af Kaplan-Meier-estimatoren (Kaplan-Meier-kurve, Product Limit Estimator), som er demonstreret i figuren ovenfor.
For at lave en Kaplan-Meier-kurve skal survival time (opfølgningstiden) opdeles i intervaller. Hvert interval begynder, når et event indtræffer. Alle tidspunkter, hvor hændelser indtræffer (event times), rangordnes fra første til sidste event. Ved indtræffer den første hændelse, ved indtræffer den anden hændelse, ved indtræffer den tredje hændelse og så videre. Studiet begynder ved , og her er der endnu ikke indtruffet nogen hændelse. Ved er , hvilket betyder, at sandsynligheden for overlevelse er 100 %.
For at beregne ved foretages følgende beregning:
= antal patienter observeret i begyndelsen af
= antal events ved
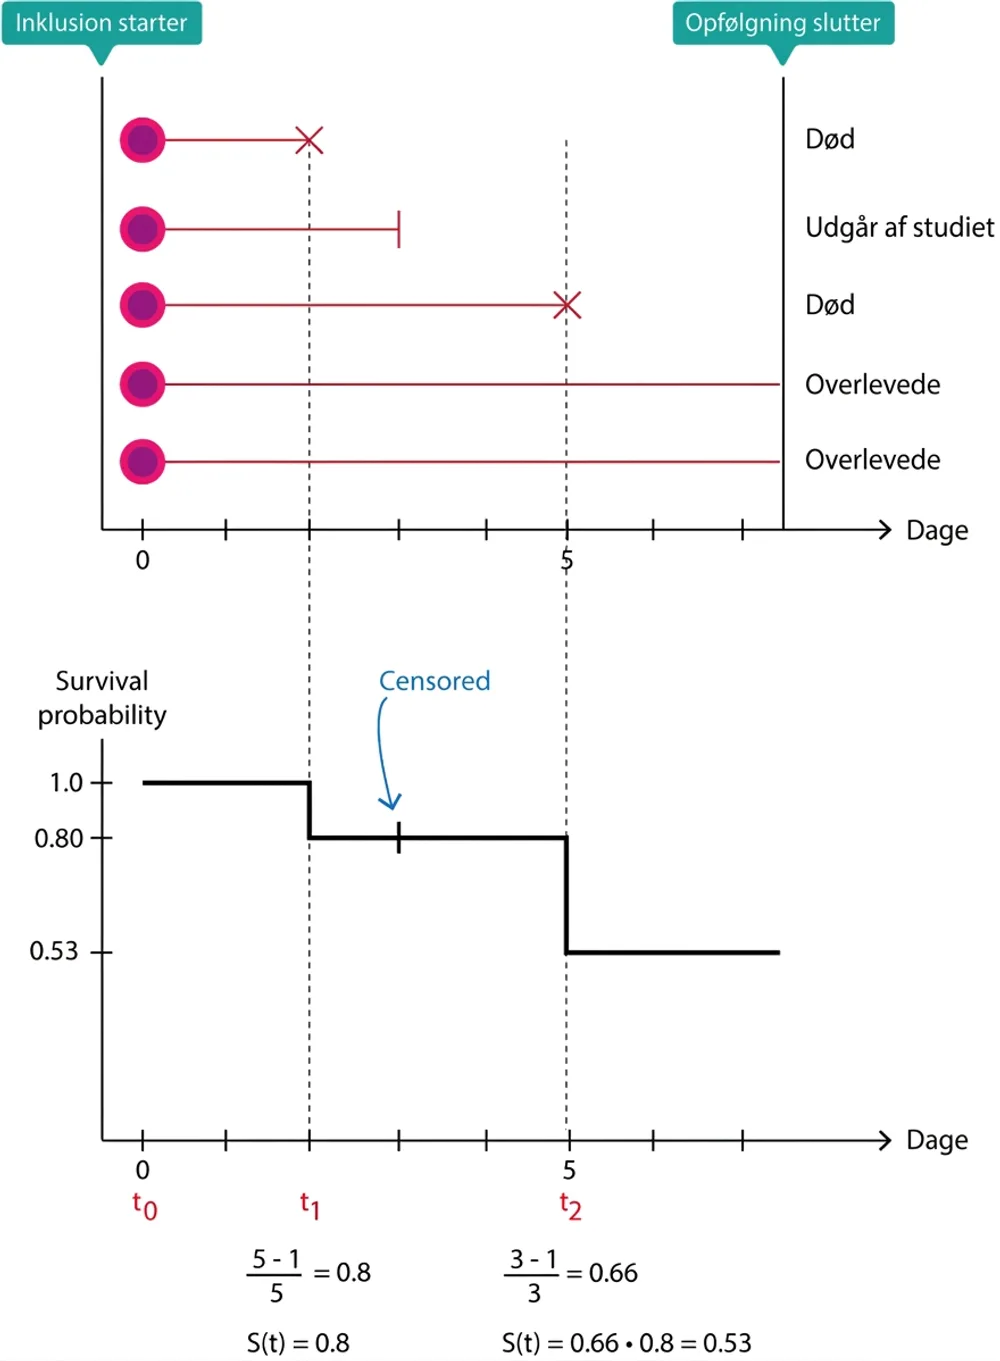
Dette er andelen af patienter, der overlever efter , blandt de patienter, der overlevede frem til . For at beregne sandsynligheden for at overleve efter , forudsat at man klarer sig frem til da, foretages beregningen i to trin:
er produktet af sandsynligheden for at overleve frem til , hvilket bliver:
Dette er illustreret i nedenstående figur.
| Tidspunkt (x) | Antal i risiko | Antal events | Antal censurerede | Overlevelse (y) |
|---|---|---|---|---|
| 0 | 228 | 0 | 0 | 1.00000000 |
| 5 | 228 | 1 | 0 | 0.99561404 |
| 11 | 227 | 3 | 0 | 0.98245614 |
| 12 | 224 | 1 | 0 | 0.97807018 |
| 13 | 223 | 2 | 0 | 0.96929825 |
| 15 | 221 | 1 | 0 | 0.96491228 |
| 26 | 220 | 1 | 0 | 0.96052632 |
| 30 | 219 | 1 | 0 | 0.95614035 |
| 31 | 218 | 1 | 0 | 0.95175439 |
| 53 | 217 | 2 | 0 | 0.94298246 |
| 54 | 215 | 1 | 0 | 0.93859649 |
| 59 | 214 | 1 | 0 | 0.93421053 |
| 60 | 213 | 2 | 0 | 0.92543860 |
| 61 | 211 | 1 | 0 | 0.92105263 |
| 62 | 210 | 1 | 0 | 0.91666667 |
| 65 | 209 | 2 | 0 | 0.90789474 |
| 71 | 207 | 1 | 0 | 0.90350877 |
Survival probability er på Kaplan-Meier-kurven. Dette er således andelen, der stadig er i live ved hvert tidspunkt. Kurven går gradvist nedad, efterhånden som personer får eventet. Kaplan-Meier-kurven når kun , hvis alle deltagere får eventet. Medianoverlevelsen er ganske enkelt andelen, der lever ved .
Hypotesetest og overlevelsesanalyse: log-rank test
Test af forskel mellem overlevelseskurver
I den følgende figur sammenlignes overlevelsen mellem mænd og kvinder.
21.7.1 R-kode til ovenstående Kaplan-Meier-kurve
install.packages("survival")
library(survival)
install.packages("survminer")
library(survminer)

## Indlæs eksempeldata
data(colon)

## Inspicér de første 10 rækker
head(colon, 10)
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1
7 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 293 2
8 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 245 1
9 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 659 2
10 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 523 1Overlevelsesfunktionen genereres med funktionerne survfit() og Surv(). I Surv() er det første argument overlevelsestid (time), og det andet argument er event-variablen. For event-variablen kan vi angive, hvilket niveau der indikerer, at hændelsen er indtruffet. Det gør vi nedenfor ved at angive status==1. Med argumentet pval = TRUE beder vi om hypotesetest med log-rank test. Denne test beregner sandsynligheden for, at nulhypotesen ( er korrekt (nulhypotesen postulerer, at der ikke er nogen forskel i overlevelse. Hvis p-værdien, der genereres med log-rank test, er < 0,05, forkastes . I dette tilfælde sammenlignes mænd med kvinder ved at inkludere variablen sex som stratum:
## Opret survfit-objekt. I dette objekt oprettes overlevelsesfunktionen
fit <- survfit(Surv(time, status==1) ~ sex, data = lung)

## Tegn Kaplan-Meier-kurve
ggsurvplot(fit, data = lung, risk.table = TRUE, pval = TRUE)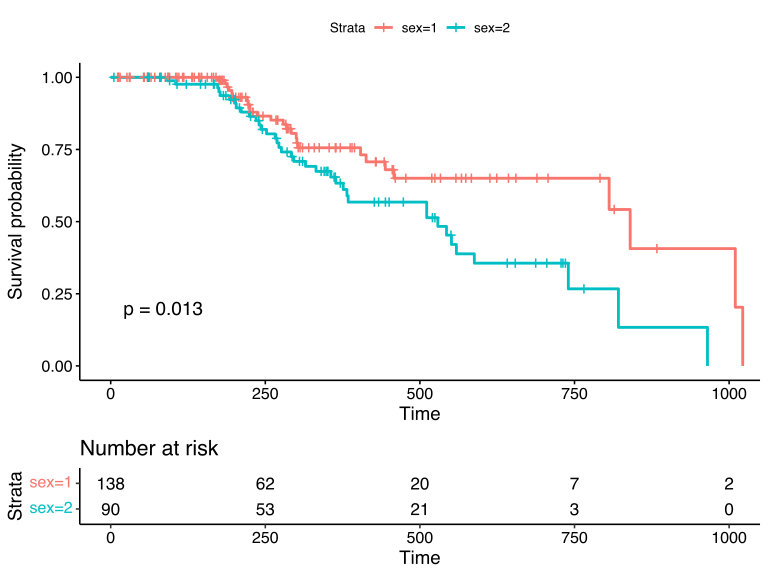
Som det fremgår ovenfor, er kurverne adskilte, hvilket betyder, at overlevelsen er forskellig for mænd (sex=2) og kvinder (sex=1). Ved hvert tidspunkt er højere for kvinder. Det betyder, at overlevelsen er bedre for kvinder, og det kan altså vurderes visuelt. P-værdien er 0,013, hvilket også indikerer, at forskellen er statistisk signifikant. P-værdien er beregnet med log-rank test.
Princippet for log-rank test følger princippet for hypotesetest. Man tager udgangspunkt i nulhypotesen (), som postulerer, at der ikke er nogen forskel mellem grupperne, og derefter beregnes en sandsynlighed (p-værdi) for, at nulhypotesen er korrekt. Hvis sandsynligheden er <0,05, forkastes nulhypotesen. Log-rank test kan bruges til at sammenligne to eller flere overlevelseskurver.
Kaplan-Meier-kurven kan således bruges til at studere overlevelse. Dette kan gøres i hele populationen eller i undergrupper (f.eks. mænd og kvinder). Man kan dog ikke justere for kovariater i en Kaplan-Meier-beregning; dette kræver regressionsanalyse, hvoraf den mest almindelige metode er Cox-regression, som diskuteres i næste kapitel.