
Mål for prædiktiv evne
eng. performance metrics, evaluation metrics
I flere af de foregående kapitler er betegnelsen precision jævnligt blevet brugt om modellers prædiktionsevne. Det er egentlig ukorrekt, eftersom precision er et specifikt mål for prædiktionsevne. Der findes en lang række mål, som beskriver forskellige nuancer af prædiktionsevne. Disse mål bruges til at evaluere og sammenligne modeller (eksempelvis under krydsvalidering). Hvilket mål der er optimalt, afhænger af problemstillingen og situationen.
Ud fra dette perspektiv findes der tre typer modeller:
- Klassifikationsmodeller (klassifikation).
- Regressionsmodeller (regression).
- Overlevelsesmodeller (overlevelsesanalyse).
I denne sammenhæng henviser regression ikke til den klassiske lineære regressionsmodel, men til alle modeller, der prædikterer kontinuerte udfald (uanset om det sker med klassiske regressionsmodeller, machine learning, deep learning eller en anden metode). Med regression menes her en model med et kontinuert udfaldsmål.
Klassifikation henviser til alle modeller, uanset type, som prædikterer et kategorisk udfaldsmål. I de fleste tilfælde er udfaldet binært (ja/nej, syg/rask, død/levende, etc), men det kan også være multinomialt (>2 kategorier).
Den tredje type model er overlevelsesanalyse, hvor udfaldet er tid til en hændelse indtræffer. Overlevelsesanalyse indtager en særstilling, fordi udfaldet er kontinuert (tid), men som regel oplever/rammes ikke alle deltagere af den hændelse, der undersøges. De, der ikke rammes af/oplever hændelsen i løbet af studiets observationstid, bliver censurerede. Det betyder, at modellen ikke er en almindelig klassifikationsmodel, og derfor kræves der særlige mål for prædiktionsevne.
Klassifikation
Konfusionsmatrix (Confusion matrix)
Konfusionsmatricen er fundamental ved vurdering af klassifikationsmodeller. Denne enkle krydstabel indeholder flere vigtige mål. Nedenstående krydstabel viser en konfusionsmatrix. Matricen aflæses som følger:
- True positive (TP): Både modellen og virkeligheden viser positivt udfald.
- True negative (TN): Både modellen og virkeligheden viser negativt udfald.
- False positive (FP): Modellen prædikterer positivt udfald, men i virkeligheden var udfaldet negativt.
- etc.
| Prædikteret positiv (PP) | Prædikteret negativ (PN) | |
|---|---|---|
| Faktisk positiv (P) | True positive (TP) | False negative (FN) |
| Faktisk negativ (N) | False positive (FP) | True negative (TN) |
Confusion matrix (konfusionsmatrix).
Ud fra en konfusionsmatrix kan følgende parametre beregnes:
- Accuracy: Andelen af positive, der klassificeres som positive.
- Sensitivitet:
- Formel:
- Betydning: Andel af positive, der klassificeres som positive.
- Synonym: Recall, True Positive Rate, Hit Rate.
- Specificitet:
- Formel:
- Betydning: Andel af negative, der klassificeres som negative.
- Synonym: True Negative Rate
- Positive Predictive Value (PPV):
- Formel:
- Betydning: Sandsynlighed for positivt udfald, hvis prædikteret som positivt.
- Synonym: Precision
- Negative Predictive Value (NPV):
- Formel:
- Betydning: Sandsynlighed for negativt udfald, hvis prædikteret som negativt.
- F-score:
- Formel:
ROC og AUC-ROC
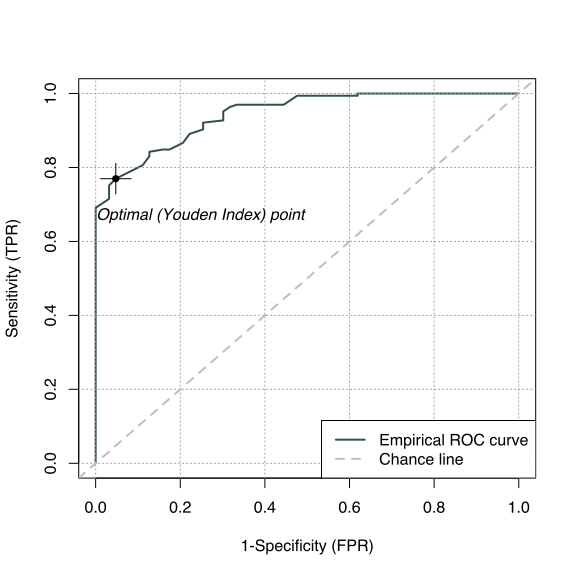
En ROC-kurve er en grafisk fremstilling af prædiktionsevnen for en klassifikationsmodel med binært udfald. Den illustrerer, hvordan prædiktionsevnen ændrer sig, når beslutningstærsklen justeres. Beslutningstærsklen er den grænseværdi (for sandsynlighed), hvor et tilfælde klassificeres som positivt. Hvis modellen prædikterer, at sandsynligheden for positivt udfald er højere end beslutningstærsklen, prædikterer den positivt udfald. Hvis beslutningstærsklen sættes til 50% sandsynlighed, og et tilfælde prædikteres at have 49% sandsynlighed for positivt udfald, vil modellen prædiktere negativt udfald. Hvis tilfældet derimod prædikteres at have 51% sandsynlighed for positivt udfald, vil modellen prædiktere positivt udfald. Hvis beslutningstærsklen sænkes fra 50% til 10%, vil mange flere blive klassificeret som positive; sensitiviteten stiger, men specificiteten falder. ROC-kurven dannes ved at plotte sensitivitet mod FPR (false positive rate, hvilket er det samme som 1-specificitet) ved alle værdier af beslutningstærsklen. Et eksempel på en ROC-kurve følger.
Arealet under ROC-kurven (AUC-ROC)
Bemærk den stiplede diagonale linje på ovenstående ROC-kurve. Arealet under den stiplede linje er 0,5 (arealet er uden enhed). En ROC-kurve, der falder på den diagonale linje, har ingen prædiktiv evne. Modellens prædiktionsevne svarer da til tilfældigheden. En model, hvis ROC-kurve ligger over linjen, er bedre end tilfældigheden. Arealet under ROC-kurven kan altså opsummere, hvor god modellen er. ROC-kurver nær 1 ses yderst sjældent; eksempler på analyser med AUC-ROC nær 1,0 er PCR-analyser for virus. Kliniske prædiktionsmodeller har som regel AUC-ROC mellem 0,6 og 0,9. Modeller inden for finans, psykologi og andre domæner har lignende ROC-resultater.
Concordance index (C-indeks)
C-indeks er en generalisering af ROC-kurven. C-indeks tager højde for censurering, hvilket er et krav for at kunne anvendes i overlevelsesanalyse. C-indeks er modellens globale evne til at prædiktere overlevelsestid.
Formlen for C-indeks:
\begin{equation} \text{C-index} = \frac{ \sum_{i, j} \mathbb{1}_{T_j < T_i} \cdot \mathbb{1}_{\eta_j > \eta_i} \cdot \delta_j }{\sum_{i, j} \mathbb{1}_{T_j < T_i}\cdot \delta_j } \end{equation}
Cox-regression og andre modeller, der bruger Cox loss-funktion, evalueres med C-indeks.
C-indeks fortolkes analogt med ROC. Det betyder, at et C-indeks på 1,0 indebærer, at modellen er perfekt. Et C-indeks på 0,5 betyder, at modellen ikke er bedre end tilfældigheden.
Uddybning: Uno et al.
Brier score
Brier score bruges til at evaluere en overlevelsesmodels prædiktionsevne ved tid . Det betyder, at Brier score fortæller, hvad modellens evne er på et givet tidspunkt. Brier score varierer mellem 0 og 1. Brier score er den gennemsnitlige kvadrerede afstand mellem observeret overlevelse og faktisk overlevelse; 0 betyder, at modellen er optimal, eftersom der ikke er nogen forskel mellem prædiktionen og det observerede.
Integreret Brier score
Integreret Brier score giver et samlet mål for Brier score over alle værdier af overlevelsestid (survival time).
Regression
Følgende mål bruges til at evaluere modeller med kontinuerte udfaldsmål. Error, som indgår i flere af disse mål, er forskellen mellem den faktiske værdi og den prædikterede værdi af .
R2
R2 er den varians, der forklares af modellen. Dette mål er meget populært til vurdering af modeller med kontinuerte udfaldsmål. R2 antager en værdi mellem 0 og 1, hvor 0 betyder, at modellen ikke forklarer nogen varians (dvs. modellen har ingen forklaringskapacitet), og 1 betyder, at modellen forklarer al varians.
\begin{equation} {R}^{2} = 1 - \frac { \sum_{i=1}^{n} (\ y_i -\hat{y_i} )^{2} } { \sum_{i=1}^{n} (\ y_i -\bar{y_i} )^{2} } \end{equation}
MAE (Mean Absolute Error)
MAE er gennemsnittet af den absolutte målefejl. Errors kvadreres ikke, hvilket gør målet mindre følsomt over for enkelte outliers (store værdier).
\begin{equation} MAE = \frac{1}{n} \sum_{i=1}^{n} |{y_i}-\hat{y_i}| \end{equation}
MAPE (Mean Absolute Percent Error)
MAPE er MAE udtrykt i procent, hvilket er et mål, som mennesker har let ved at forstå. Ulempen ved MAPE er, at hvis error = 0, kan MAPE ikke beregnes, eftersom en division (for at beregne procent) med 0 giver et uendeligt tal. Desuden har MAPE en tendens til at foretrække modeller, der prædikterer lavere værdier af Y end de faktiske værdier.
\begin{equation} MAPE = \frac{1}{n} \sum_{i=1}^{n} {\left|\frac{{y_i}-\hat{y_i}}{y_i}\right|} \end{equation}
RMSE (Root Mean Squared Error)
RMSE er kvadratroden af middelværdien af de kvadrerede errors. RMSE fortæller, hvor langt prædiktionerne ligger fra den faktiske værdi, i samme enhed som Y. Eftersom error kvadreres, har enkelte outliers (store værdier) større indflydelse på RMSE end på MAE og MAPE.
\begin{equation} RMSE = \sqrt{\frac{1}{n} \sum_{i=1}^{n} ({y_i}-\hat{y_i}){^2}}\end{equation}